כדי שמודל AI יהיה שימושי בהקשרים ספציפיים, הוא לרוב זקוק לגישה לידע רקע. לדוגמה, צ'אטבוטים של תמיכת לקוחות צריכים ידע על העסק הספציפי שבו הם משמשים, ובוטים של אנליסטים משפטיים זקוקים לידע על מגוון רחב של תיקים קודמים.
מפתחים נוהגים לשפר את הידע של מודל AI באמצעות RAG (Retrieval-Augmented Generation). RAG היא שיטה השולפת מידע רלוונטי מבסיס ידע ומצרפת אותו לפרומפט של המשתמש, ובכך משפרת משמעותית את תגובת המודל. הבעיה היא שפתרונות RAG מסורתיים מסירים הקשר בעת קידוד המידע, מה שלעיתים קרובות מוביל לכך שהמערכת אינה מצליחה לשלוף את המידע הרלוונטי מבסיס הידע.
בפוסט זה, אנו מציגים שיטה המשפרת באופן דרמטי את שלב השליפה ב-RAG. השיטה נקראת "שליפה קונטקסטואלית" (Contextual Retrieval) ומשתמשת בשתי תתי-טכניקות: Contextual Embeddings ו-Contextual BM25. שיטה זו יכולה להפחית את מספר כשלי השליפה ב-49%, ובשילוב עם reranking, ב-67%. אלו מהווים שיפורים משמעותיים בדיוק השליפה, המתורגמים ישירות לביצועים טובים יותר במשימות עוקבות.
תוכלו לפרוס בקלות פתרון שליפה קונטקסטואלית משלכם עם Claude באמצעות ה-cookbook שלנו.
הערה על שימוש בפרומפט ארוך יותר
לעיתים, הפתרון הפשוט ביותר הוא הטוב ביותר. אם בסיס הידע שלכם קטן מ-200,000 טוקנים (כ-500 עמודים של חומר), תוכלו פשוט לכלול את כל בסיס הידע בפרומפט שאתם מעבירים למודל, ללא צורך ב-RAG או בשיטות דומות.
לפני מספר שבועות, השקנו את Prompt Caching עבור Claude, מה שהופך גישה זו למהירה וחסכונית יותר באופן משמעותי. מפתחים יכולים כעת לשמור פרומפטים בשימוש תכוף במטמון בין קריאות ל-API, ובכך להפחית את זמן השהיה (latency) ביותר מפי 2 ואת העלויות בעד 90% (תוכלו לראות איך זה עובד בקריאת ה-cookbook שלנו ל-Prompt Caching).
עם זאת, ככל שבסיס הידע שלכם גדל, תזדקקו לפתרון שניתן להרחיב. כאן נכנסת לתמונה השליפה הקונטקסטואלית.
מבוא קצר ל-RAG: סקיילינג לבסיסי ידע גדולים יותר
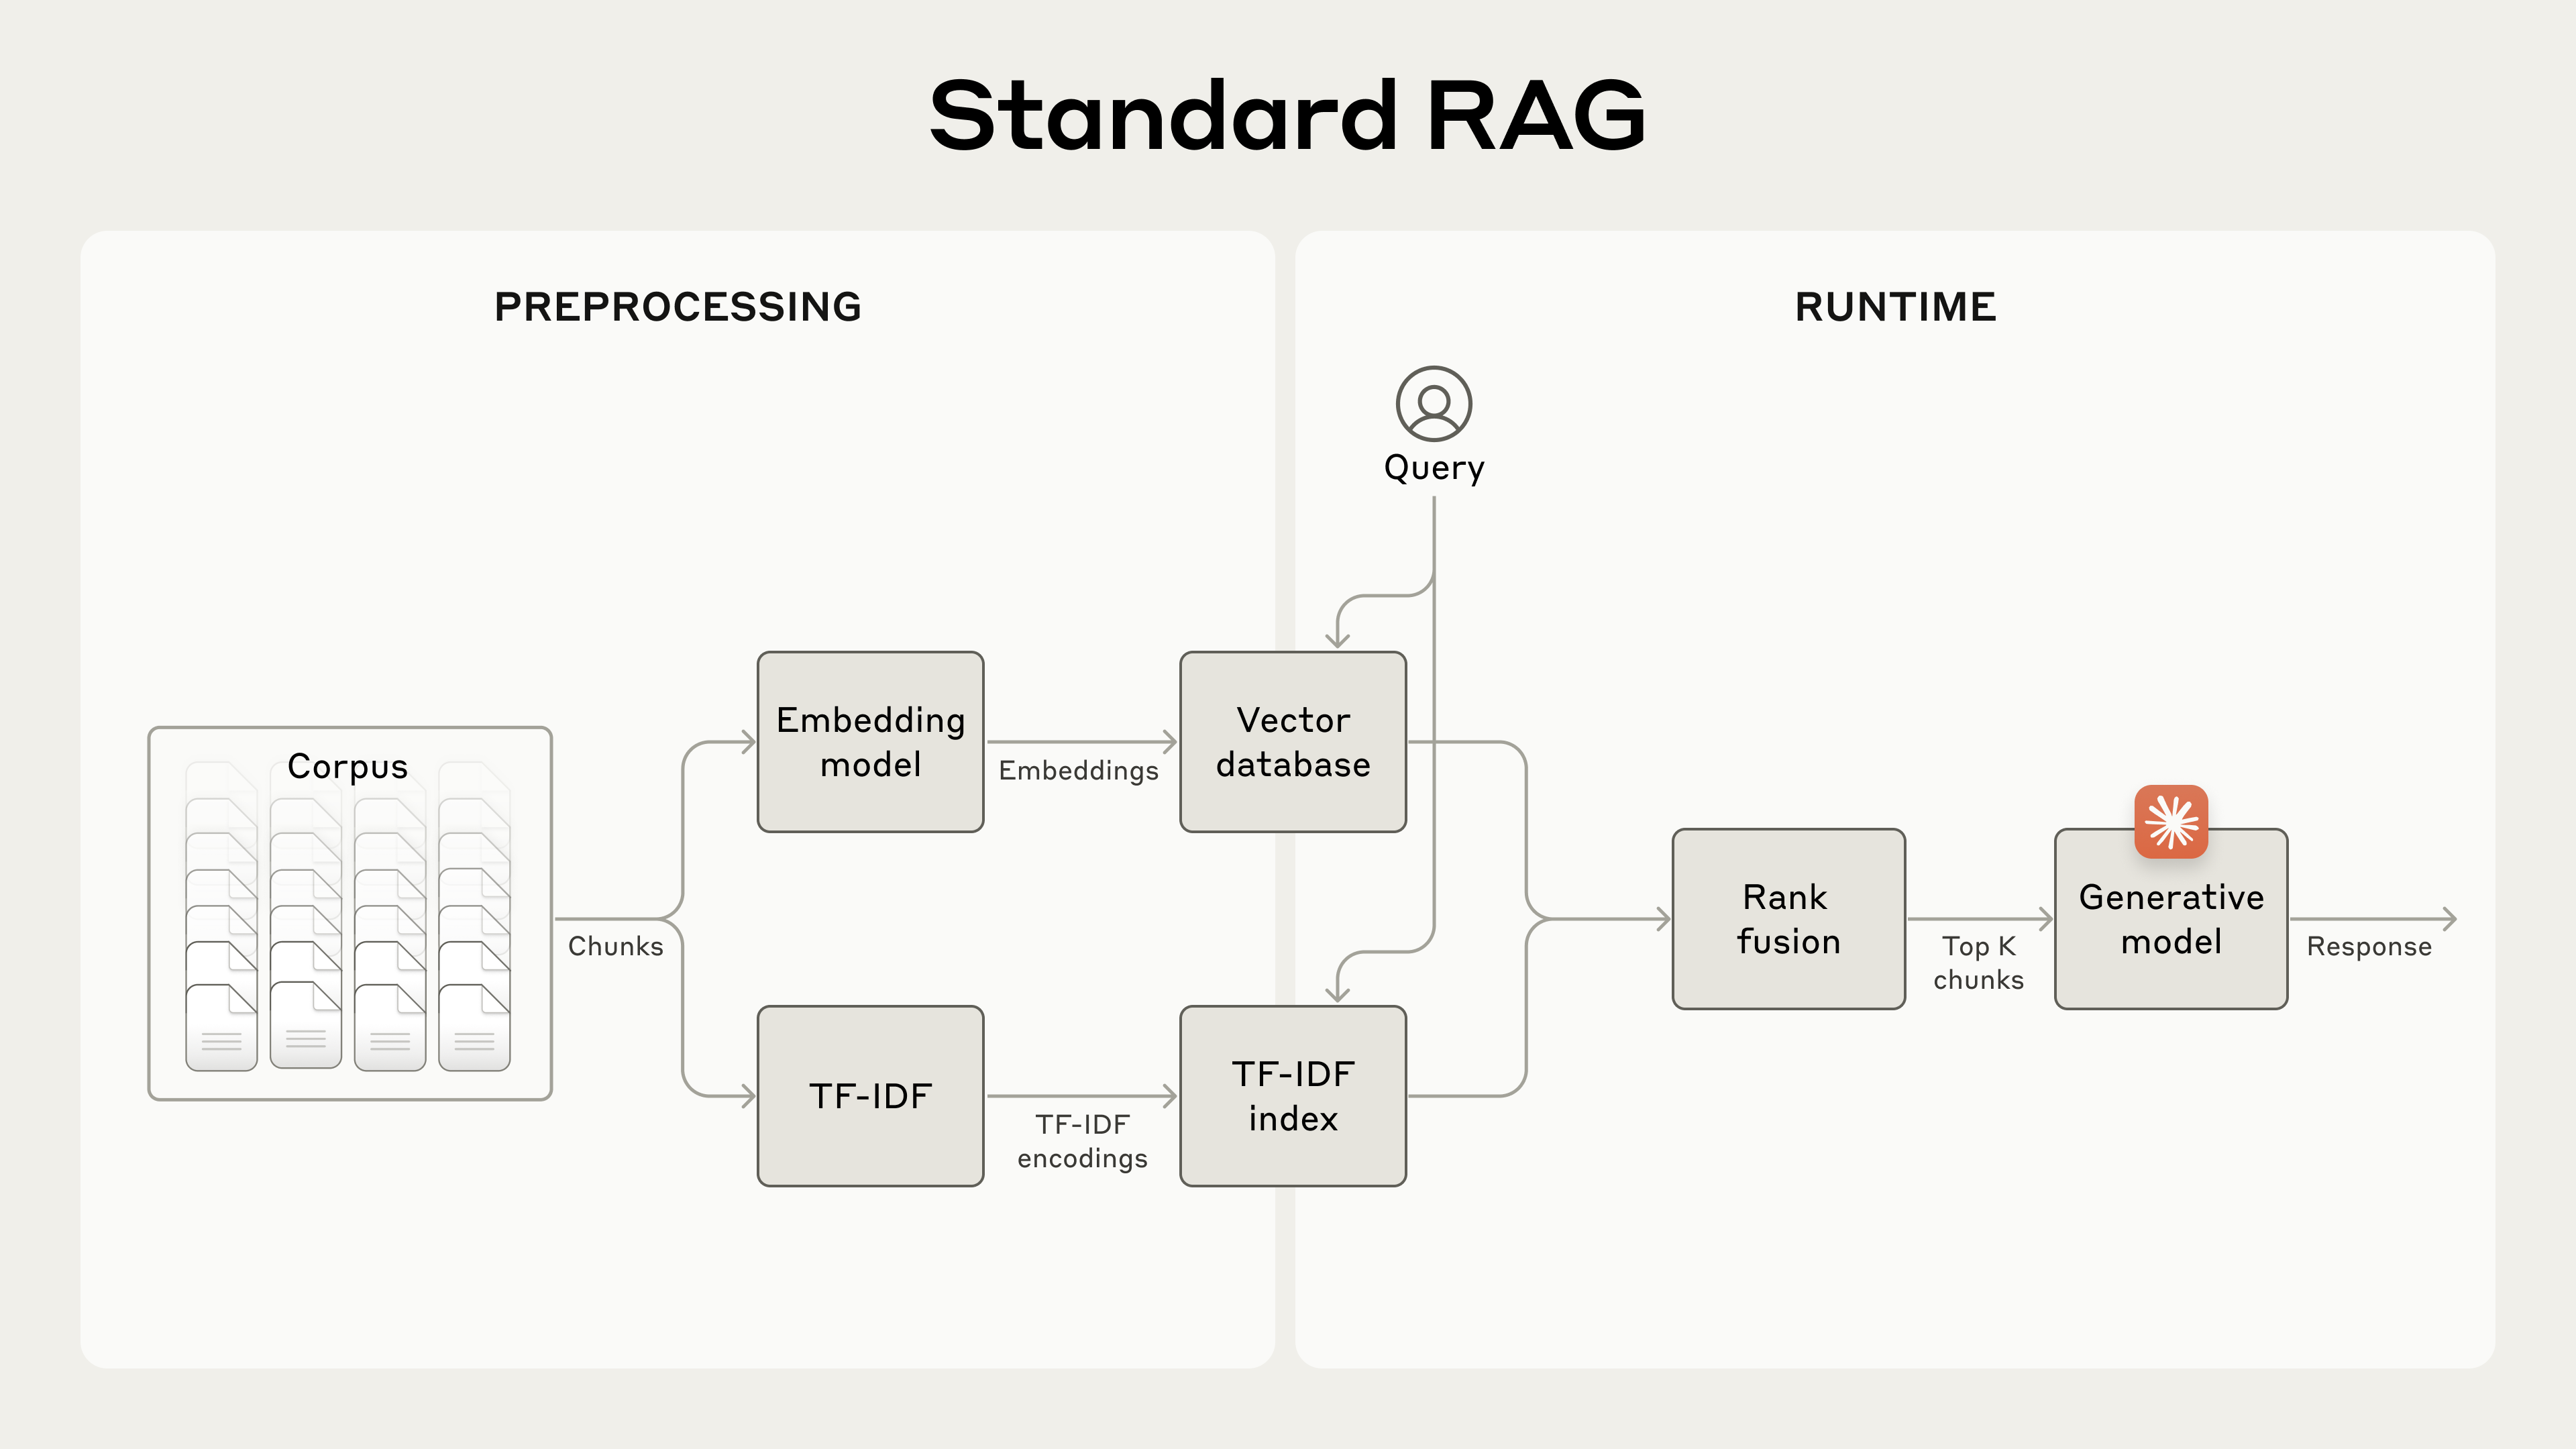
עבור בסיסי ידע גדולים שאינם נכנסים לחלון ההקשר, RAG הוא הפתרון המקובל. RAG פועל באמצעות עיבוד מוקדם של בסיס ידע באמצעות השלבים הבאים:
- לפרק את בסיס הידע ("קורפוס" המסמכים) לחלקי טקסט קטנים יותר, בדרך כלל לא יותר מכמה מאות טוקנים;
- להשתמש במודל embedding כדי להמיר את החלקיקים הללו ל-embedding וקטוריים המקודדים משמעות;
- לאחסן את ה-embeddings הללו במסד נתונים וקטורי המאפשר חיפוש לפי דמיון סמנטי.
בזמן ריצה, כאשר משתמש מזין שאילתה למודל, מסד הנתונים הווקטורי משמש למציאת החלקיקים הרלוונטיים ביותר בהתבסס על דמיון סמנטי לשאילתה. לאחר מכן, החלקיקים הרלוונטיים ביותר מתווספים לפרומפט הנשלח למודל הגנרטיבי.
בעוד שמודלי embedding מצטיינים בלכידת קשרים סמנטיים, הם עלולים להחמיץ התאמות מדויקות וקריטיות. למרבה המזל, קיימת טכניקה ותיקה יותר שיכולה לסייע במצבים אלו. BM25 (Best Matching 25) היא פונקציית דירוג המשתמשת בהתאמה לקסיקלית כדי למצוא התאמות מדויקות של מילים או ביטויים. היא יעילה במיוחד עבור שאילתות הכוללות מזהים ייחודיים או מונחים טכניים.
BM25 פועלת על בסיס הרעיון של TF-IDF (Term Frequency-Inverse Document Frequency). TF-IDF מודדת את חשיבותה של מילה למסמך באוסף. BM25 מחדדת זאת על ידי התחשבות באורך המסמך ויישום פונקציית רוויה לתדירות המונחים, מה שמסייע למנוע ממילים נפוצות לשלוט בתוצאות.
הנה כיצד BM25 יכולה להצליח היכן ש-embeddings סמנטיים נכשלים: נניח שמשתמש שואל "קוד שגיאה TS-999" במסד נתונים של תמיכה טכנית. מודל embedding עשוי למצוא תוכן על קודי שגיאה באופן כללי, אך עלול להחמיץ את ההתאמה המדויקת ל-"TS-999". BM25 מחפשת מחרוזת טקסט ספציפית זו כדי לזהות את התיעוד הרלוונטי.
פתרונות RAG יכולים לשלוף במדויק יותר את החלקיקים הרלוונטיים ביותר על ידי שילוב טכניקות ה-embeddings ו-BM25 באמצעות השלבים הבאים:
- לפרק את בסיס הידע ("קורפוס" המסמכים) לחלקי טקסט קטנים יותר, בדרך כלל לא יותר מכמה מאות טוקנים;
- ליצור קידודי TF-IDF ו-embeddings סמנטיים עבור חלקיקים אלה;
- להשתמש ב-BM25 למציאת חלקיקים מובילים בהתבסס על התאמות מדויקות;
- להשתמש ב-embeddings למציאת חלקיקים מובילים בהתבסס על דמיון סמנטי;
- לשלב ולבטל כפילויות של תוצאות מ-(3) ו-(4) באמצעות טכניקות איחוד דירוגים;
- להוסיף את חלקיקי ה-Top-K לפרומפט כדי ליצור את התגובה.
על ידי מינוף BM25 ומודלי embedding, מערכות RAG מסורתיות יכולות לספק תוצאות מקיפות ומדויקות יותר, ולאזן בין התאמת מונחים מדויקת להבנה סמנטית רחבה יותר.
גישה זו מאפשרת סקיילינג חסכוני לבסיסי ידע עצומים, הרבה מעבר למה שיכול להיכנס לפרומפט בודד. אך למערכות RAG מסורתיות אלו יש מגבלה משמעותית: הן לעיתים קרובות משמידות הקשר.
דילמת ההקשר ב-RAG המסורתי
ב-RAG מסורתי, מסמכים מחולקים בדרך כלל לחלקיקים קטנים יותר לצורך שליפה יעילה. בעוד שגישה זו עובדת היטב עבור יישומים רבים, היא עלולה להוביל לבעיות כאשר חלקיקים בודדים חסרים הקשר מספק.
לדוגמה, דמיינו שיש לכם אוסף של מידע פיננסי (נניח, דוחות SEC אמריקאיים) מוטמע בבסיס הידע שלכם, וקיבלתם את השאלה הבאה: "מה הייתה צמיחת ההכנסות של ACME Corp ברבעון השני של 2023?"
חלקיק רלוונטי עשוי להכיל את הטקסט: "הכנסות החברה צמחו ב-3% לעומת הרבעון הקודם." עם זאת, חלקיק זה לבדו אינו מציין לאיזו חברה הוא מתייחס או את פרק הזמן הרלוונטי, מה שמקשה על שליפת המידע הנכון או שימוש יעיל במידע.
היכרות עם שליפה קונטקסטואלית
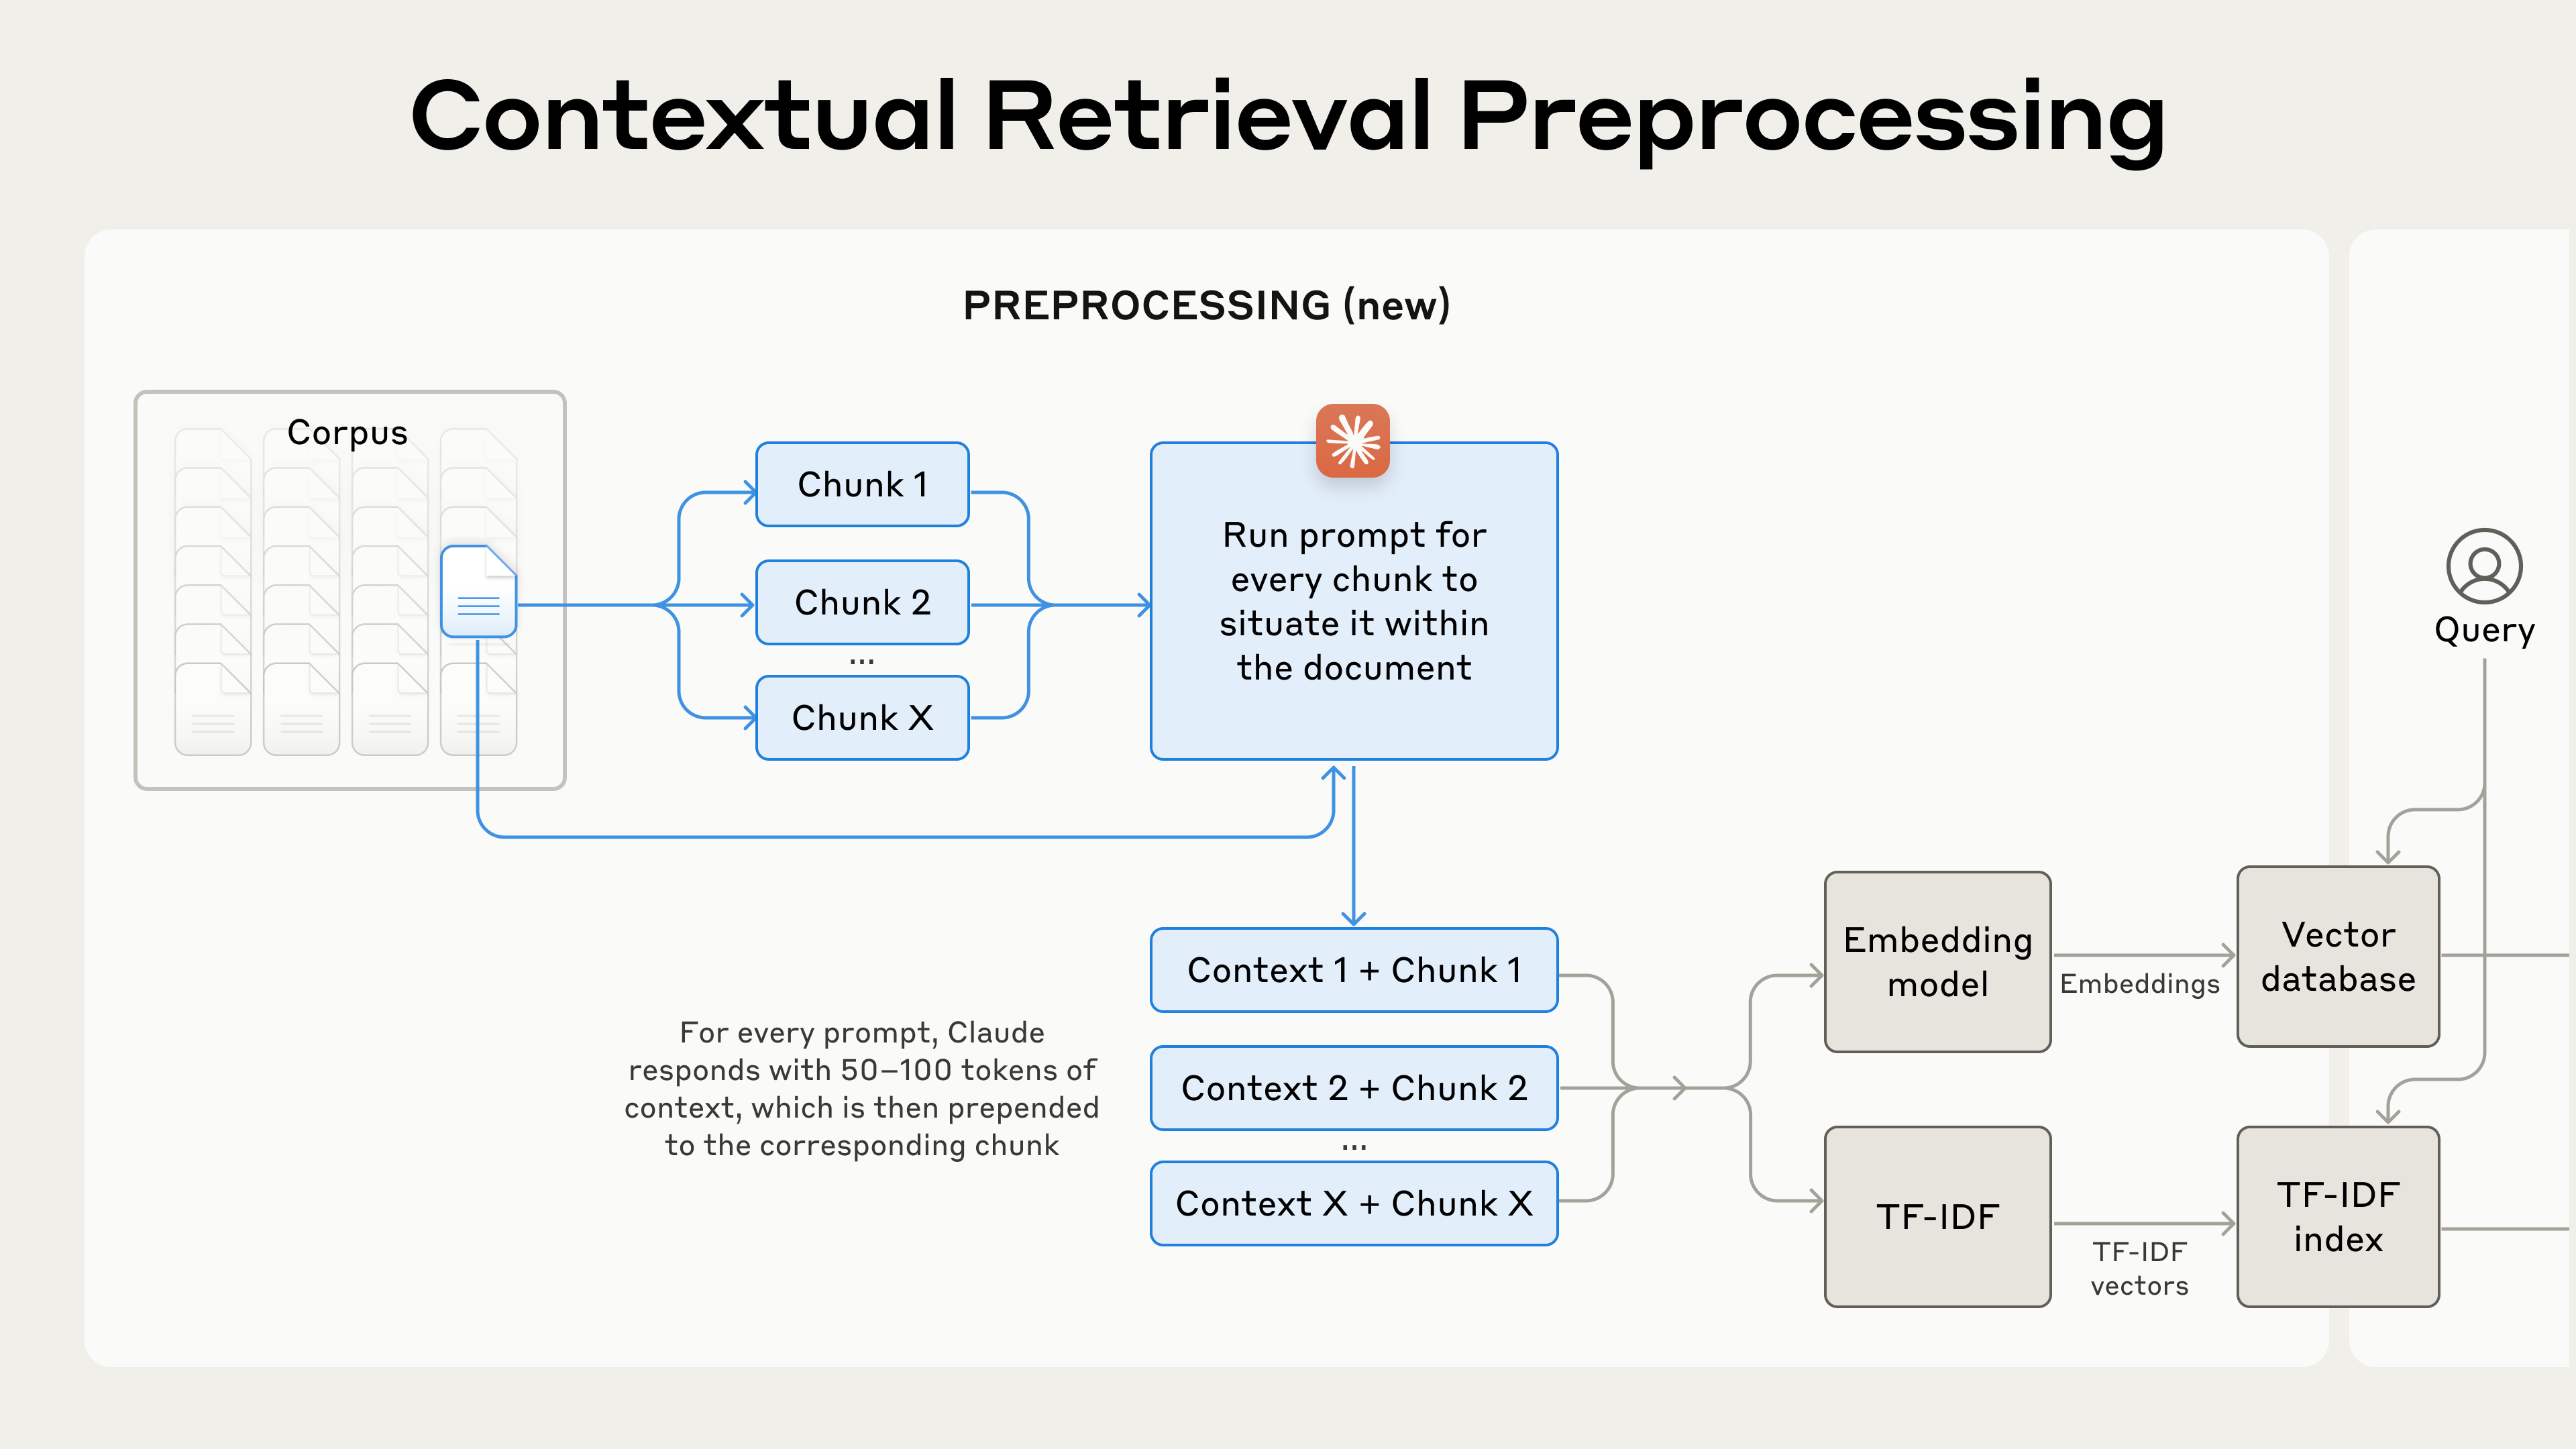
שליפה קונטקסטואלית פותרת בעיה זו על ידי הוספת הקשר הסברני ספציפי לחלקיק לפני כל חלקיק לפני ה-embedding ("Contextual Embeddings") ויצירת אינדקס BM25 ("Contextual BM25").
הבה נחזור לדוגמה שלנו של אוסף דוחות SEC. הנה דוגמה לאופן שבו חלקיק עשוי להשתנות:
original_chunk = "The company's revenue grew by 3% over the previous quarter."

contextualized_chunk = "This chunk is from an SEC filing on ACME corp's performance in Q2 2023; the previous quarter's revenue was $314 million. The company's revenue grew by 3% over the previous quarter."
ראוי לציין כי גישות אחרות לשימוש בהקשר לשיפור השליפה הוצעו בעבר. הצעות אחרות כוללות: הוספת סיכומי מסמכים כלליים לחלקיקים (ניסינו וראינו רווחים מוגבלים מאוד), embedding של מסמכים היפותטיים, ו-אינדקס מבוסס סיכום (הערכנו וראינו ביצועים נמוכים). שיטות אלו שונות ממה שמוצע בפוסט זה.
יישום שליפה קונטקסטואלית
כמובן, יהיה זה עבודה רבה מדי לבצע אנוטציה ידנית לאלפי או אפילו מיליוני חלקיקים בבסיס ידע. כדי ליישם שליפה קונטקסטואלית, אנו פונים לקלוד. כתבנו פרומפט שמורה למודל לספק הקשר תמציתי וספציפי לחלקיק, המסביר את החלקיק תוך שימוש בהקשר של המסמך כולו. השתמשנו בפרומפט הבא של Claude 3 Haiku כדי לייצר הקשר לכל חלקיק:
<document>
{{WHOLE_DOCUMENT}}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{{CHUNK_CONTENT}}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else.
הטקסט הקונטקסטואלי המתקבל, בדרך כלל 50-100 טוקנים, מתווסף בתחילת החלקיק לפני ה-embedding שלו ולפני יצירת אינדקס BM25.
כך נראית זרימת העיבוד המוקדם בפועל:
אם אתם מעוניינים להשתמש בשליפה קונטקסטואלית, תוכלו להתחיל עם ה-cookbook שלנו.
שימוש ב-Prompt Caching להפחתת עלויות השליפה הקונטקסטואלית
שליפה קונטקסטואלית אפשרית באופן ייחודי בעלות נמוכה עם Claude, בזכות תכונת ה-Prompt Caching המיוחדת שהזכרנו לעיל. עם Prompt Caching, אינכם צריכים להעביר את מסמך הייחוס עבור כל חלקיק. אתם פשוט טוענים את המסמך למטמון פעם אחת ולאחר מכן מפנים לתוכן השמור במטמון. בהנחה של חלקיקים בני 800 טוקנים, מסמכים בני 8k טוקנים, הוראות הקשר של 50 טוקנים ו-100 טוקנים של הקשר לכל חלקיק, העלות החד-פעמית ליצירת חלקיקים קונטקסטואליים היא 1.02 דולר למיליון טוקנים של מסמך.
מתודולוגיה
ערכנו ניסויים במגוון תחומי ידע (בסיסי קוד, ספרות יפה, מאמרי ArXiv, מאמרי מדע), מודלי embedding, אסטרטגיות שליפה ומדדי הערכה. כללנו כמה דוגמאות לשאלות ותשובות שבהן השתמשנו עבור כל תחום ב-נספח II.
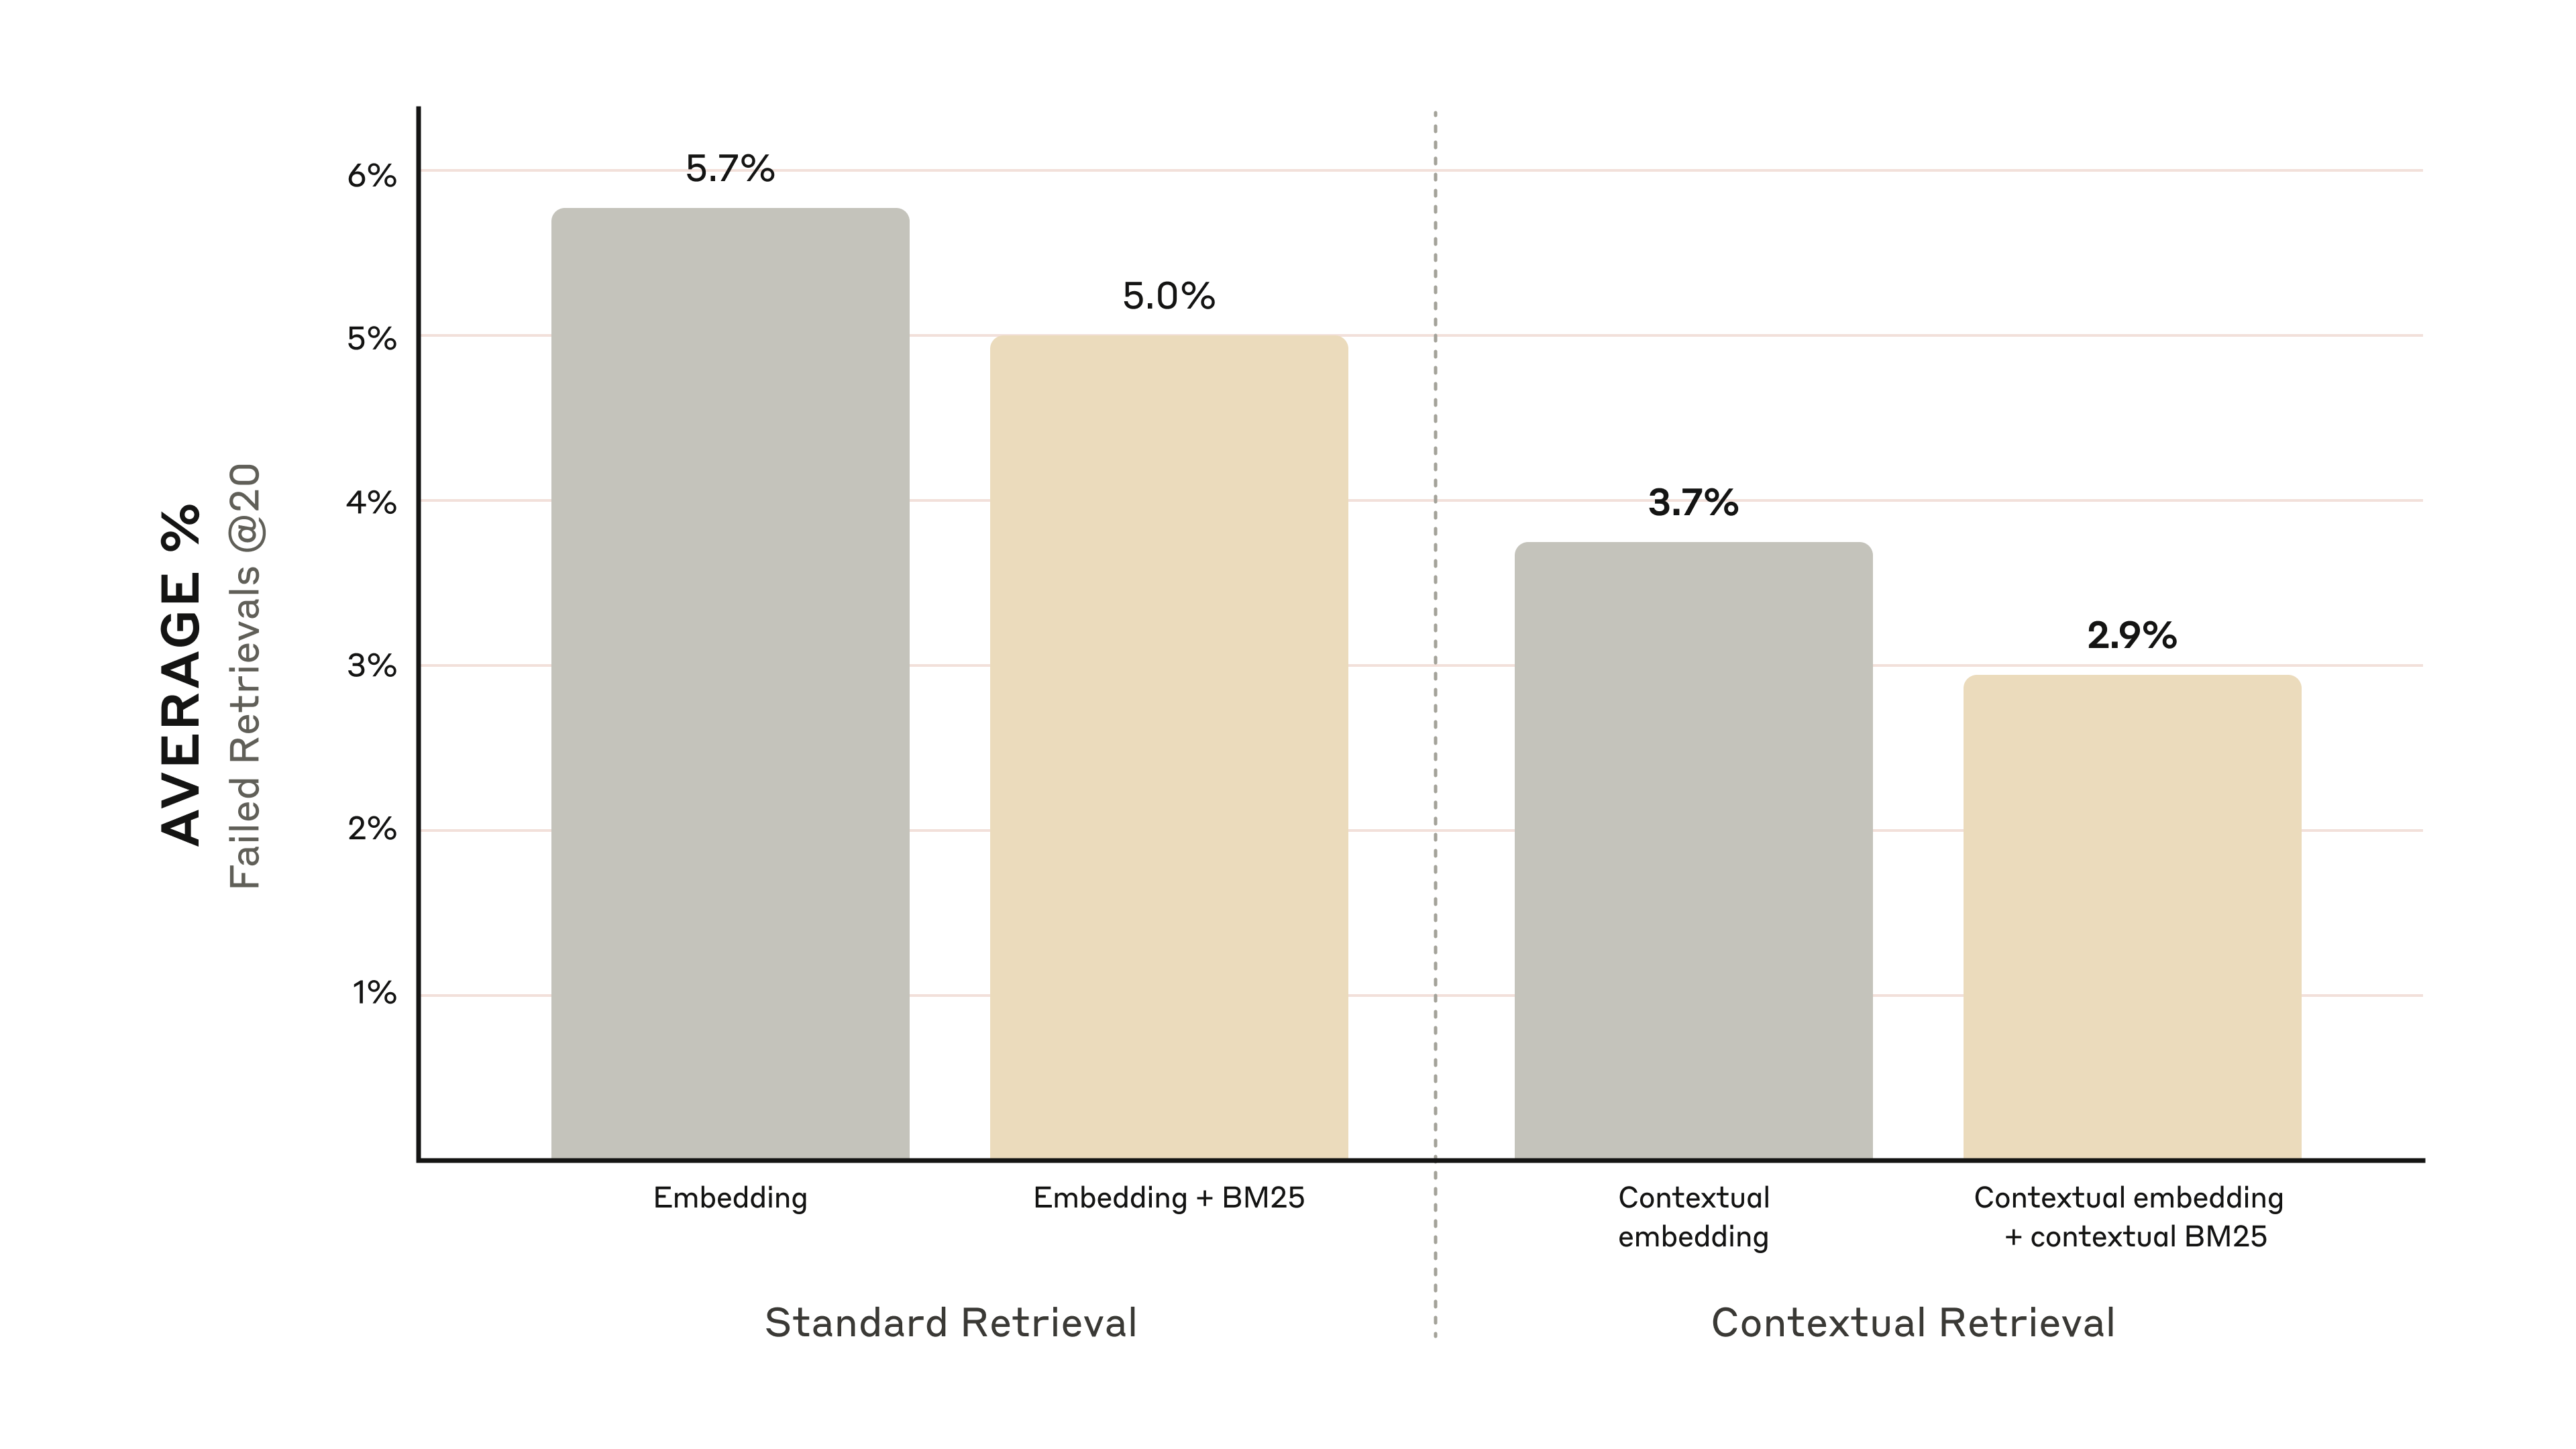
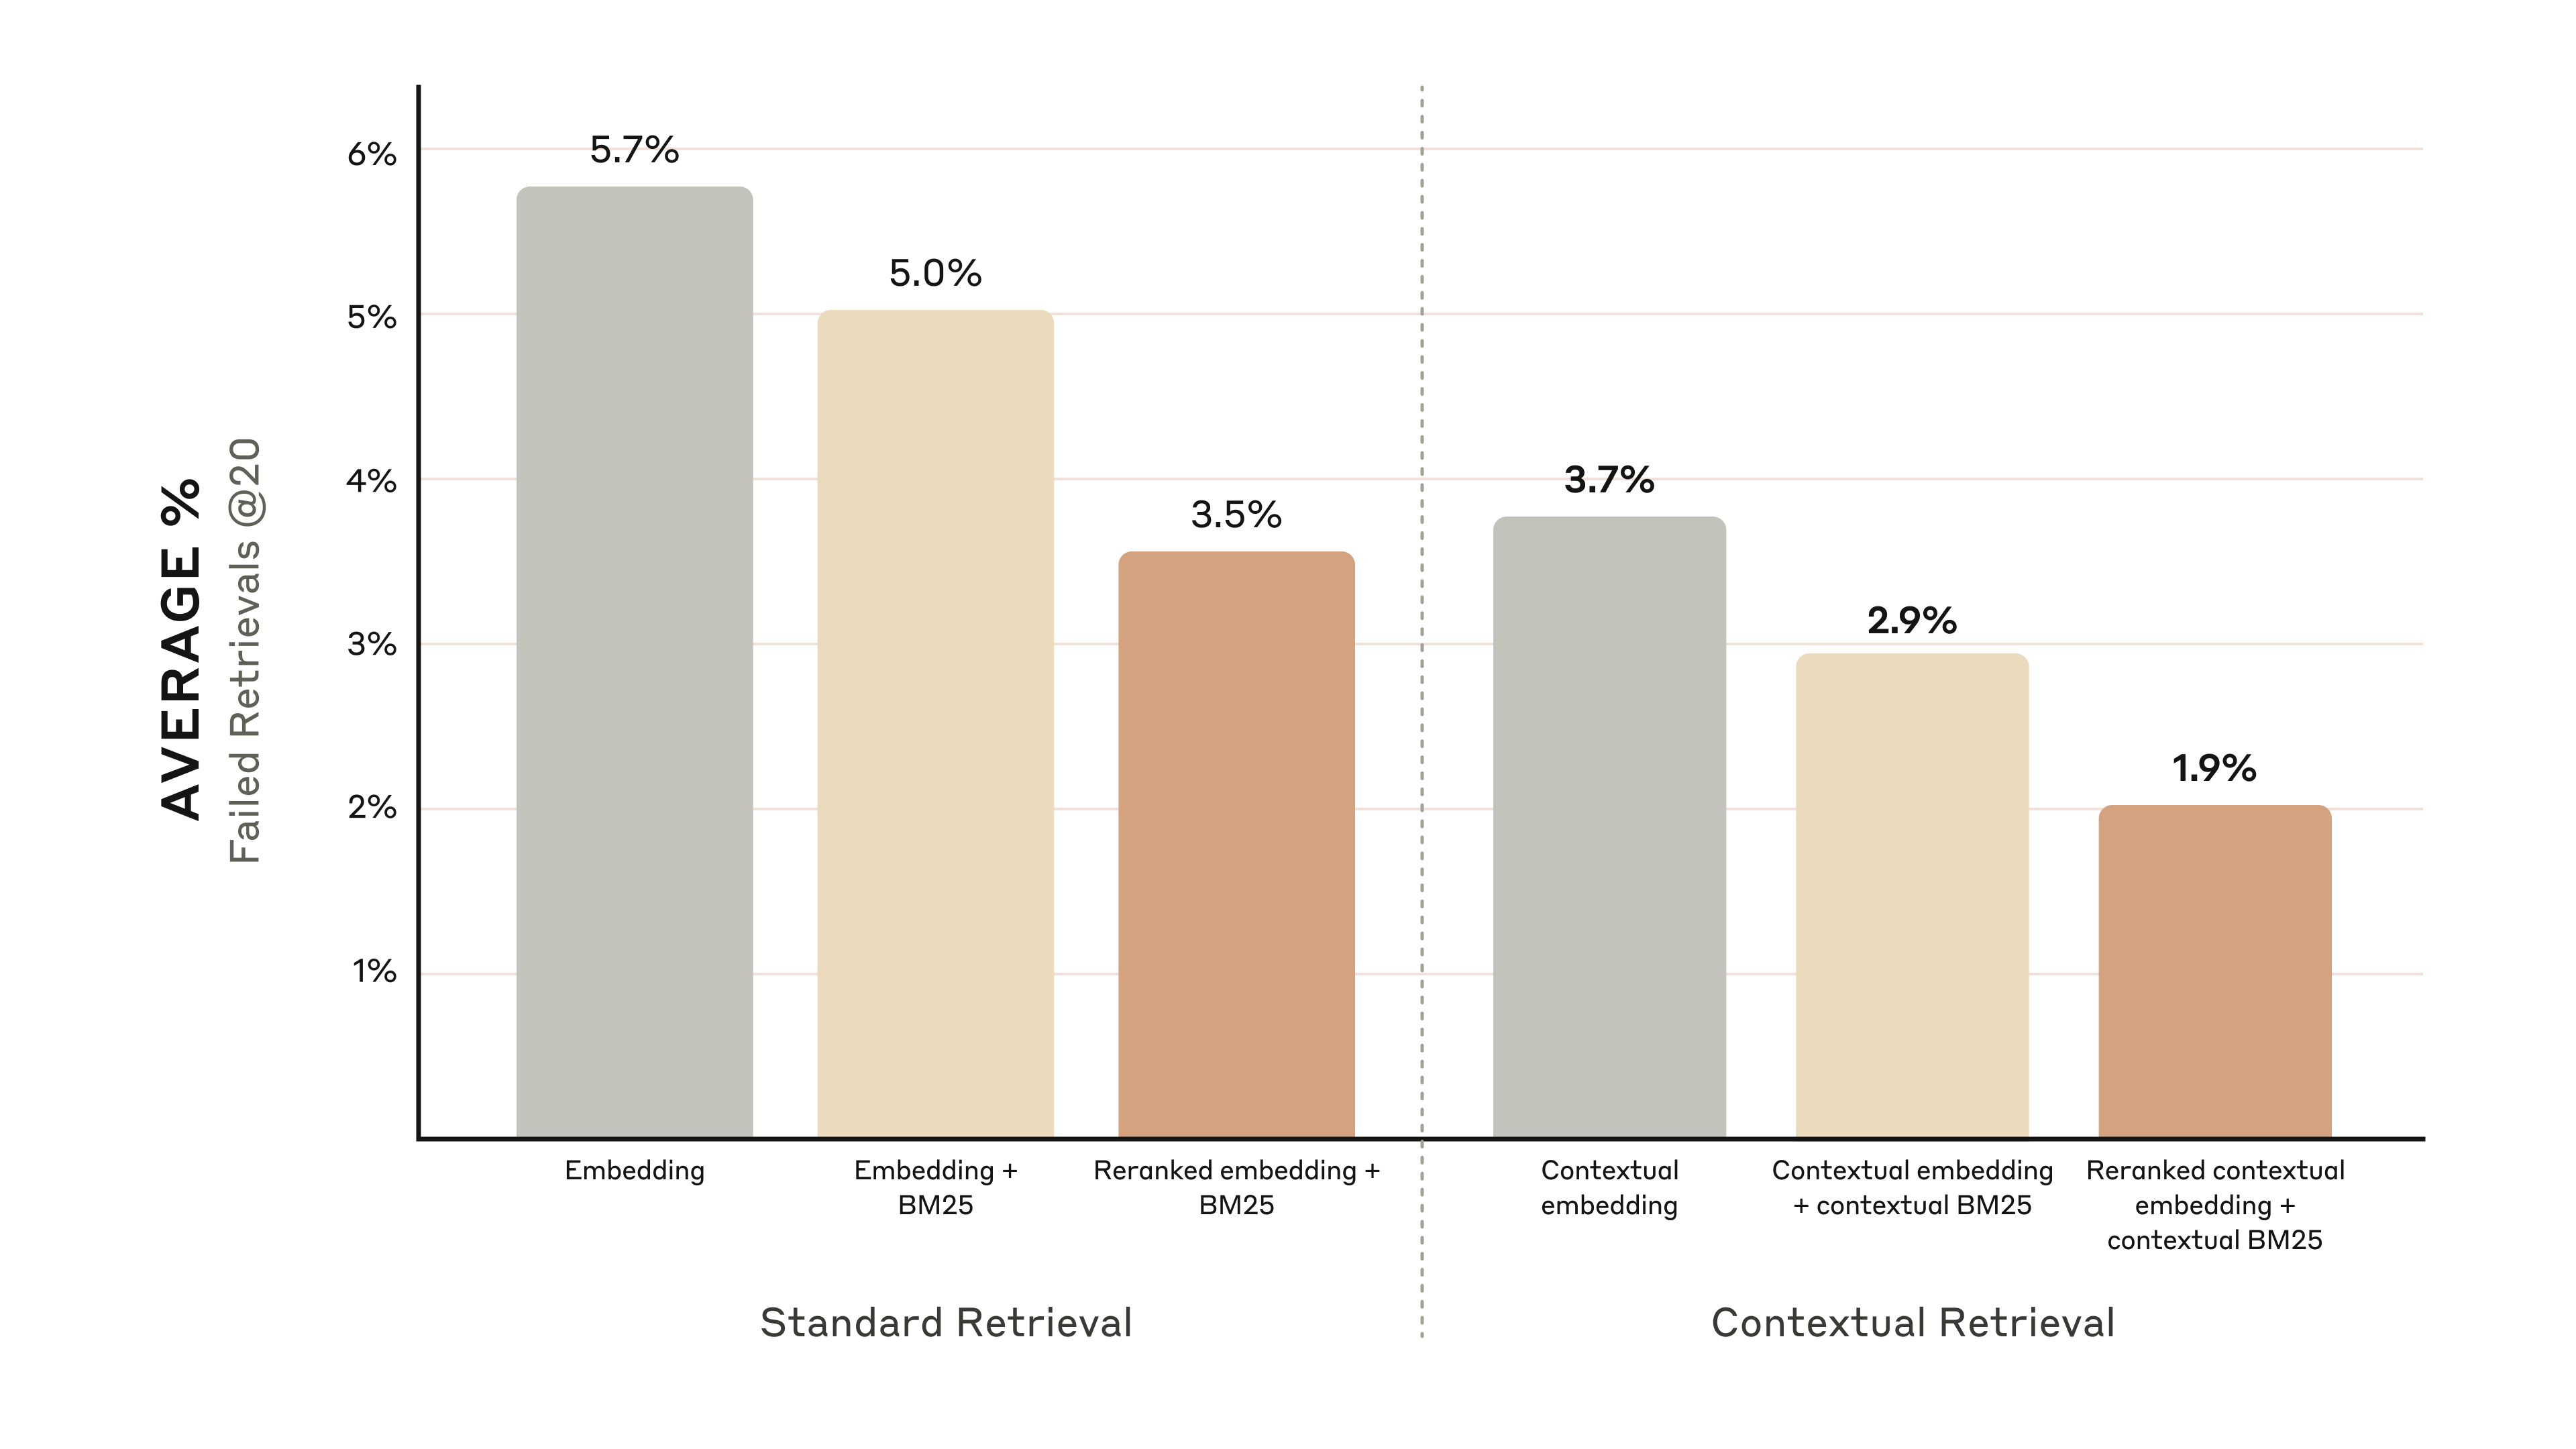
הגרפים שלהלן מציגים את הביצועים הממוצעים בכל תחומי הידע עם תצורת ה-embedding בעלת הביצועים הטובים ביותר (Gemini Text 004) ושליפת 20 החלקיקים המובילים. אנו משתמשים ב-1 פחות recall@20 כמדד ההערכה שלנו, המודד את אחוז המסמכים הרלוונטיים שלא נשלפו בתוך 20 החלקיקים המובילים. תוכלו לראות את התוצאות המלאות בנספח – הוספת הקשר משפרת את הביצועים בכל שילוב של מקור embedding שהערכנו.
שיפורי ביצועים
- Contextual Embeddings הפחיתו את שיעור כשלי השליפה של 20 החלקיקים המובילים ב-35% (5.7% ← 3.7%).
- שילוב של Contextual Embeddings ו-Contextual BM25 הפחית את שיעור כשלי השליפה של 20 החלקיקים המובילים ב-49% (5.7% ← 2.9%).
שיקולי יישום
- גבולות חלקיקים: שקלו כיצד אתם מחלקים את המסמכים שלכם לחלקיקים. הבחירה בגודל החלקיק, גבולות החלקיק וחפיפת החלקיקים יכולה להשפיע על ביצועי השליפה.
- מודל Embedding: בעוד ששליפה קונטקסטואלית משפרת ביצועים בכל מודלי ה-embedding שבדקנו, ייתכן שחלק מהמודלים יפיקו תועלת רבה יותר מאחרים. מצאנו כי embeddings של Gemini ו-Voyage יעילים במיוחד.
- פרומפטים מותאמים אישית למתאמי הקשר: בעוד שהפרומפט הגנרי שסיפקנו עובד היטב, ייתכן שתוכלו להשיג תוצאות טובות אף יותר עם פרומפטים המותאמים לתחום הספציפי או למקרה השימוש שלכם (לדוגמה, הכללת מילון מונחים של מונחי מפתח שעשויים להיות מוגדרים רק במסמכים אחרים בבסיס הידע).
- מספר החלקיקים: הוספת חלקיקים נוספים לחלון ההקשר מגדילה את הסיכויים שתכללו את המידע הרלוונטי. עם זאת, יותר מידע יכול להסיח את דעת המודלים, ולכן יש לכך גבול. ניסינו לספק 5, 10 ו-20 חלקיקים, ומצאנו כי שימוש ב-20 היה בעל הביצועים הטובים ביותר מבין האפשרויות הללו (ראו נספח להשוואות) אך כדאי להתנסות במקרה השימוש שלכם.
תמיד הפעילו בדיקות הערכה: ייתכן שניתן לשפר את יצירת התגובות על ידי העברת החלקיק עם ההקשר והבחנה בין מהו הקשר לבין מהו החלקיק.
הגברת ביצועים נוספת באמצעות Reranking
ב-RAG מסורתי, מערכת ה-AI מחפשת בבסיס הידע שלה כדי למצוא את חלקיקי המידע הפוטנציאליים הרלוונטיים. עם בסיסי ידע גדולים, שליפה ראשונית זו לרוב מחזירה חלקיקים רבים – לעיתים מאות – בעלי רלוונטיות וחשיבות משתנות.
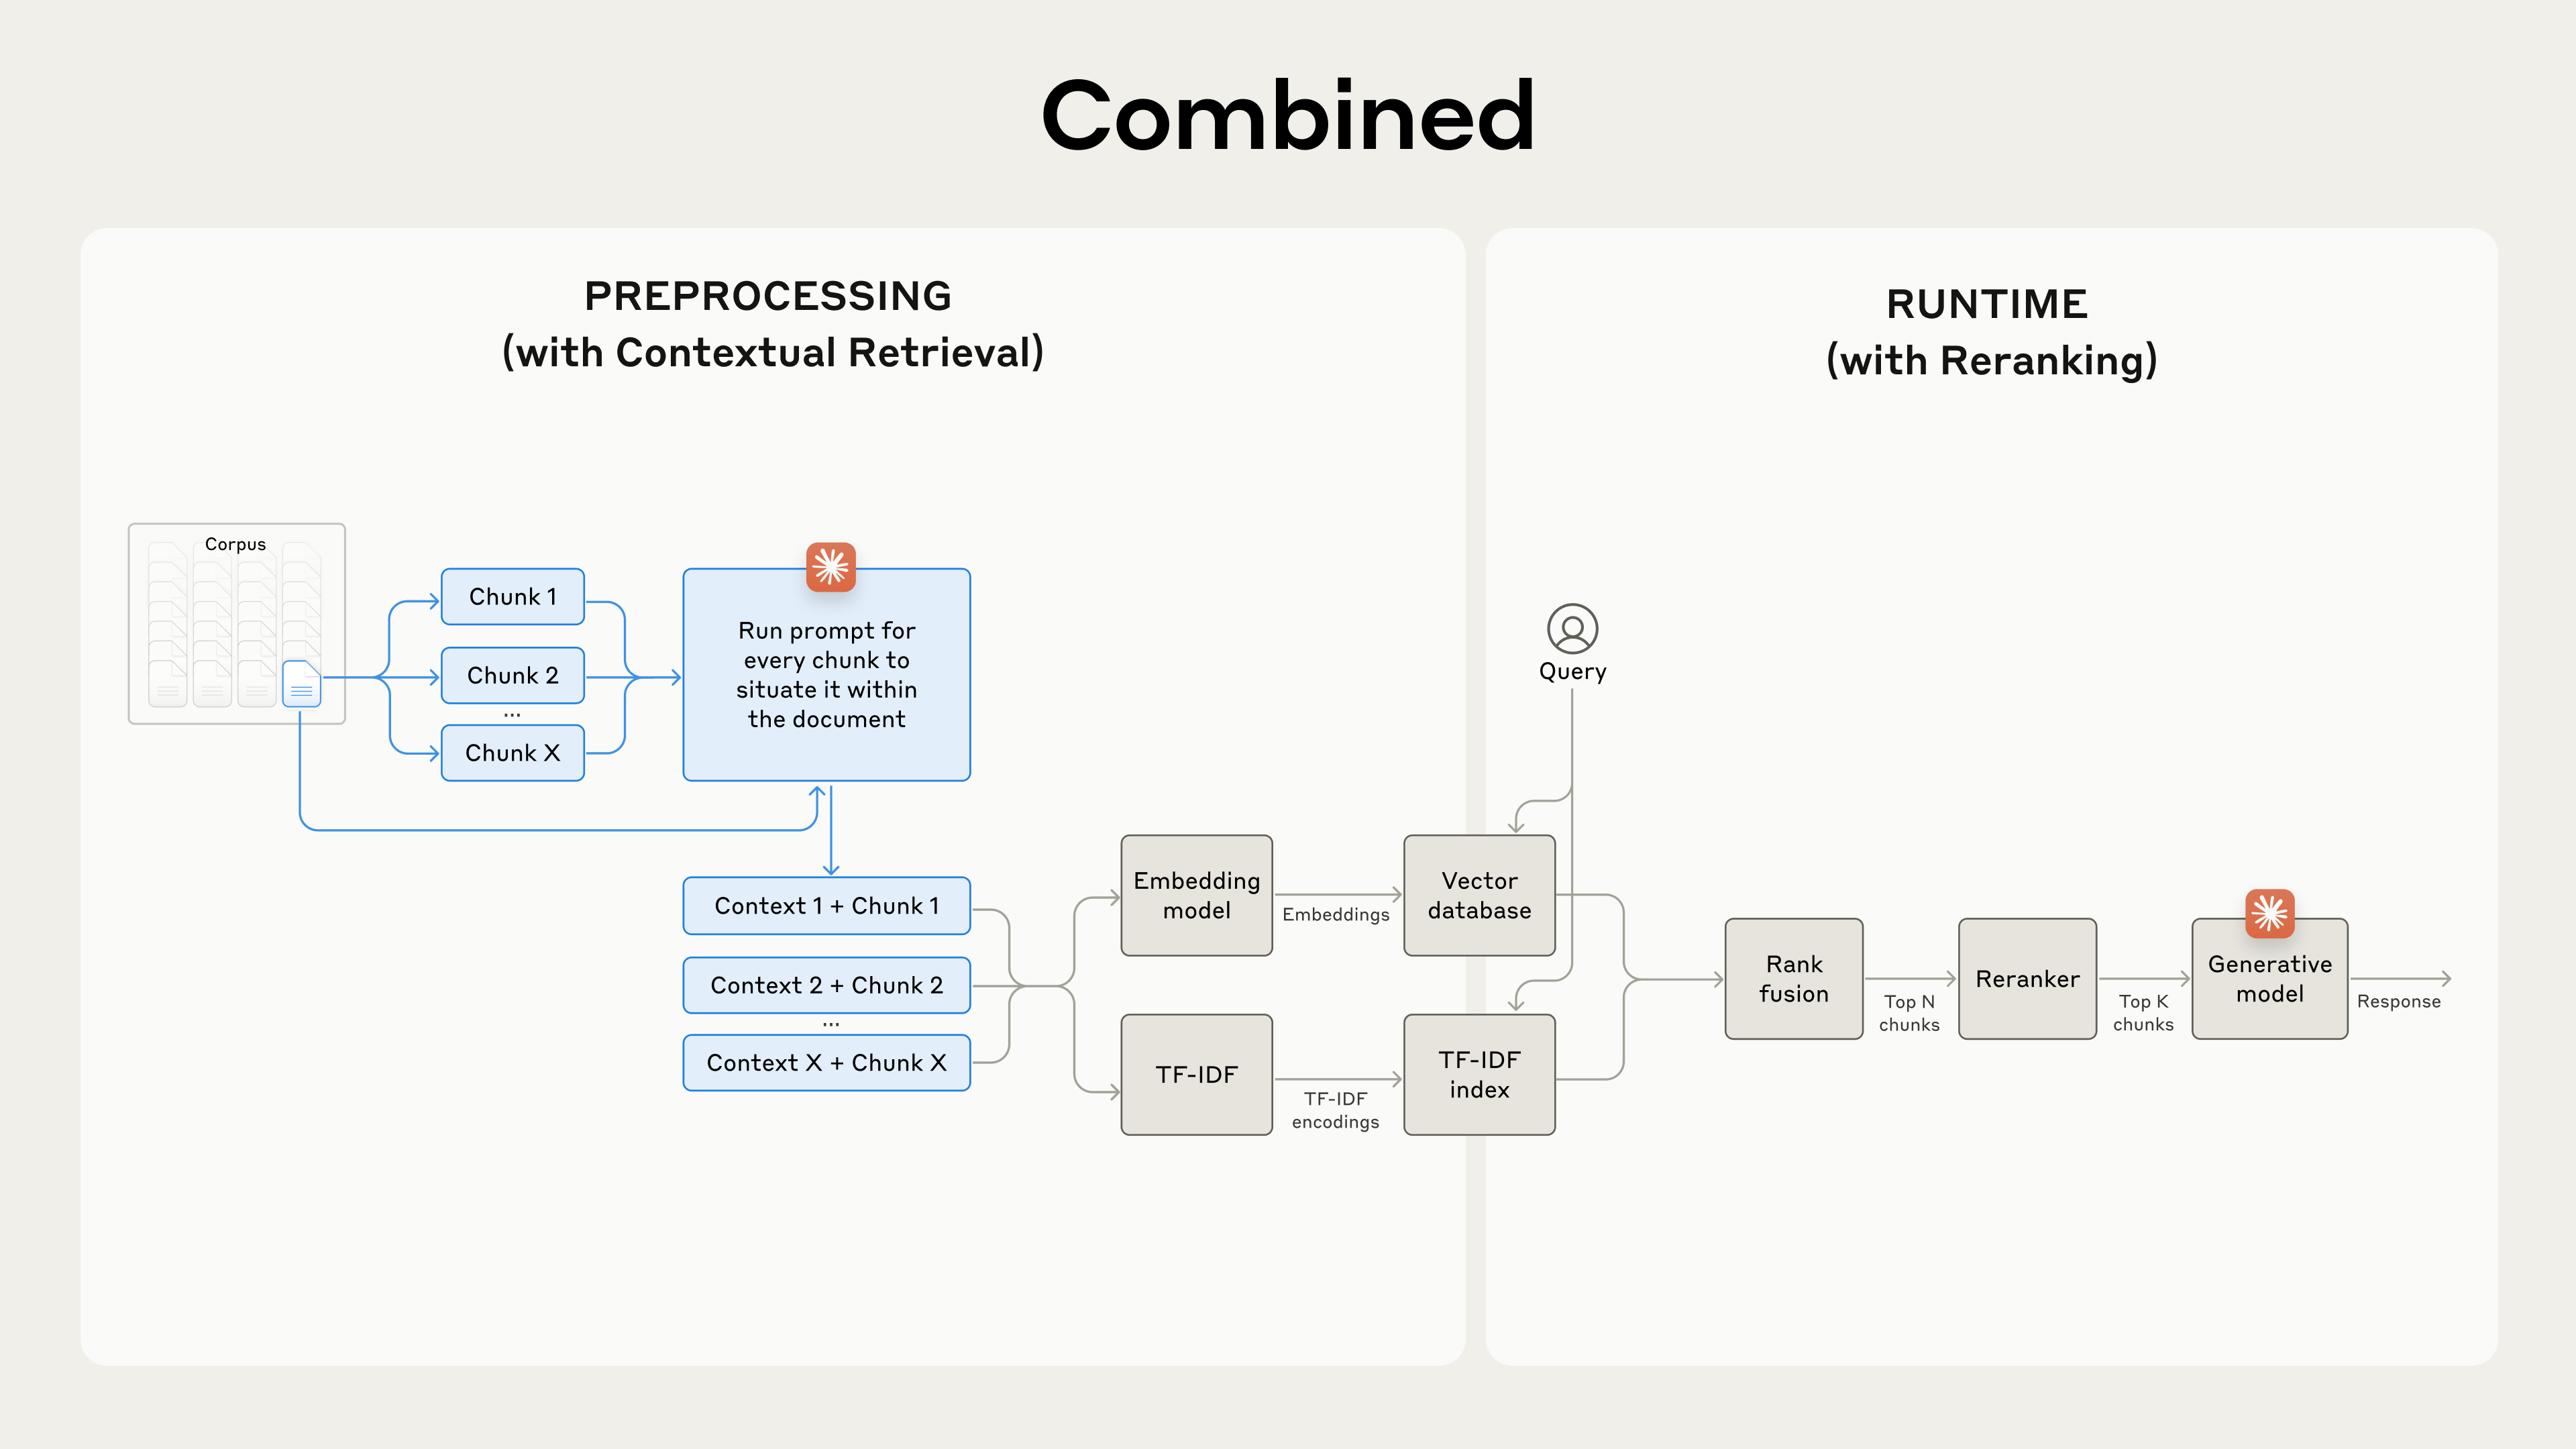
Reranking היא טכניקת סינון נפוצה כדי להבטיח שרק החלקיקים הרלוונטיים ביותר יועברו למודל. Reranking מספק תגובות טובות יותר ומפחית עלויות וזמן שהיה, מכיוון שהמודל מעבד פחות מידע. שלבי המפתח הם:
- בצעו שליפה ראשונית כדי לקבל את החלקיקים הפוטנציאליים הרלוונטיים ביותר (אנו השתמשנו ב-150 המובילים);
- העבירו את חלקיקי ה-Top-N, יחד עם שאילתת המשתמש, דרך מודל ה-reranking;
- באמצעות מודל reranking, תנו לכל חלקיק ציון המבוסס על הרלוונטיות והחשיבות שלו לפרומפט, ולאחר מכן בחרו את חלקיקי ה-Top-K (אנו השתמשנו ב-20 המובילים);
- העבירו את חלקיקי ה-Top-K למודל כהקשר ליצירת התוצאה הסופית.
שיפורי ביצועים
קיימים בשוק מספר מודלי reranking. אנו ערכנו את הבדיקות שלנו עם ה-reranker של Cohere. גם Voyage מציעה reranker, אם כי לא היה לנו זמן לבדוק אותו. הניסויים שלנו הראו כי, במגוון תחומים, הוספת שלב reranking מייעלת עוד יותר את השליפה.
באופן ספציפי, מצאנו כי Contextual Embedding ו-Contextual BM25 עם reranking הפחיתו את שיעור כשלי השליפה של 20 החלקיקים המובילים ב-67% (5.7% ← 1.9%).
שיקולי עלות וזמן שהיה
שיקול חשוב אחד עם reranking הוא ההשפעה על זמן השהיה (latency) ועלות, במיוחד בעת reranking של מספר רב של חלקיקים. מכיוון ש-reranking מוסיף שלב נוסף בזמן ריצה, הוא מוסיף בהכרח כמות קטנה של זמן שהיה, למרות שה-reranker מדרג את כל החלקיקים במקביל. ישנו איזון טבוע בין reranking של יותר חלקיקים לביצועים טובים יותר לבין reranking של פחות חלקיקים לזמן שהיה ועלות נמוכים יותר. אנו ממליצים להתנסות עם הגדרות שונות במקרה השימוש הספציפי שלכם כדי למצוא את האיזון הנכון.
מסקנה
ערכנו מספר רב של בדיקות, והשוונו שילובים שונים של כל הטכניקות שתוארו לעיל (מודל embedding, שימוש ב-BM25, שימוש בשליפה קונטקסטואלית, שימוש ב-reranker, ומספר כולל של תוצאות Top-K שנשלפו), הכל על פני מגוון סוגי נתונים שונים. הנה סיכום של מה שמצאנו:
- שילוב embeddings ו-BM25 עדיף על embeddings לבדם;
- ל-Voyage ול-Gemini יש את ה-embeddings הטובים ביותר מבין אלה שבדקנו;
- העברת 20 החalקיקים המובילים למודל יעילה יותר מאשר רק 10 או 5 המובילים;
- הוספת הקשר לחלקיקים משפרת מאוד את דיוק השליפה;
- Reranking טוב יותר מאי-שימוש ב-reranking;
- כל היתרונות הללו נערמים: כדי למקסם את שיפורי הביצועים, אנו יכולים לשלב contextual embeddings (מ-Voyage או Gemini) עם Contextual BM25, בתוספת שלב reranking, והוספת 20 החלקיקים לפרומפט.
אנו מעודדים את כל המפתחים העובדים עם בסיסי ידע להשתמש ב-ה-cookbook שלנו כדי להתנסות בגישות אלו ולפתוח רמות חדשות של ביצועים.
נספח I
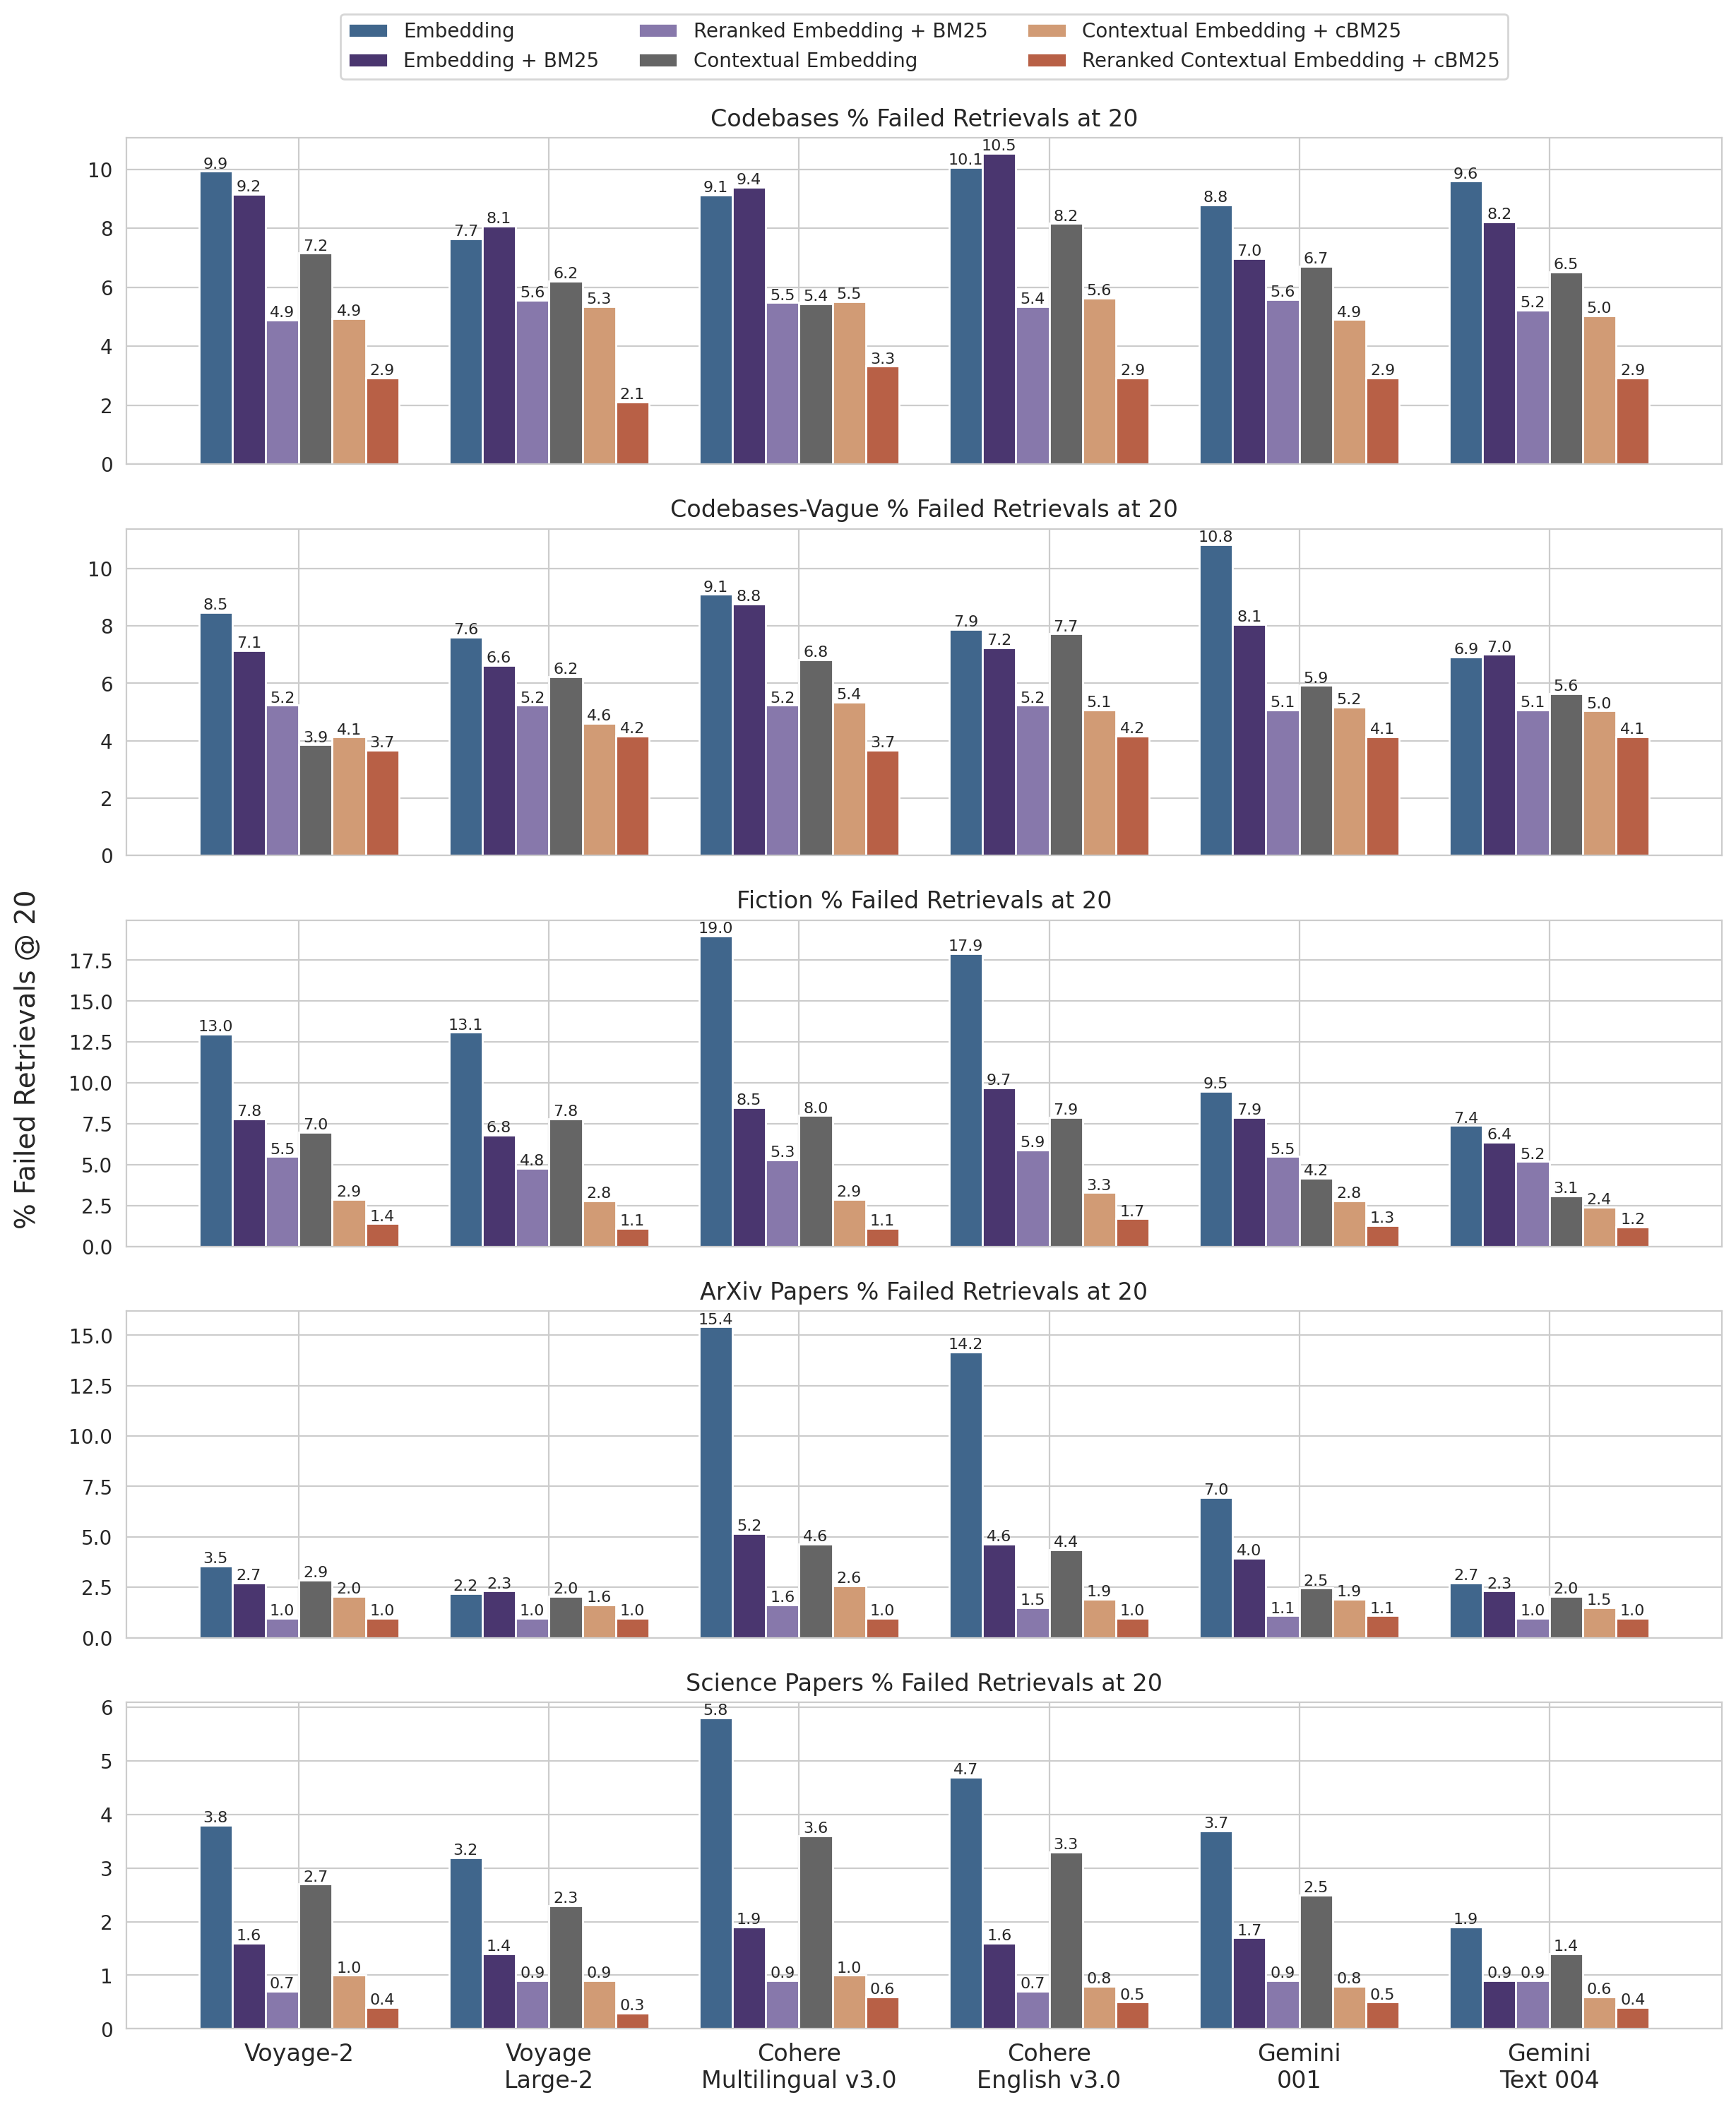
להלן פירוט התוצאות על פני מערכי נתונים, ספקי embeddings, שימוש ב-BM25 בנוסף ל-embeddings, שימוש בשליפה קונטקסטואלית, ושימוש ב-reranking עבור Retrievals @ 20.
ראו נספח II לפירוט עבור Retrievals @ 10 ו-@ 5, כמו גם שאלות ותשובות לדוגמה עבור כל מערך נתונים.
תודות
מחקר וכתיבה מאת דניאל פורד (Daniel Ford). תודה לאורווה סיקדר (Orowa Sikder), גאוטם מיטאל (Gautam Mittal) וקנת' ליאן (Kenneth Lien) על משוב קריטי, לסמואל פלמיני (Samuel Flamini) על יישום ה-cookbooks, ללורן פולנסקי (Lauren Polansky) על תיאום הפרויקט ולאלכס אלברט (Alex Albert), סוזן פיין (Susan Payne), סטיוארט ריצ'י (Stuart Ritchie) ובראד אברמס (Brad Abrams) על עיצוב פוסט זה בבלוג.