הערה: רוב סביבת הכלים המתוארת בפוסט זה השתנתה מאז דצמבר 2024. לגישה הנוכחית שלנו, ראו כיצד בנינו את Claude Managed Agents ו-התיעוד של Managed Agents.
במהלך השנה האחרונה, עבדנו עם עשרות צוותים שבנו סוכני LLM (מודל שפה גדול) בתעשיות שונות. באופן עקבי, היישומים המוצלחים ביותר לא השתמשו בפריימוורקים מורכבים או בספריות ייעודיות, אלא נבנו על בסיס תבניות פשוטות וניתנות להרכבה.
בפוסט זה, אנו חולקים את מה שלמדנו מעבודה עם הלקוחות שלנו ובניית סוכנים בעצמנו, ומספקים עצות מעשיות למפתחים לבניית סוכנים יעילים.
מהם סוכנים?
ניתן להגדיר את המונח "סוכן" במספר דרכים. חלק מהלקוחות מגדירים סוכנים כמערכות אוטונומיות לחלוטין הפועלות באופן עצמאי לאורך זמן, תוך שימוש בכלים שונים לביצוע משימות מורכבות. אחרים משתמשים במונח לתיאור יישומים יותר מוגדרים מראש, העוקבים אחר תהליכי עבודה ספציפיים. באנתרופיק, אנו מסווגים את כל הווריאציות הללו כמערכות סוכני, אך מבחינים הבחנה ארכיטקטונית חשובה בין תהליכי עבודה לבין סוכנים:
- תהליכי עבודה (Workflows) הן מערכות שבהן מודלי LLM וכלים מתוזמרים באמצעות נתיבי קוד מוגדרים מראש.
- סוכנים (Agents), לעומת זאת, הן מערכות שבהן מודלי LLM מכוונים באופן דינמי את התהליכים ושימושם בכלים, ושומרים על שליטה באופן שבו הם מבצעים משימות.
בהמשך, נחקור את שני סוגי המערכות הסוכניות הללו בפירוט. בנספח 1 ("סוכנים בפועל"), אנו מתארים שני תחומים שבהם לקוחות מצאו ערך מיוחד בשימוש במערכות מסוג זה.
מתי (ומתי לא) להשתמש בסוכנים
כאשר בונים יישומים עם מודלי LLM, אנו ממליצים למצוא את הפתרון הפשוט ביותר האפשרי, ולהגדיל את המורכבות רק בעת הצורך. ייתכן שהדבר אומר שלא לבנות מערכות סוכני כלל. מערכות סוכני מחליפות לעיתים קרובות השהייה ועלות תמורת ביצועי משימה טובים יותר, ועליכם לשקול מתי פשרה זו הגיונית.
כאשר נדרשת מורכבות רבה יותר, תהליכי עבודה מציעים יכולת חיזוי ועקביות עבור משימות מוגדרות היטב, בעוד שסוכנים הם האפשרות הטובה יותר כאשר נדרשים גמישות וקבלת החלטות מונחית-מודל בקנה מידה רחב. עבור יישומים רבים, עם זאת, אופטימיזציה של קריאות LLM בודדות עם שליפה ודוגמאות בתוך ההקשר בדרך כלל מספיקה.
מתי וכיצד להשתמש בפריימוורקים
קיימים פריימוורקים רבים המקלים על יישום מערכות סוכני, כולל:
- ה-Claude Agent SDK;
- Strands Agents SDK by AWS;
- Rivet, בונה תהליכי עבודה של LLM עם ממשק גרירה ושחרור (drag and drop GUI); ו-
- Vellum, כלי GUI נוסף לבנייה ובדיקה של תהליכי עבודה מורכבים.
פריימוורקים אלו מקלים על תחילת העבודה על ידי פישוט משימות נמוכות-רמה סטנדרטיות כמו קריאה למודלי LLM, הגדרה וניתוח כלים, ושרשור קריאות יחד. עם זאת, לעיתים קרובות הם יוצרים שכבות הפשטה נוספות שיכולות לטשטש את הפרומפטים והתגובות הבסיסיים, מה שהופך אותם לקשים יותר לניפוי באגים. הם גם יכולים לפתות להוסיף מורכבות כאשר הגדרה פשוטה יותר הייתה מספיקה.
אנו מציעים למפתחים להתחיל בשימוש ישיר ב-API של מודלי LLM: תבניות רבות ניתנות ליישום בכמה שורות קוד בלבד. אם אתם אכן משתמשים בפריימוורק, וודאו שאתם מבינים את הקוד הבסיסי. הנחות שגויות לגבי מה שמתחת למכסה המנוע הן מקור נפוץ לשגיאות אצל לקוחות.
ראו את ה-ספר מתכונים שלנו ליישומים לדוגמה.
אבני בניין, תהליכי עבודה וסוכנים
בסעיף זה, נחקור את התבניות הנפוצות למערכות סוכני שראינו בייצור. נתחיל עם אבן הבניין הבסיסית שלנו – מודל ה-LLM המורחב – ונמשיך להגדיל את המורכבות בהדרגה, מתהליכי עבודה פשוטים וקומפוזיציוניים ועד לסוכנים אוטונומיים.
אבן בניין: מודל ה-LLM המורחב (Augmented LLM)
אבן הבניין הבסיסית של מערכות סוכני היא מודל LLM משופר עם הרחבות כגון שליפה (retrieval), כלים (tools) וזיכרון. המודלים הנוכחיים שלנו יכולים להשתמש באופן אקטיבי ביכולות אלו – ליצור שאילתות חיפוש משלהם, לבחור כלים מתאימים, ולקבוע איזה מידע לשמר.
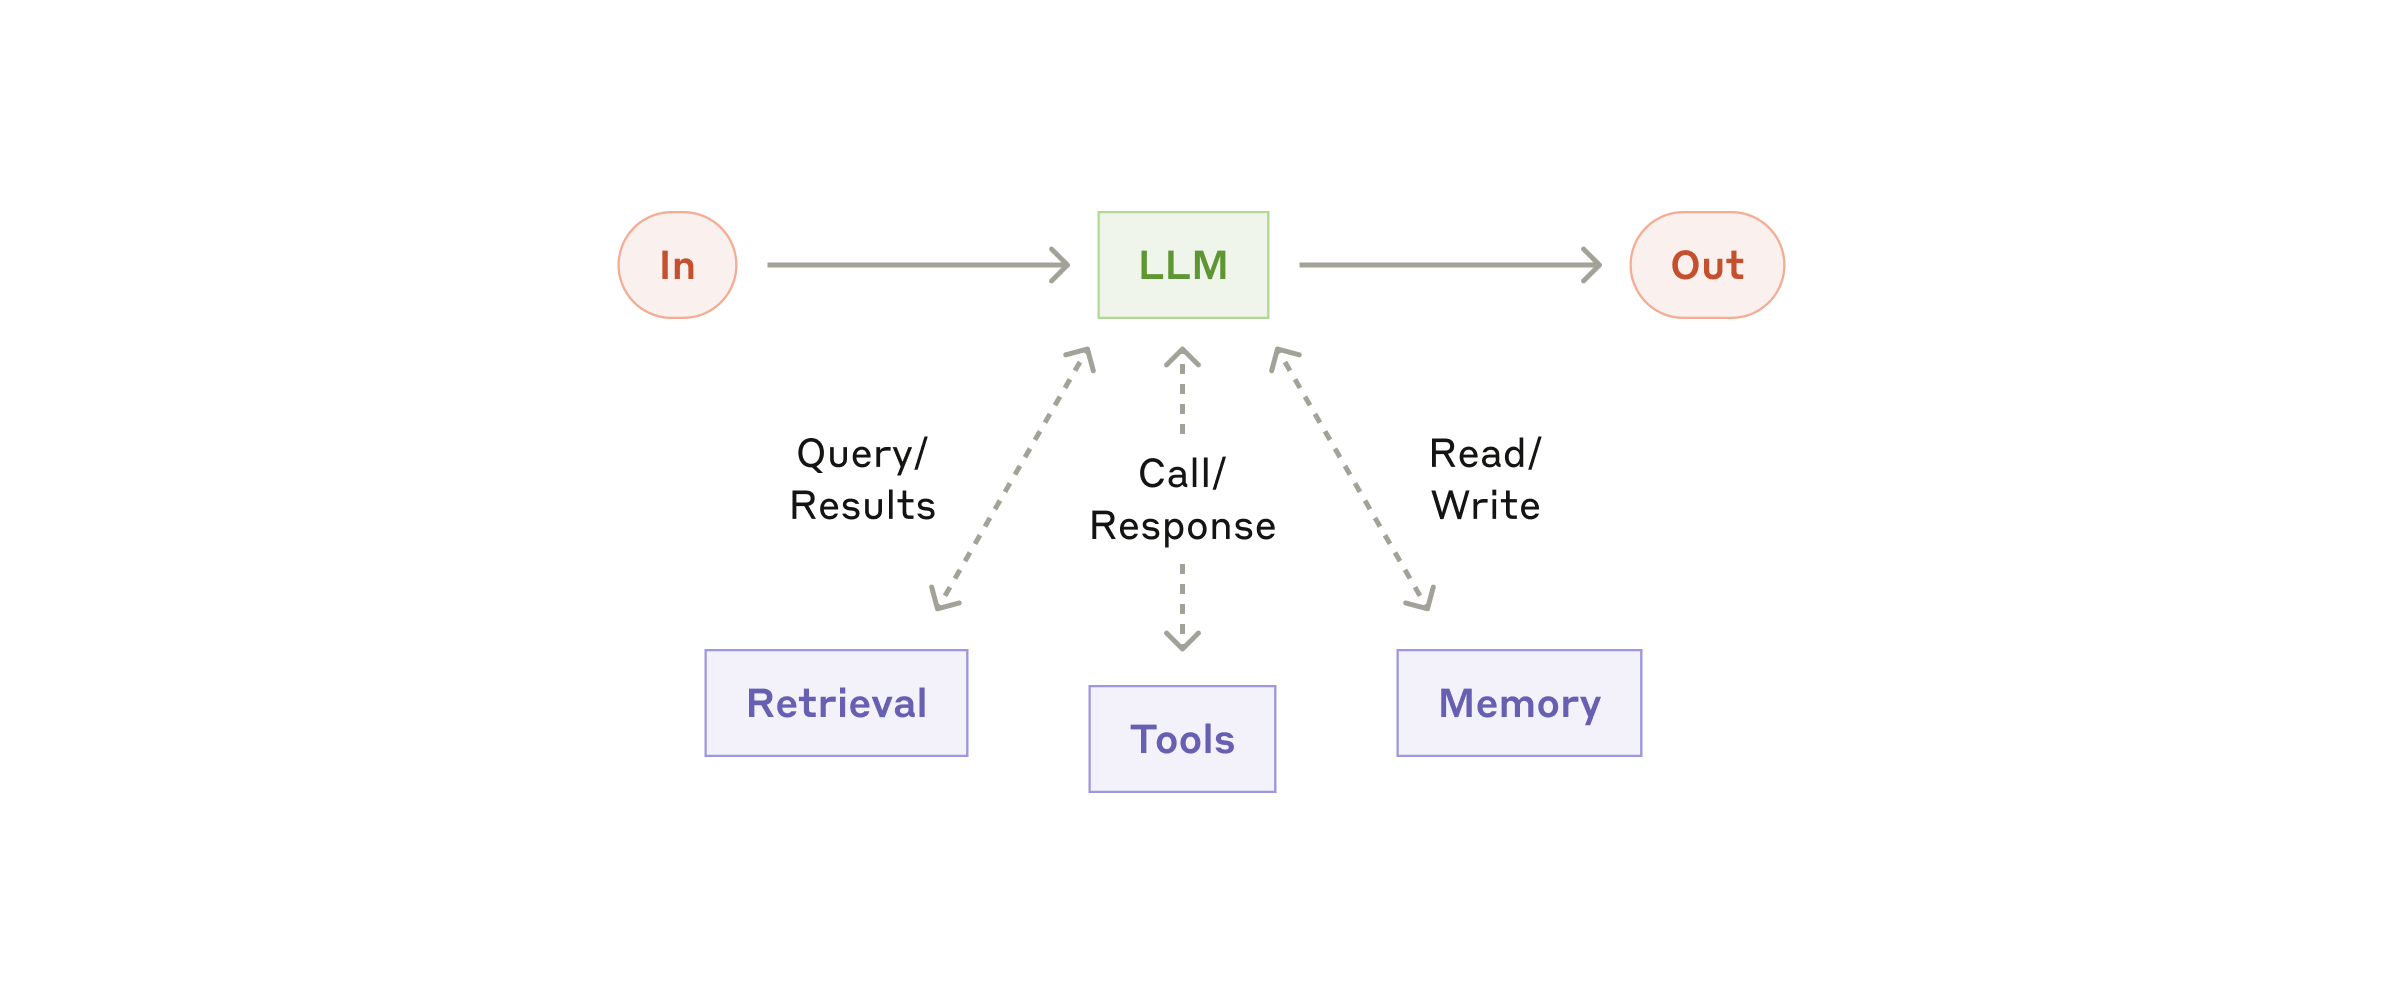
אנו ממליצים להתמקד בשני היבטים מרכזיים של היישום: התאמת יכולות אלו למקרה השימוש הספציפי שלכם, והבטחה שהן מספקות ממשק קל ומתועד היטב למודל ה-LLM שלכם. בעוד שיש דרכים רבות ליישם הרחבות אלו, גישה אחת היא באמצעות Model Context Protocol, ששוחרר לאחרונה, המאפשר למפתחים להשתלב עם אקוסיסטם הולך וגדל של כלי צד שלישי באמצעות יישום לקוח פשוט.
עבור יתרת הפוסט הזה, נניח שלכל קריאת LLM יש גישה ליכולות מורחבות אלו.
תהליך עבודה: שרשור פרומפטים (Prompt chaining)
שרשור פרומפטים מפרק משימה לרצף של צעדים, כאשר כל קריאת LLM מעבדת את הפלט של הקריאה הקודמת. ניתן להוסיף בדיקות תוכניתיות (ראו "gate" בתרשים למטה) בכל שלבי הביניים כדי להבטיח שהתהליך עדיין במסלול הנכון.
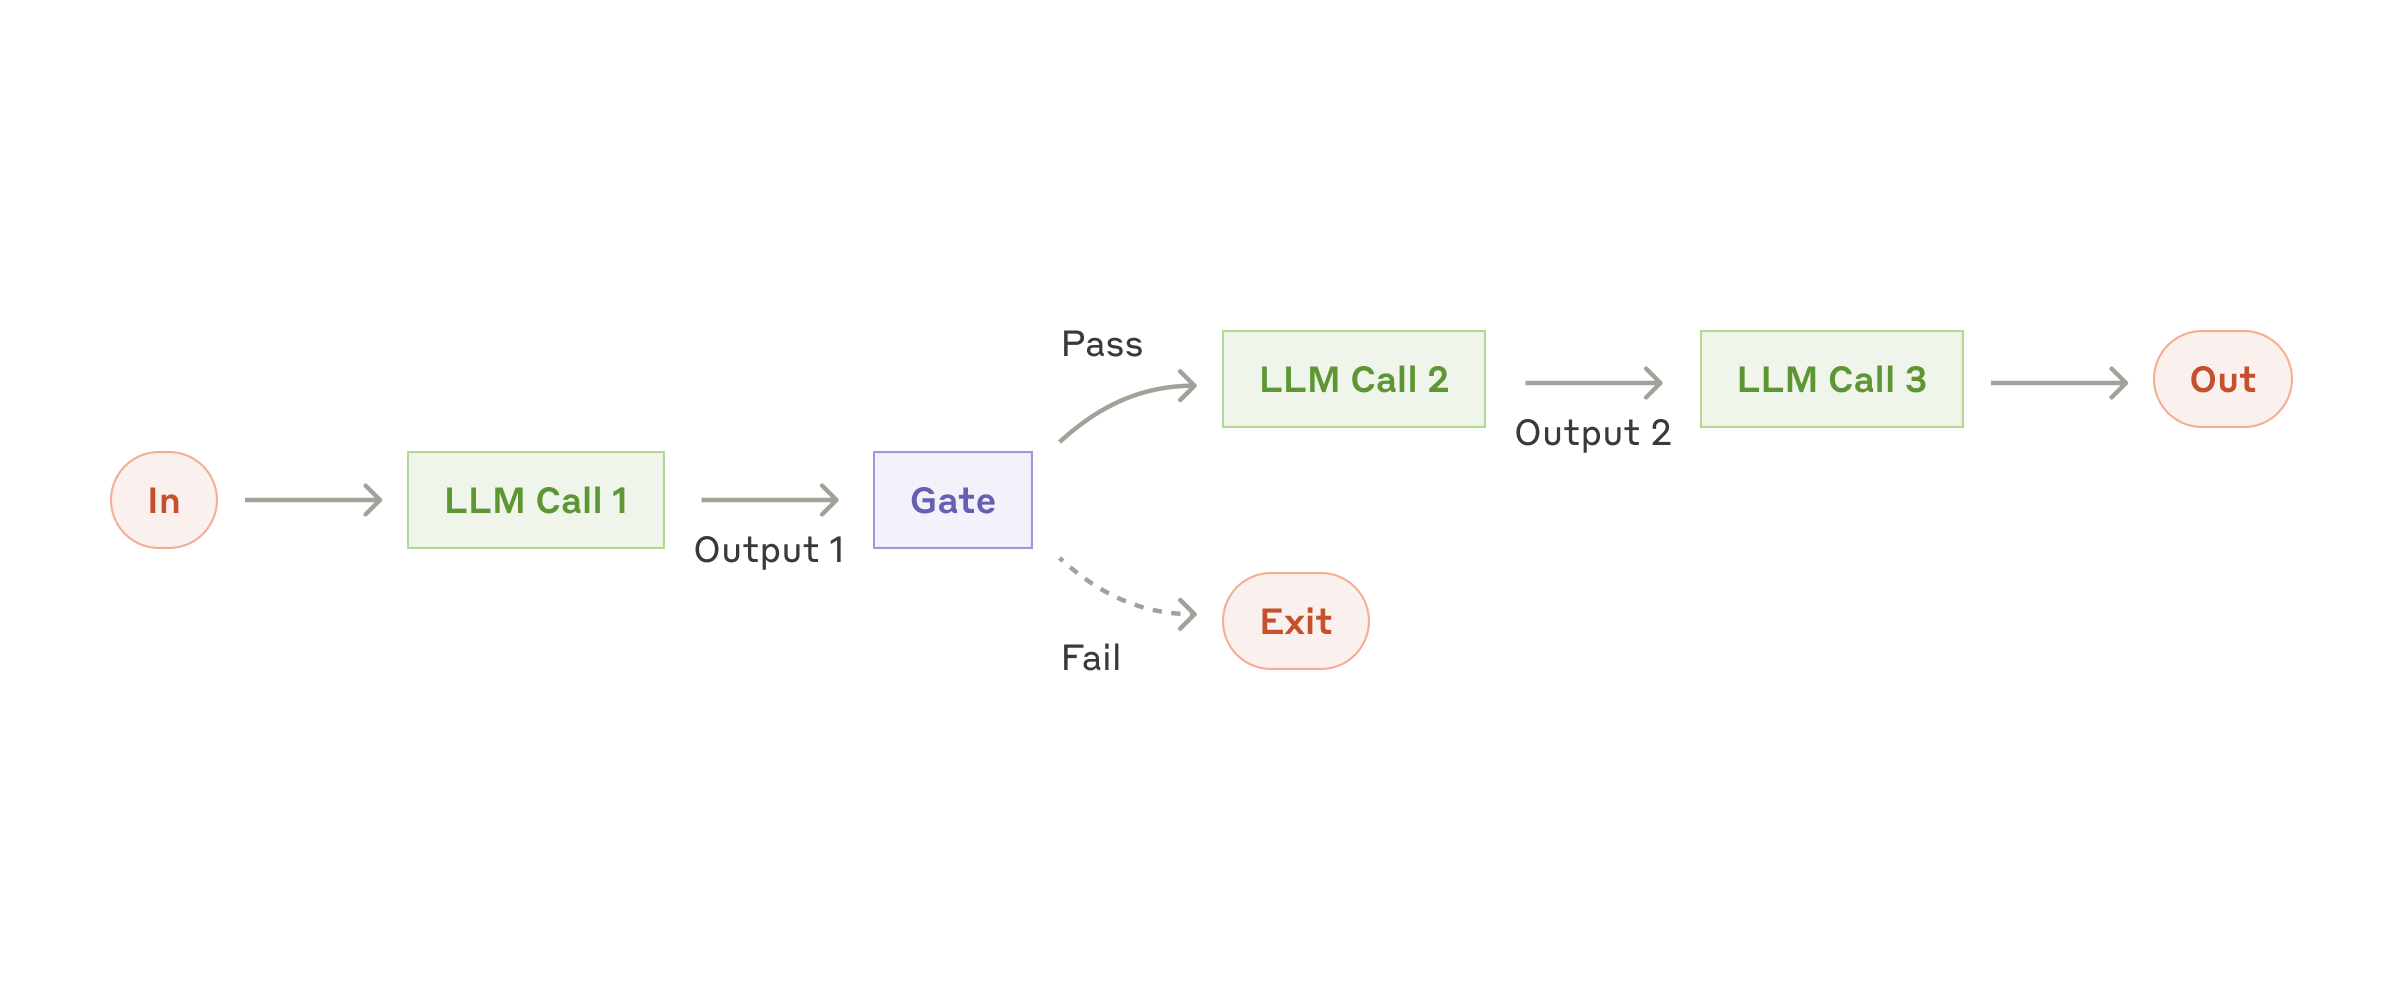
מתי להשתמש בתהליך עבודה זה: תהליך עבודה זה אידיאלי למצבים שבהם ניתן לפרק את המשימה בקלות ובצורה נקייה לתתי-משימות קבועות. המטרה העיקרית היא להחליף השהייה (latency) לדיוק גבוה יותר, על ידי הפיכת כל קריאת LLM למשימה קלה יותר.
דוגמאות שבהן שרשור פרומפטים שימושי:
- יצירת תוכן שיווקי, ולאחר מכן תרגומו לשפה אחרת.
- כתיבת מתווה למסמך, בדיקה שהמתווה עומד בקריטריונים מסוימים, ולאחר מכן כתיבת המסמך על בסיס המתווה.
תהליך עבודה: ניתוב (Routing)
ניתוב מסווג קלט ומכווין אותו למשימת המשך מיוחדת. תהליך עבודה זה מאפשר הפרדת דאגות ובניית פרומפטים ייעודיים יותר. ללא תהליך עבודה זה, אופטימיזציה עבור סוג קלט אחד עלולה לפגוע בביצועים על קלטים אחרים.
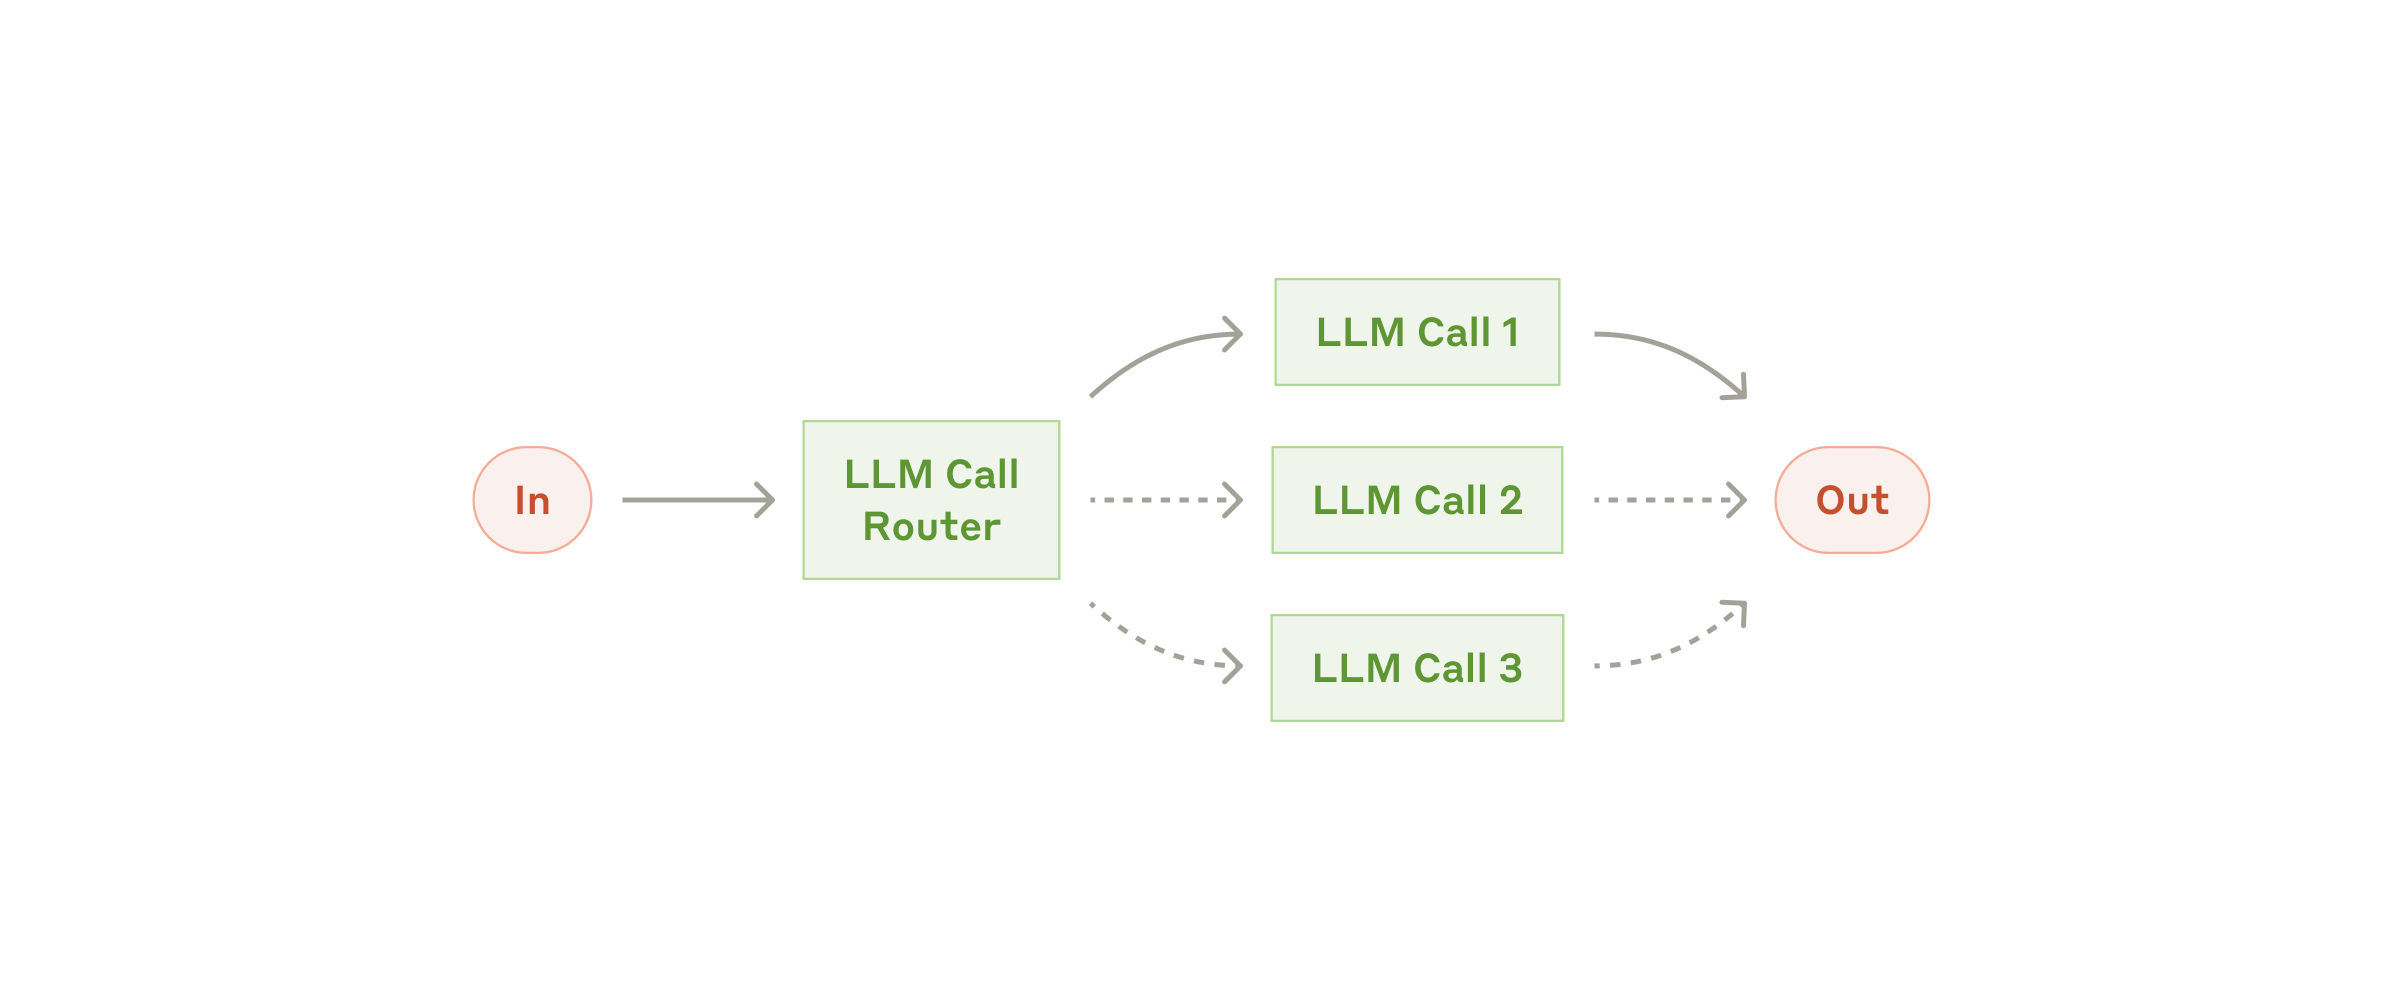
מתי להשתמש בתהליך עבודה זה: ניתוב עובד היטב עבור משימות מורכבות שבהן יש קטגוריות נפרדות המטופלות טוב יותר בנפרד, ושבהן ניתן לטפל בסיווג בצורה מדויקת, בין אם על ידי LLM או מודל/אלגוריתם סיווג מסורתי יותר.
דוגמאות שבהן ניתוב שימושי:
- ניתוב סוגים שונים של שאילתות שירות לקוחות (שאלות כלליות, בקשות להחזר כספי, תמיכה טכנית) לתהליכים, פרומפטים וכלים שונים במורד הזרם.
- ניתוב שאלות קלות/נפוצות למודלים קטנים וחסכוניים כמו Claude Haiku 4.5 ושאלות קשות/חריגות למודלים בעלי יכולת גבוהה יותר כמו Claude Sonnet 4.5 כדי לייעל את הביצועים.
תהליך עבודה: מקביליות (Parallelization)
מודלי LLM יכולים לעיתים לעבוד בו זמנית על משימה ותוצריהם יאוגדו באופן תוכניתי. תהליך עבודה זה, מקביליות (Parallelization), מתבטא בשתי וריאציות עיקריות:
- חלוקה (Sectioning): פירוק משימה לתתי-משימות בלתי תלויות הפועלות במקביל.
- הצבעה (Voting): הרצת אותה משימה מספר פעמים כדי לקבל תפוקות מגוונות.
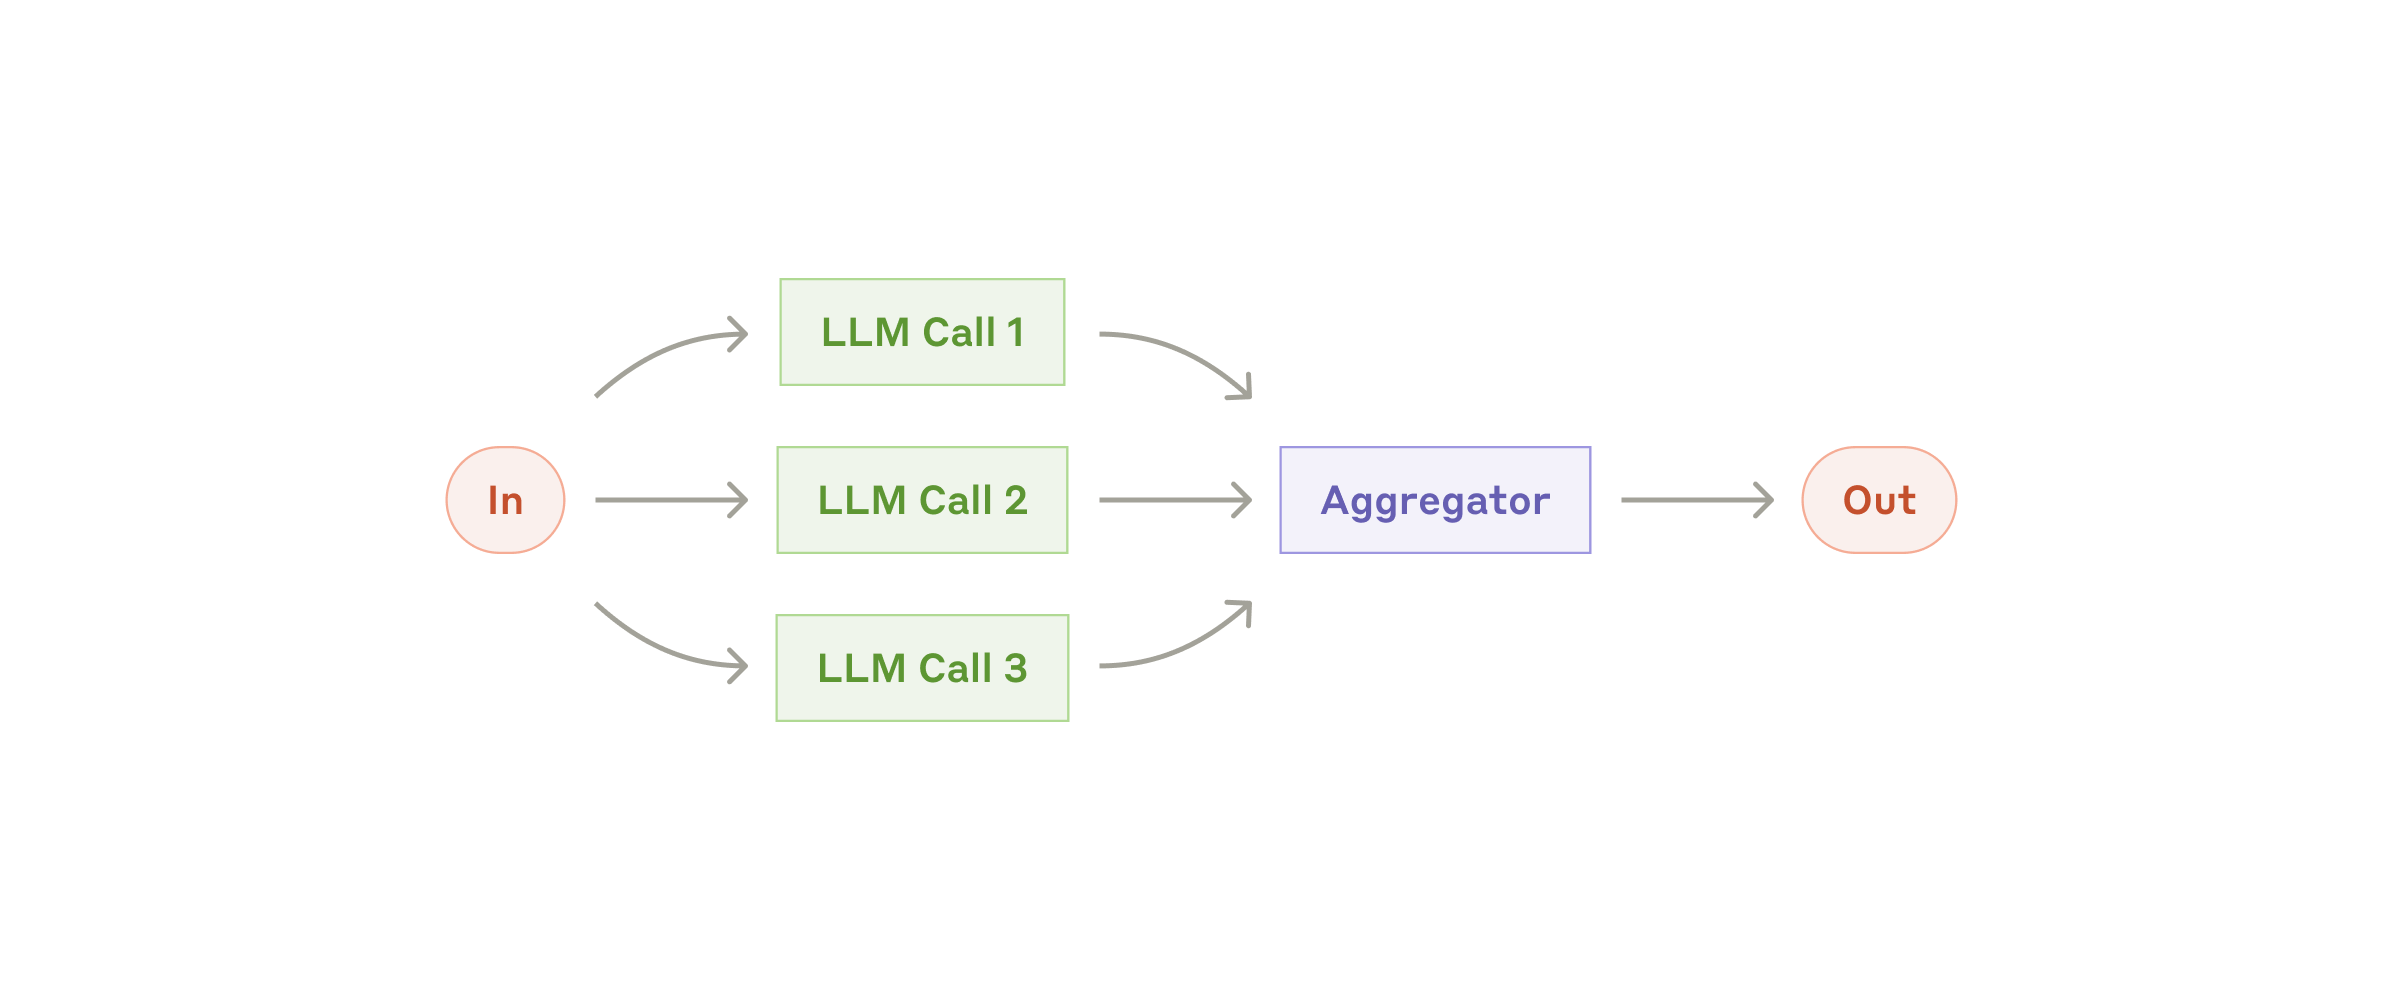
מתי להשתמש בתהליך עבודה זה: מקביליות יעילה כאשר ניתן להריץ את תתי-המשימות המחולקות במקביל לצורך מהירות, או כאשר נדרשות מספר פרספקטיבות או ניסיונות לתוצאות בעלות ביטחון גבוה יותר. עבור משימות מורכבות עם מספר שיקולים, מודלי LLM בדרך כלל מבצעים טוב יותר כאשר כל שיקול מטופל על ידי קריאת LLM נפרדת, מה שמאפשר התמקדות בכל היבט ספציפי.
דוגמאות שבהן מקביליות שימושית:
- חלוקה (Sectioning):
- יישום מנגנוני הגנה (guardrails) שבהם מופע מודל אחד מעבד שאילתות משתמשים בעוד אחר בודק אותם לתוכן או בקשות לא הולמות. זה נוטה לבצע טוב יותר מאשר קריאת LLM אחת המטפלת הן במנגנוני ההגנה והן בתגובת הליבה.
- אוטומציה של הערכות (evals) להערכת ביצועי LLM, שבה כל קריאת LLM מעריכה היבט אחר של ביצועי המודל על פרומפט נתון.
- הצבעה (Voting):
- סקירת קטע קוד לפגיעויות, שבה מספר פרומפטים שונים סוקרים ומסמנים את הקוד אם הם מוצאים בעיה.
- הערכת האם פיסת תוכן נתונה אינה הולמת, עם מספר פרומפטים המעריכים היבטים שונים או דורשים ספים שונים של הצבעות כדי לאזן בין חיוביות ושליליות שגויות.
תהליך עבודה: תזמרן-עובדים (Orchestrator-workers)
בתהליך העבודה של תזמרן-עובדים, מודל LLM מרכזי מפרק באופן דינמי משימות, מפצל אותן למודלי LLM עובדים, ומסנתז את תוצאותיהם.
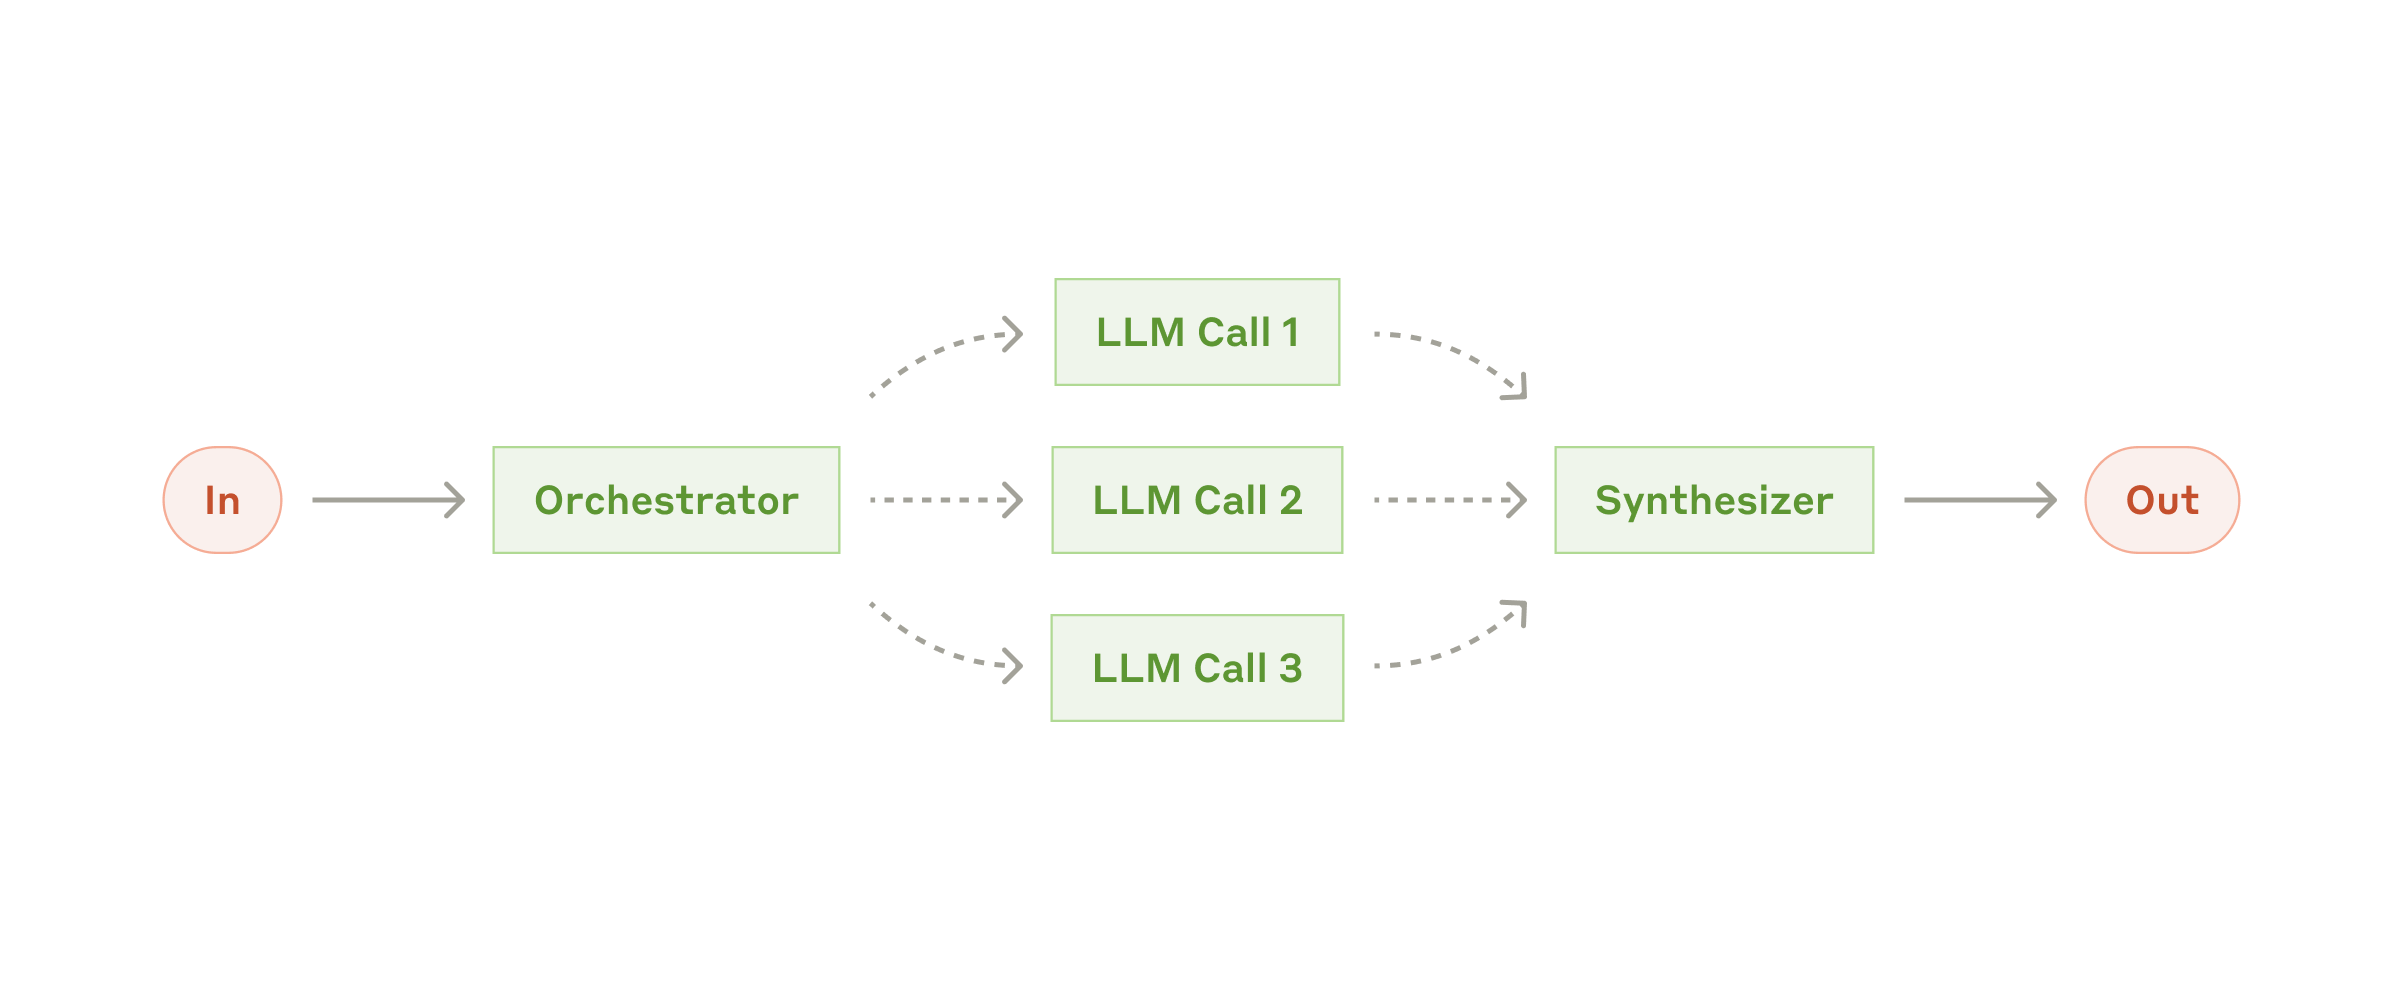
מתי להשתמש בתהליך עבודה זה: תהליך עבודה זה מתאים היטב למשימות מורכבות שבהן אינכם יכולים לחזות את מספר תתי-המשימות הנדרשות (בקידוד, למשל, מספר הקבצים שצריך לשנות ואופי השינוי בכל קובץ תלויים ככל הנראה במשימה). בעוד שהוא דומה טופוגרפית למקביליות, ההבדל המרכזי הוא גמישותו – תתי-משימות אינן מוגדרות מראש, אלא נקבעות על ידי התזמרן על בסיס הקלט הספציפי.
דוגמאות שבהן תזמרן-עובדים שימושי:
- מוצרי קידוד שמבצעים שינויים מורכבים במספר קבצים בכל פעם.
- משימות חיפוש הכרוכות באיסוף וניתוח מידע ממספר מקורות עבור מידע רלוונטי אפשרי.
תהליך עבודה: מעריך-מייעל (Evaluator-optimizer)
בתהליך העבודה של מעריך-מייעל, קריאת LLM אחת מייצרת תגובה בעוד אחרת מספקת הערכה ומשוב בלולאה.
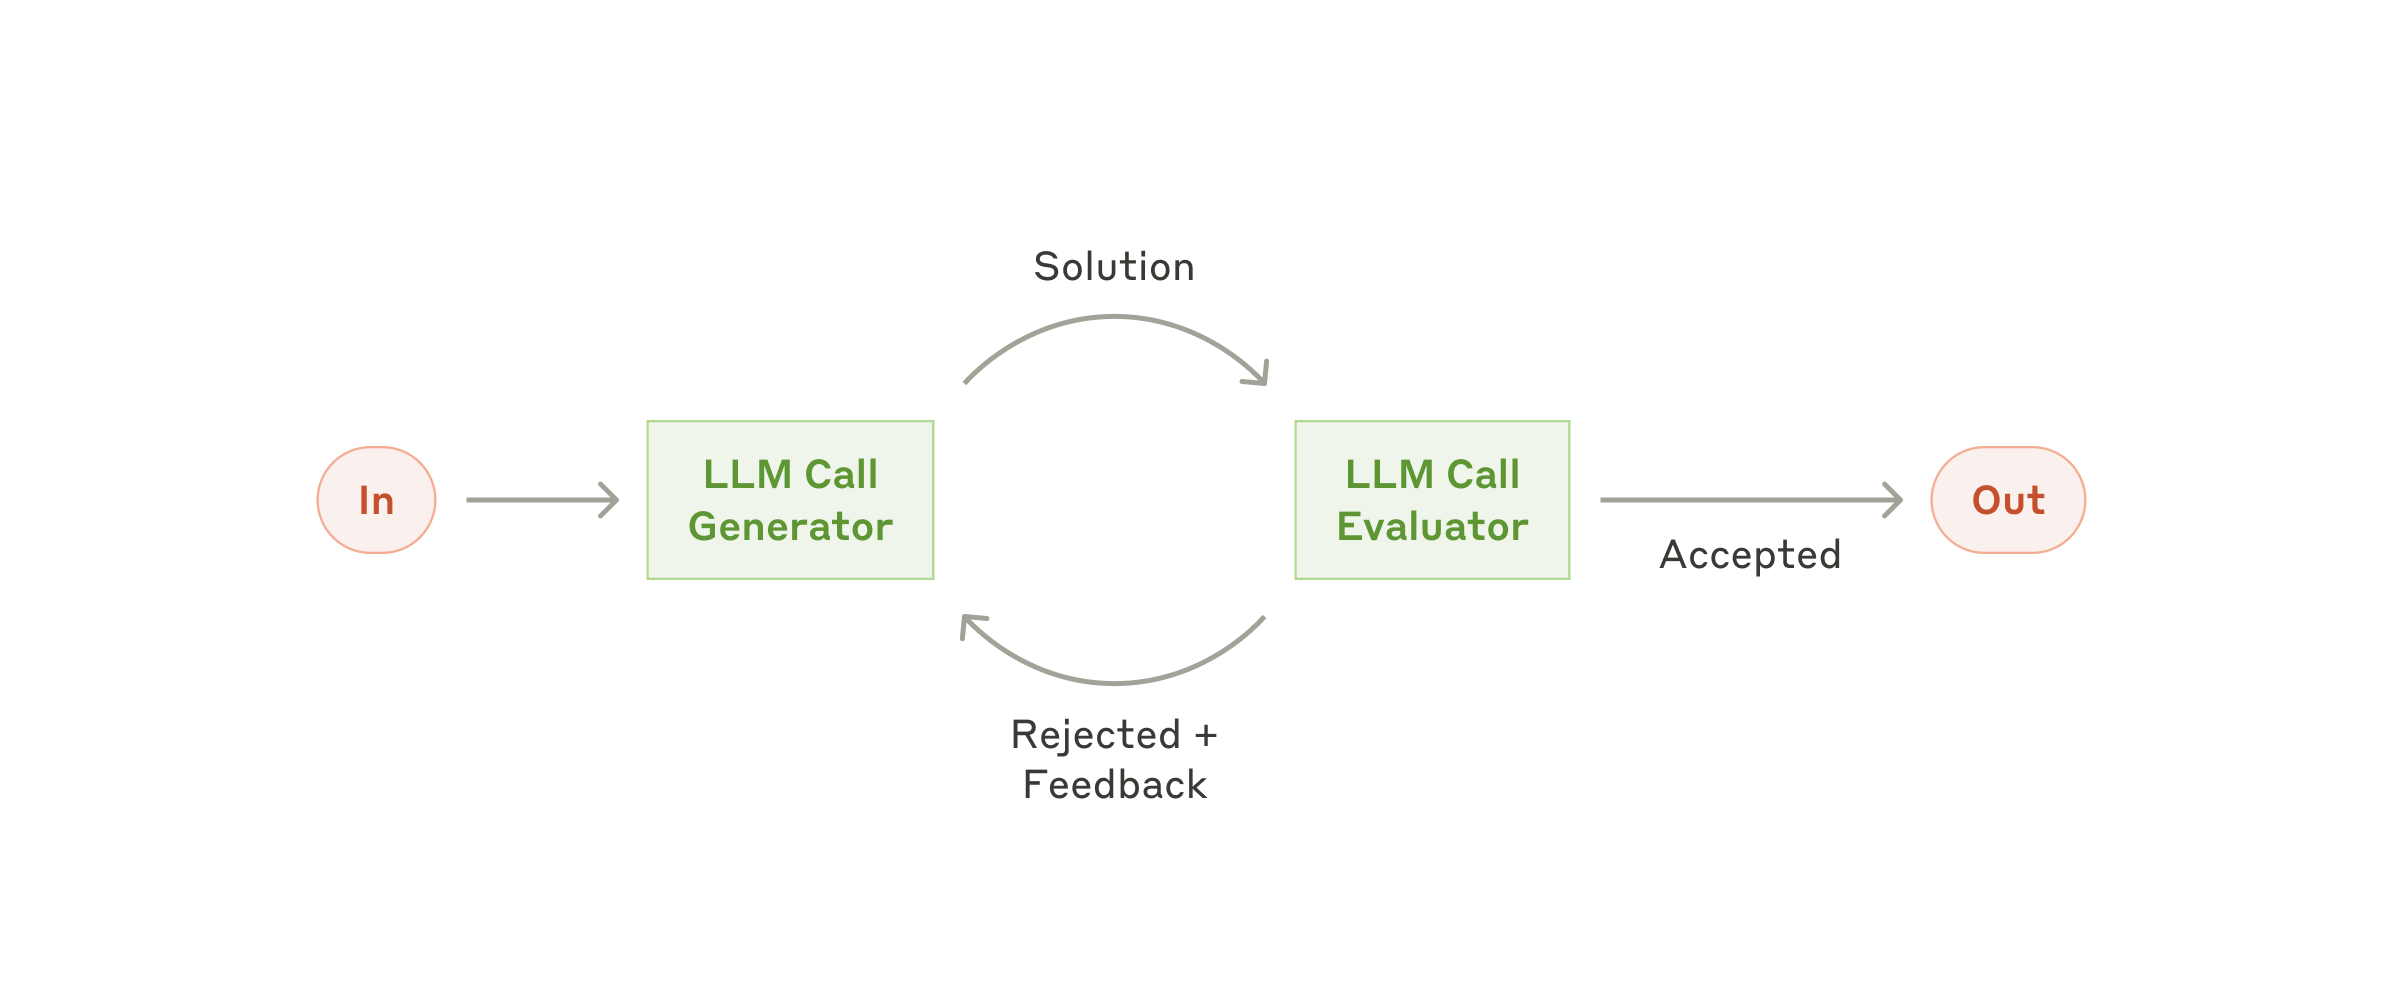
מתי להשתמש בתהליך עבודה זה: תהליך עבודה זה יעיל במיוחד כאשר יש לנו קריטריוני הערכה ברורים, וכאשר שיפור איטרטיבי מספק ערך מדיד. שני סימנים להתאמה טובה הם, ראשית, שתגובות LLM ניתנות לשיפור באופן מובהק כאשר אדם מביע את משובו; ושנית, שמודל ה-LLM יכול לספק משוב כזה. זה אנלוגי לתהליך הכתיבה האיטרטיבי שעשוי לעבור כותב אנושי בעת הפקת מסמך מלוטש.
דוגמאות שבהן מעריך-מייעל שימושי:
- תרגום ספרותי שבו יש ניואנסים שמודל ה-LLM המתרגם עשוי לא לקלוט בתחילה, אך שבו מודל LLM מעריך יכול לספק ביקורות שימושיות.
- משימות חיפוש מורכבות הדורשות סבבים מרובים של חיפוש וניתוח כדי לאסוף מידע מקיף, שבהן המעריך מחליט אם יש צורך בחיפושים נוספים.
סוכנים (Agents)
סוכנים מתחילים לצוץ בייצור ככל שמודלי LLM מתבגרים ביכולות מפתח – הבנת קלטים מורכבים, עיסוק בחשיבה ותכנון, שימוש אמין בכלים, והתאוששות משגיאות. סוכנים מתחילים את עבודתם בפקודה, או דיון אינטראקטיבי, עם המשתמש האנושי. ברגע שהמשימה ברורה, סוכנים מתכננים ופועלים באופן עצמאי, ואף עשויים לחזור למשתמש האנושי לקבלת מידע או שיקול דעת נוספים. במהלך הביצוע, חיוני שהסוכנים יקבלו "אמת יסוד" (ground truth) מהסביבה בכל שלב (כגון תוצאות קריאת כלי או ביצוע קוד) כדי להעריך את התקדמותם. סוכנים יכולים אז לעצור לקבלת משוב אנושי בנקודות בדיקה או כאשר הם נתקלים בחסימות. המשימה מסתיימת לעיתים קרובות עם השלמתה, אך נפוץ גם לכלול תנאי עצירה (כגון מספר איטרציות מקסימלי) כדי לשמור על שליטה.
סוכנים יכולים להתמודד עם משימות מתוחכמות, אך יישומם לרוב פשוט. הם בדרך כלל רק מודלי LLM המשתמשים בכלים על בסיס משוב סביבתי בלולאה. לכן, חיוני לתכנן מערכי כלים ותיעודם בצורה ברורה ומתחשבת. אנו מרחיבים על שיטות עבודה מומלצות לפיתוח כלים בנספח 2 ("הנדסת פרומפטים לכלים שלכם").
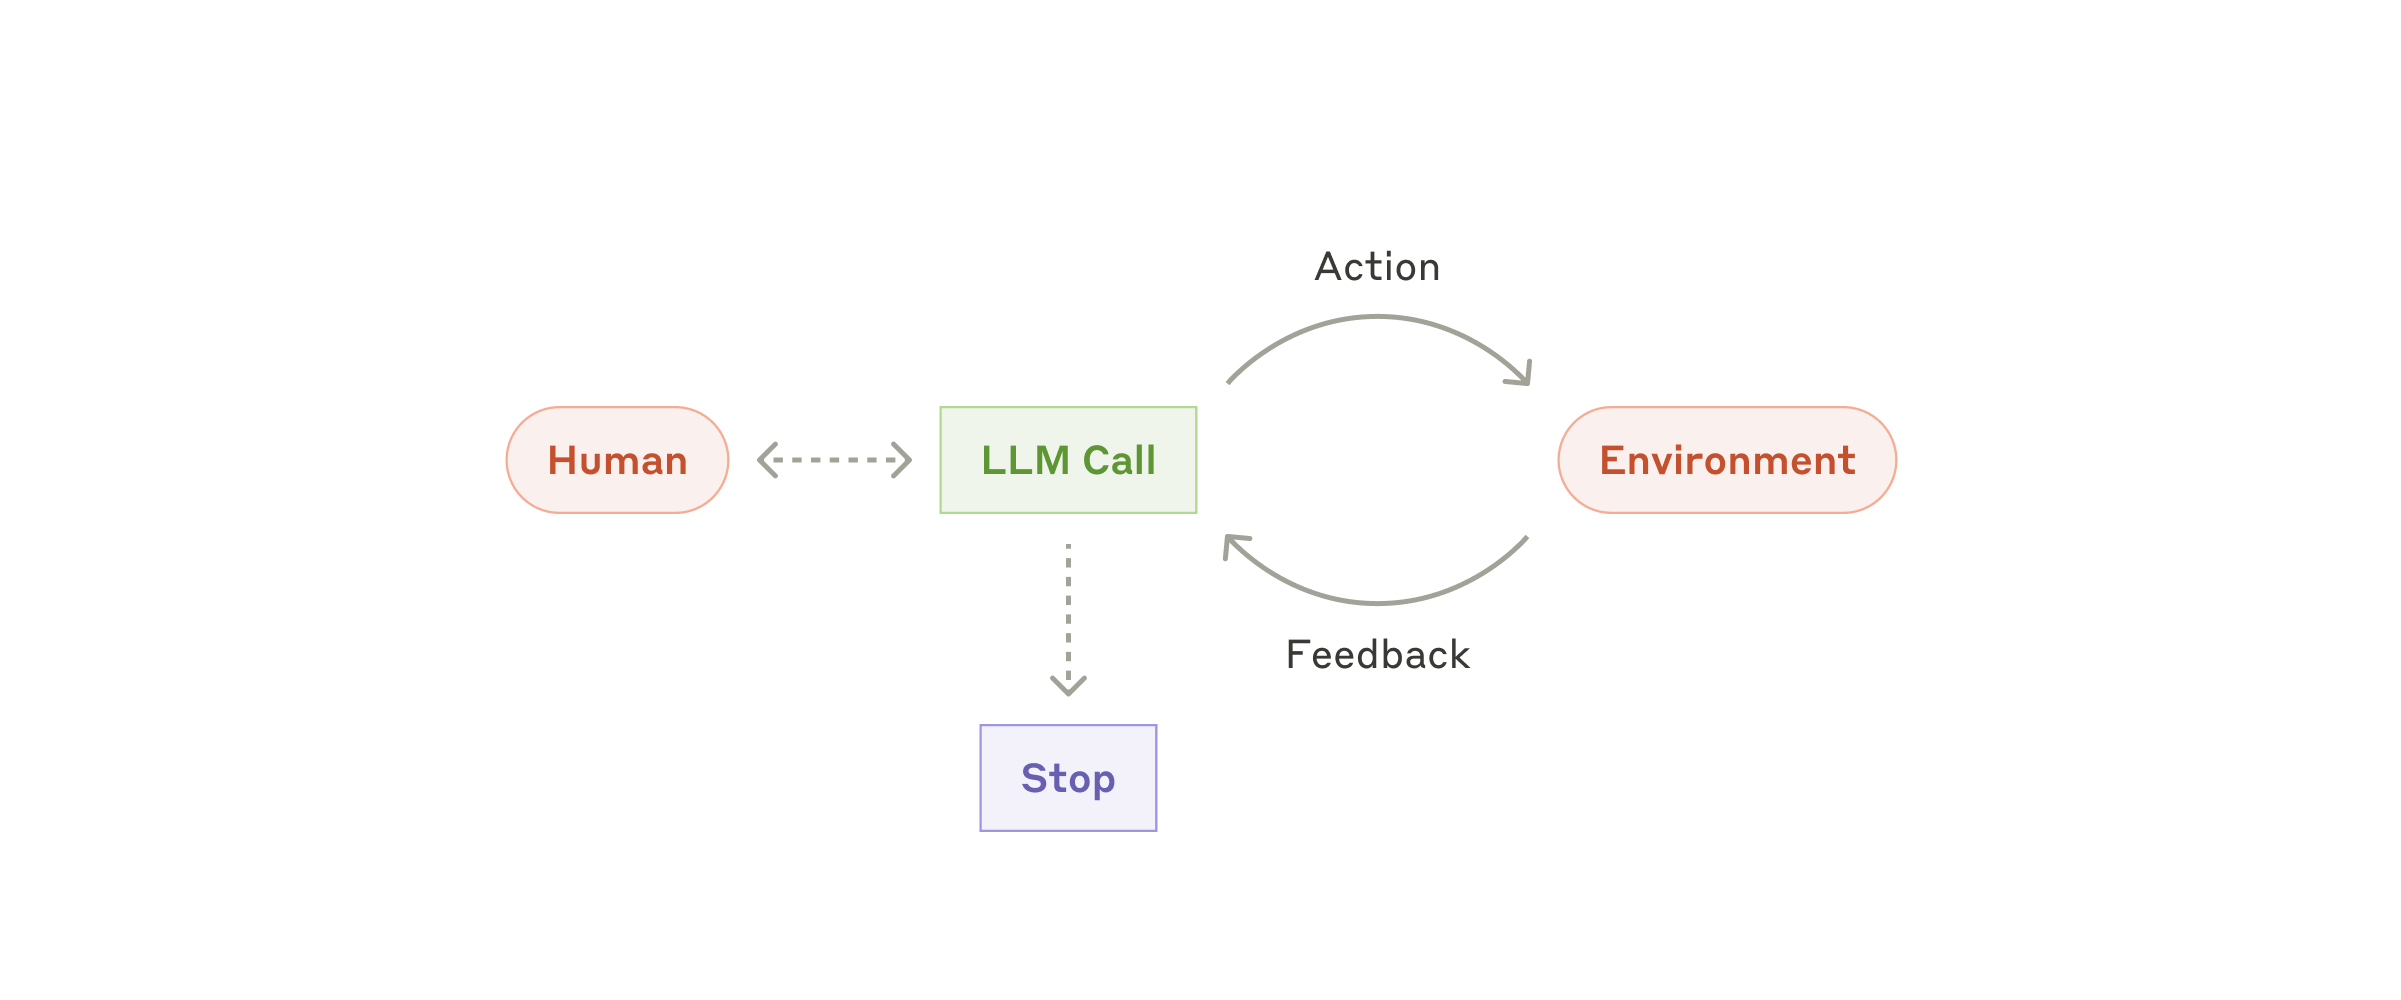
מתי להשתמש בסוכנים: סוכנים יכולים לשמש לבעיות פתוחות שבהן קשה או בלתי אפשרי לחזות את מספר הצעדים הנדרשים, ושבהן לא ניתן לקודד נתיב קבוע מראש. מודל ה-LLM יפעל ככל הנראה במשך תורות רבות, ועליכם לסמוך במידה מסוימת על קבלת ההחלטות שלו. האוטונומיה של סוכנים הופכת אותם לאידיאליים להרחבת משימות בסביבות מהימנות.
האופי האוטונומי של סוכנים מביא לעלויות גבוהות יותר, ופוטנציאל לשגיאות מצטברות. אנו ממליצים על בדיקות נרחבות בסביבות ארגז חול (sandboxed environments), יחד עם מנגנוני ההגנה המתאימים.
דוגמאות שבהן סוכנים שימושיים:
הדוגמאות הבאות הן מיישומים שלנו:
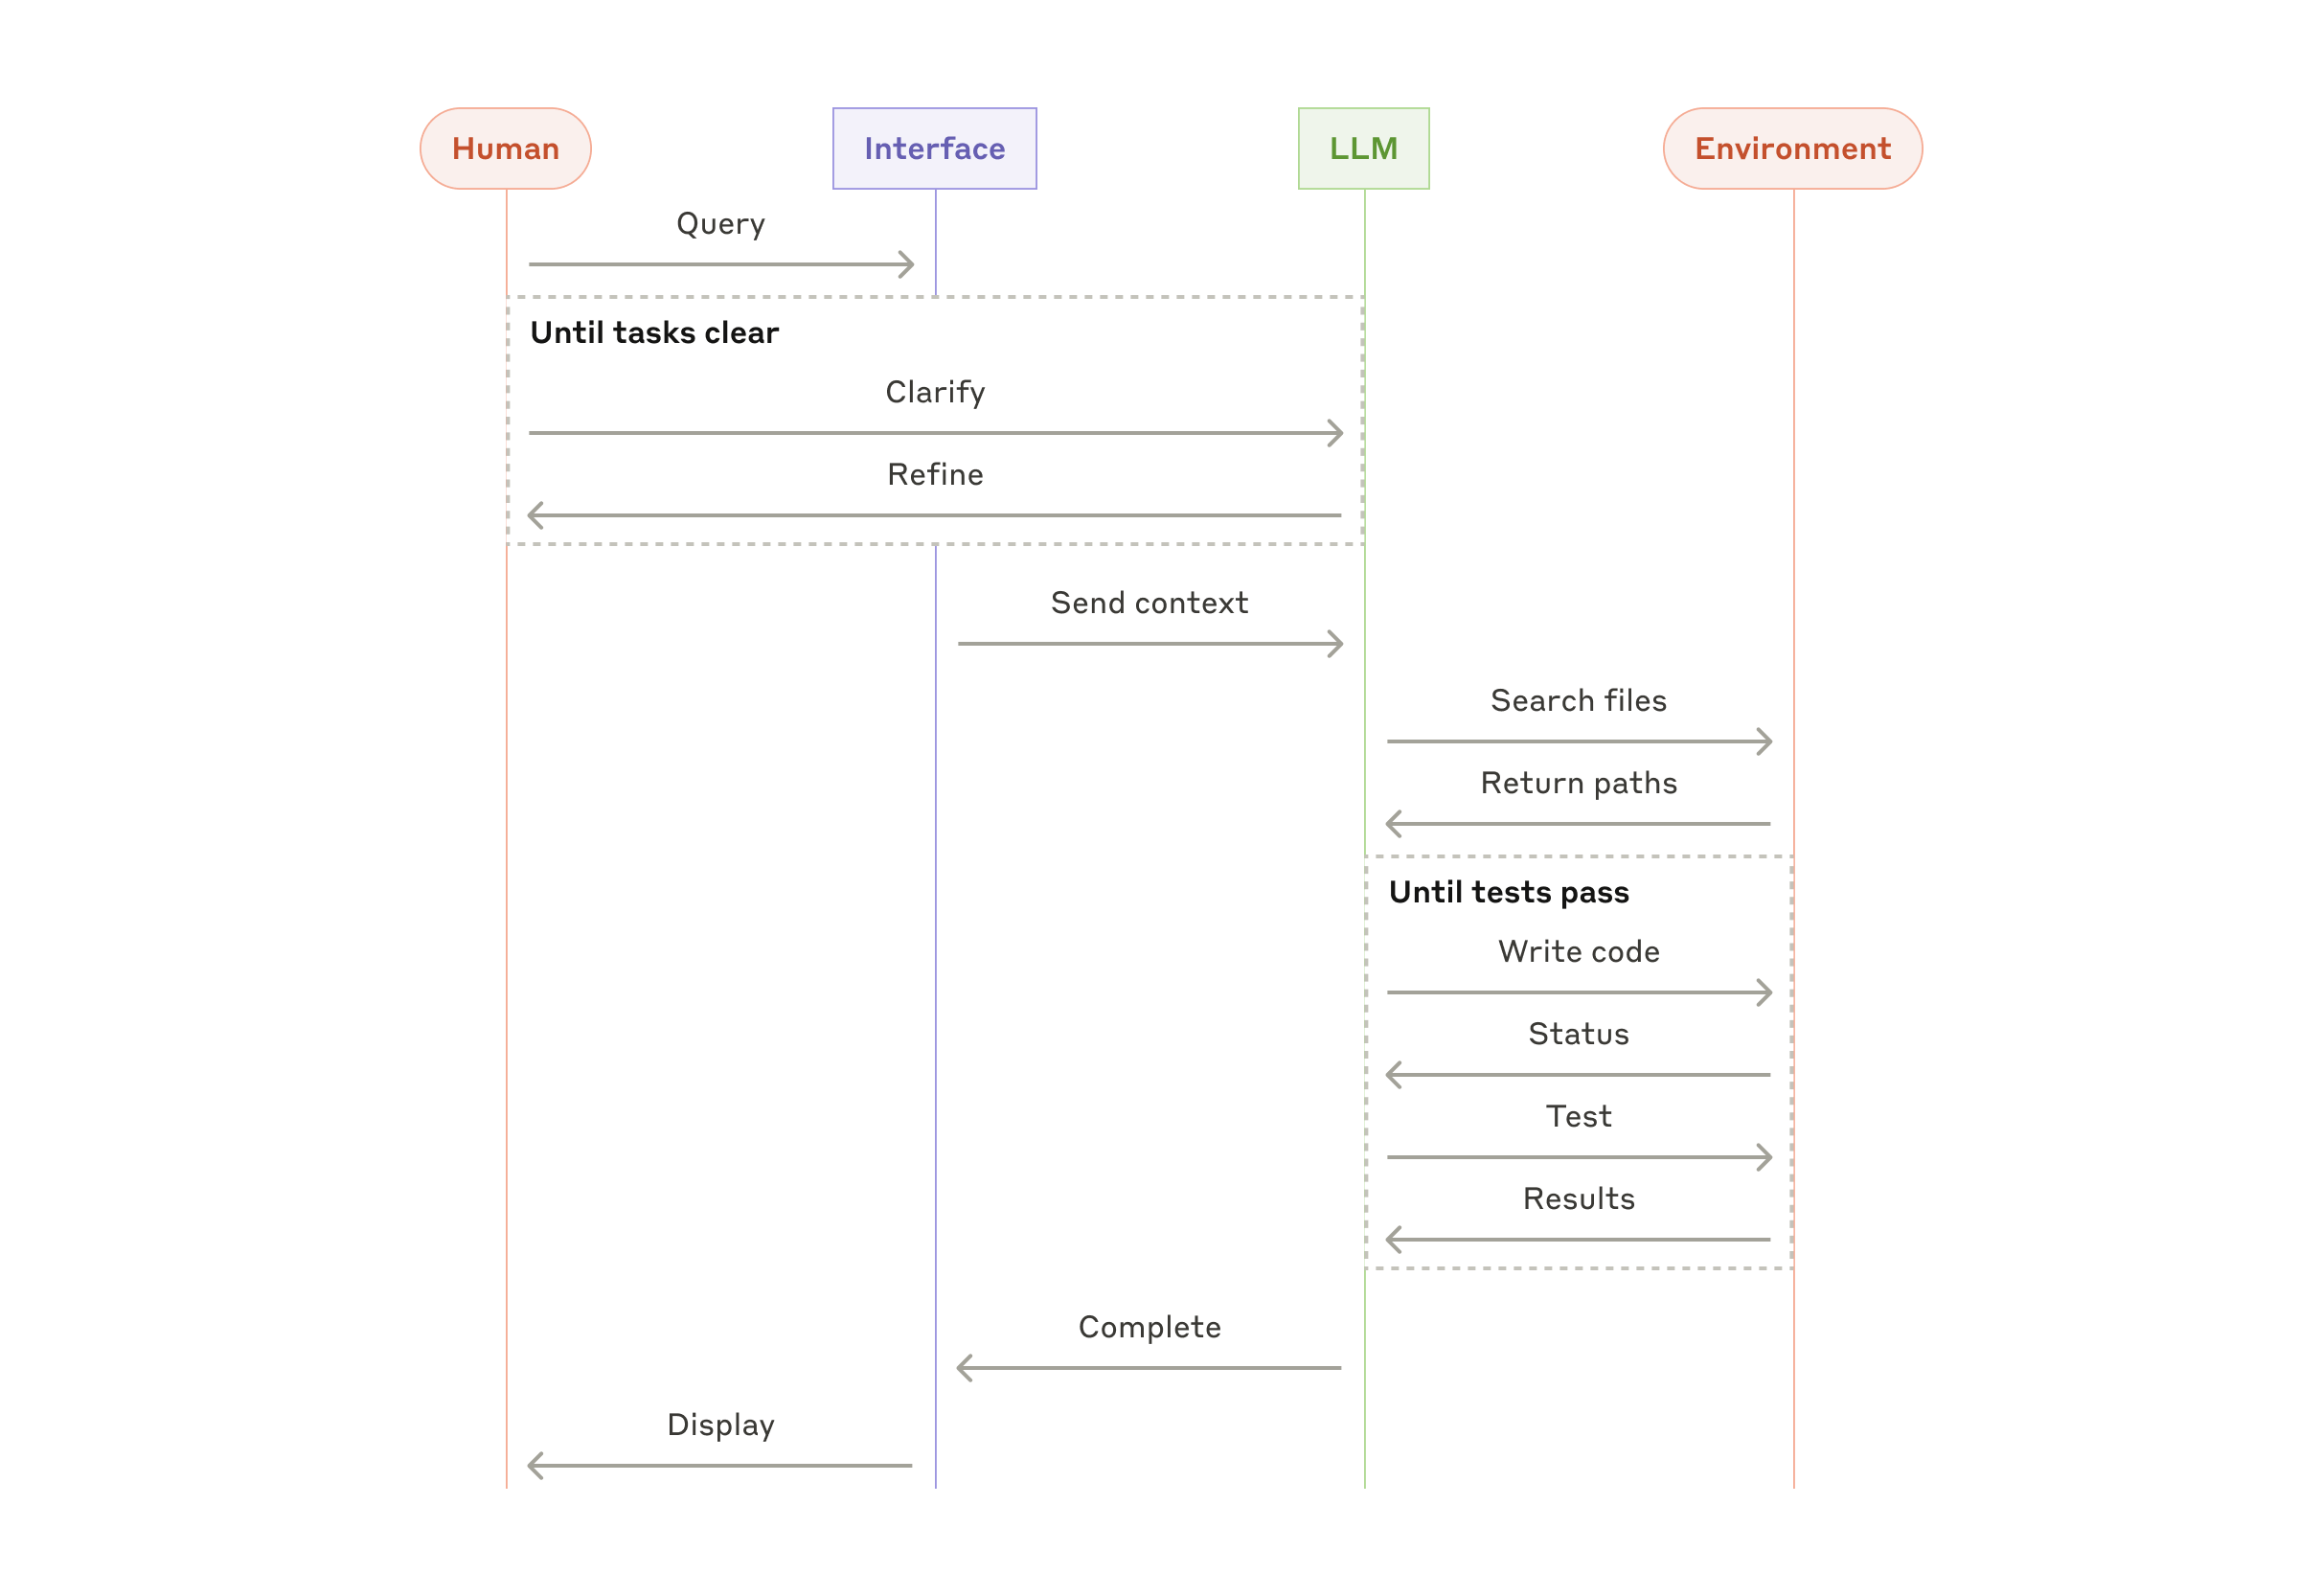
- סוכן קידוד לפתרון משימות SWE-bench, הכוללות עריכות בקבצים רבים על בסיס תיאור משימה;
- יישום הייחוס שלנו "שימוש במחשב", שבו Claude משתמש במחשב לביצוע משימות.
שילוב והתאמה אישית של תבניות אלו
אבני בניין אלו אינן קבועות מראש. הן תבניות נפוצות שמפתחים יכולים לעצב ולשלב כדי להתאים למקרי שימוש שונים. המפתח להצלחה, כמו בכל תכונות LLM, הוא מדידת ביצועים ואיטרציה על יישומים. נחזור ונדגיש: עליכם לשקול הוספת מורכבות רק כאשר היא משפרת תוצאות באופן מובהק.
סיכום
הצלחה בתחום מודלי ה-LLM אינה קשורה לבניית המערכת המתוחכמת ביותר, אלא לבניית המערכת הנכונה לצרכים שלכם. התחילו עם פרומפטים פשוטים, בצעו להם אופטימיזציה עם הערכה מקיפה, והוסיפו מערכות סוכני מרובות צעדים רק כאשר פתרונות פשוטים יותר אינם מספקים.
בעת יישום סוכנים, אנו מנסים לפעול לפי שלושה עקרונות ליבה:
- שמרו על פשטות בעיצוב הסוכן שלכם.
- תנו עדיפות לשקיפות על ידי הצגת שלבי התכנון של הסוכן במפורש.
- עצבו בקפידה את ממשק הסוכן-מחשב (ACI) שלכם באמצעות תיעוד ובדיקות יסודיים של הכלים.
פריימוורקים יכולים לעזור לכם להתחיל במהירות, אך אל תהססו להפחית שכבות הפשטה ולבנות עם רכיבים בסיסיים ככל שתתקדמו לייצור. על ידי שמירה על עקרונות אלו, תוכלו ליצור סוכנים שהם לא רק חזקים אלא גם אמינים, ניתנים לתחזוקה ומהימנים על ידי המשתמשים שלהם.
תודות
נכתב על ידי אריק ס. ובארי זאנג. עבודה זו שואבת מניסיוננו בבניית סוכנים באנתרופיק ומהתובנות החשובות ששיתפו לקוחותינו, להם אנו אסירי תודה עמוקה.
נספח 1: סוכנים בפועל
עבודתנו עם לקוחות חשפה שתי יישומים מבטיחים במיוחד לסוכני AI המדגימים את הערך המעשי של התבניות שנדונו לעיל. שני היישומים ממחישים כיצד סוכנים מוסיפים את הערך הרב ביותר עבור משימות הדורשות הן שיחה והן פעולה, בעלות קריטריוני הצלחה ברורים, מאפשרות לולאות משוב, ומשלבות פיקוח אנושי משמעותי.
א. תמיכת לקוחות
תמיכת לקוחות משלבת ממשקי צ'אטבוט מוכרים עם יכולות משופרות באמצעות שילוב כלים. זוהי התאמה טבעית לסוכנים פתוחים יותר מכיוון ש:
- אינטראקציות תמיכה עוקבות באופן טבעי אחר זרימת שיחה תוך דרישה לגישה למידע ופעולות חיצוניים;
- ניתן לשלב כלים כדי לשלוף נתוני לקוחות, היסטוריית הזמנות ומאמרי בסיס ידע;
- פעולות כגון הנפקת החזרים כספיים או עדכון כרטיסים יכולות להיטפל באופן תוכניתי; ו-
- הצלחה ניתנת למדידה ברורה באמצעות פתרונות מוגדרים על ידי המשתמש.
מספר חברות הדגימו את כדאיות גישה זו באמצעות מודלים של תמחור מבוסס שימוש, הגובים תשלום רק עבור פתרונות מוצלחים, מה שמראה ביטחון ביעילות הסוכנים שלהן.
ב. סוכני קידוד
תחום פיתוח התוכנה הראה פוטנציאל יוצא דופן עבור תכונות LLM, כאשר היכולות מתפתחות מהשלמת קוד ועד לפתרון בעיות אוטונומי. סוכנים יעילים במיוחד מכיוון ש:
- פתרונות קוד ניתנים לאימות באמצעות בדיקות אוטומטיות;
- סוכנים יכולים לבצע איטרציות על פתרונות באמצעות תוצאות בדיקה כמשוב;
- מרחב הבעיה מוגדר ומובנה היטב; ו-
- איכות התפוקה ניתנת למדידה אובייקטיבית.
ביישום שלנו, סוכנים יכולים כעת לפתור בעיות GitHub אמיתיות במדד SWE-bench Verified בהתבסס על תיאור ה-pull request בלבד. עם זאת, בעוד שבדיקות אוטומטיות עוזרות לוודא פונקציונליות, סקירה אנושית נשארת חיונית להבטחת התאמת הפתרונות לדרישות המערכת הרחבות יותר.
נספח 2: הנדסת פרומפטים לכלים שלכם
לא משנה איזו מערכת סוכני אתם בונים, כלים ככל הנראה יהיו חלק חשוב מהסוכן שלכם. כלים מאפשרים ל-Claude ליצור אינטראקציה עם שירותים חיצוניים ו-API על ידי ציון המבנה וההגדרה המדויקים שלהם ב-API שלנו. כאשר Claude מגיב, הוא יכלול בלוק של שימוש בכלים בתגובת ה-API אם הוא מתכנן להפעיל כלי. הגדרות ומפרטי כלים צריכים לקבל תשומת לב הנדסית זהה לזו של הפרומפטים הכלליים שלכם. בנספח קצר זה, אנו מתארים כיצד להנדס פרומפטים עבור הכלים שלכם.
לעתים קרובות ישנן מספר דרכים לציין אותה פעולה. למשל, ניתן לציין עריכת קובץ על ידי כתיבת diff, או על ידי כתיבה מחדש של הקובץ כולו. עבור פלט מובנה, ניתן להחזיר קוד בתוך markdown או בתוך JSON. בהנדסת תוכנה, הבדלים כאלה הם קוסמטיים וניתנים להמרה ללא אובדן מפורמט אחד לאחר. עם זאת, פורמטים מסוימים קשים בהרבה למודל LLM לכתוב מאחרים. כתיבת diff דורשת ידיעה של מספר השורות המשתנות בכותרת הנתח לפני כתיבת הקוד החדש. כתיבת קוד בתוך JSON (לעומת markdown) דורשת בריחה (escaping) נוספת של שורות חדשות וגרשיים.
ההצעות שלנו להחלטה על פורמטים של כלים הן כדלקמן:
- תנו למודל מספיק טוקנים "לחשוב" לפני שהוא מכניס את עצמו לפינה.
- שמרו על הפורמט קרוב למה שהמודל ראה מתרחש באופן טבעי בטקסט באינטרנט.
- ודאו שאין "תקורת" עיצוב כגון צורך לשמור על ספירה מדויקת של אלפי שורות קוד, או בריחת מחרוזות (string-escaping) של כל קוד שהוא כותב.
כלל אצבע אחד הוא לחשוב כמה מאמץ מושקע בממשקי אדם-מחשב (HCI), ולתכנן להשקיע בדיוק אותו מאמץ ביצירת ממשקי סוכן-מחשב (ACI) טובים. הנה כמה מחשבות כיצד לעשות זאת:
- שימו את עצמכם בנעלי המודל. האם ברור כיצד להשתמש בכלי זה, בהתבסס על התיאור והפרמטרים, או שתצטרכו לחשוב עליו היטב? אם כן, אז זה כנראה נכון גם עבור המודל. הגדרת כלי טובה כוללת לעיתים קרובות דוגמאות שימוש, מקרי קצה, דרישות פורמט קלט, וגבולות ברורים מכלים אחרים.
- כיצד תוכלו לשנות שמות פרמטרים או תיאורים כדי להפוך את הדברים לברורים יותר? חשבו על זה כעל כתיבת docstring מעולה למפתח ג'וניור בצוות שלכם. זה חשוב במיוחד בעת שימוש בכלים דומים רבים.
- בדקו כיצד המודל משתמש בכלים שלכם: הריצו דוגמאות קלט רבות ב-Workbench שלנו כדי לראות אילו טעויות המודל עושה, ובצעו איטרציות.
- בצעו Poka-yoke לכלים שלכם. שנו את הארגומנטים כך שיהיה קשה יותר לעשות טעויות.
בעת בניית הסוכן שלנו עבור SWE-bench, למעשה הקדשנו יותר זמן לאופטימיזציה של הכלים שלנו מאשר לפרומפט הכללי. לדוגמה, מצאנו שהמודל היה עושה טעויות עם כלים המשתמשים בנתיבי קבצים יחסיים לאחר שהסוכן יצא מספריית השורש. כדי לתקן זאת, שינינו את הכלי כך שידרוש תמיד נתיבי קבצים מוחלטים – ומצאנו שהמודל השתמש בשיטה זו ללא דופי.