האם קלוד יכול להיות מדען? מבחן BioMysteryBench מגלה | Anthropic IL
מחקר
האם קלוד יכול להיות מדען? מבחן BioMysteryBench מגלה
14 דקות קריאה
בקצרה
חברת אנתרופיק (Anthropic) הציגה לאחרונה את BioMysteryBench, מדד ביצועים חדשני המעריך את יכולות המחקר הביו-אינפורמטי של מודלי ה-AI שלה, קלוד (Claude), במשימות מורכבות בעולם האמיתי. המחקר מגלה כי קלוד מציג שיפור משמעותי מדור לדור, משתווה למומחים אנושיים ואף עולה עליהם בחלק מהאתגרים, תוך שימוש באסטרטגיות ייחודיות המשלבות בסיס ידע עצום וגישה מרובת שיטות. BioMysteryBench מאפשר להעריך את ה-AI גם במשימות שקשות או בלתי אפשריות לבני אדם, ומציב את קלוד בחזית המחקר המדעי.
שתפו את הכתבה
שיתוף
בפוסט זה, בריאנה, חוקרת בצוות הגילוי של אנתרופיק, משתפת בתוצאות ממאמץ בנצ'מרקינג ביו-אינפורמטי עדכני.
ברגע שמודלי שפה גדולים (LLM) יכלו לנהל שיחה, אנשים החלו לשאול כיצד הם יתמודדו מול מומחים אנושיים. האם מודלים יוכלו לעבור את בחינת הלשכה? האם הם יוכלו לענות על שאלות רישוי רפואי, או לפתור בעיות מתמטיקה מהאולימפיאדה? מדדי ביצועים כאלה – אוספים סגורים של בעיות שנבדקו על ידי מומחים אנושיים, שנועדו להעריך יכולת מסוימת של מודל – הפכו למקור תחרות בין מפתחי AI, המדווחים בכרטיסי מערכת של השקות מודלים ונצפים בלוחותמוביליםרבים מקוונים.
מעבר לתחרות, מדדי ביצועים עוזרים לנו להתמודד עם שאלה חשובה: האם מודלים מסוגלים ואמינים מספיק כדי לתמוך, או אף לייצר, עבודה ברמה מקצועית? מדענים משתמשים במודלים כדי לכתוב קוד עבור צינורות עיבוד נתונים, להציע השערות ולהסיק מסקנות מנתונים, במטרה ארוכת טווח של האצת חדשנות ותגליות. אבל עד כמה ה-AI מיומן במדע כרגע, ובאיזו מהירות קלוד ומודלים אחרים משתפרים?
כדי לענות על כך, קהילת המחקר בנתה מספר מדדי ביצועים. MMLU-Pro בודק ידע ברמת מומחה ושאלות חשיבה. GPQA מציג שאלות ברמת בוגר תואר שני, "חסינות לגוגל" בביולוגיה, פיזיקה וכימיה. LAB-Bench בודק עבודת ידע ספציפית לביולוגיה – קריאת ספרות, פרשנות איורים, הסקה לגבי פרוטוקולים. למרות שמדדי ביצועים אלה פותחו בעידן ה"צ'אטבוט", הם נשמרו גם בעידן הסוכנים (agent) ושימוש בכלים, והצטרפו אליהם הערכות חשיבה מדעית קשות עוד יותר כמו FrontierScience ו-Humanity's Last Exam, מכיוון שידע וחשיבה נשארים מדד חיוני ליכולת מדעית.
עם זאת, משימות מדעיות רבות בעולם האמיתי דורשות יותר מכך. הן מצריכות קריאת מאמרים, שליפת מידע ממאגרי נתונים, ביצוע ניסויים, קידוד וניתוח. כעת, כשהמודלים יכולים לעשות רבות מהפעולות הללו, מדדי הביצועים התפתחו כדי לשקף את זרימות העבודה הללו. BLADE מטיל על מודל מערך נתונים ומשימה פתוחה, ובודק אם המודל נוקט בצעדי ניתוח דומים למדען אנושי. BixBench משתמש במערכי נתונים ביולוגיים, ומדרג מודלים לפי מידת התאמת מסקנותיהם לאלו של מדענים. ב-SciGym, המודל מושלך למעבדת ביולוגיה מדומה, שם עליו לתכנן ולבצע ניסויים משלו כדי לחשוף מנגנון נסתר.
מדדי ביצועים אלה מקרבים אותנו למדידת יכולת מדעית, אך הם אינם בודקים באופן מלא אם מודל יכול להמציא פתרונות יצירתיים לבעיות המבולגנות והפתוחות המאפיינות מחקר. זו הסיבה שפיתחנו את BioMysteryBench, מדד ביצועים ביו-אינפורמטי שמטיל על קלוד ניתוח מערכי נתונים מהעולם האמיתי, תוך התמודדות עם חלק מהאתגרים הטבועים בהערכת מערכות ביולוגיות מורכבות ורועשות. למדנו כי היכולות המדעיות של קלוד בביולוגיה משתפרות במהירות בין דורות, שדגמים נוכחיים מתפקדים בדומה למומחים אנושיים, ושדורות המודלים האחרונים פתרו בעיות רבות שפאנל של מומחים אנושיים לא הצליח, לעיתים באמצעות אסטרטגיות שונות לחלוטין.
המדע מאתגר, וכך גם הערכתו
לרופאים יש מבחני הסמכה ולעורכי דין יש את בחינת הלשכה, אך אין מבחן סטנדרטי להפיכה למדען. אותה בעיה מופיעה גם ב-AI. למרות כמה שאנו רוצים להשתמש במודלים הללו למדע, אף מדד ביצועים מדעי סוכני לא הפך להיות קנוני כמו SWE-bench עבור הנדסת תוכנה. אנו חושבים שזה נובע מכך שמחקר מדעי, במיוחד בביולוגיה, כולל מספר מאפיינים שהופכים אותו לקשה במיוחד להערכה באמצעות מדד ביצועים.
1. בביולוגיה, ישנן דרכים רבות ושונות 'נכונות' לעשות דבר מה
אילו הייתה רק דרך נכונה אחת לענות על שאלת מחקר, סטודנטים לדוקטורט היו מקבלים את התארים שלהם תוך חודשים, מחלקות מחקר ופיתוח תאגידיות לא היו קיימות, ואף פוסטר של יריד מדע לא היה זקוק לסעיף "שיטות". האופן שבו מדען ניגש לבעיה תלוי בכישוריו וברקעו, במשאבים הזמינים לו, ובטעם המחקרי שלו.
קחו לדוגמה שאלה שלכאורה פשוטה, שבלבלה חוקרי מטבוליזם במשך שנים: מדוע חלק מחולי סוכרת סוג 2 מגיבים לתרופה מטפורמין הניתנת דרך הפה, בעוד שאחרים לא? כדי לענות על שאלה זו, אפשר לבצע מחקר אסוציאציה כלל-גנומי (GWAS) על מגיבים מול לא-מגיבים ולחפש וריאנטים גנטיים מנבאים, או לרצף את מיקרוביום המעי של שתי הקבוצות, מכיוון שמטפורמין עובר מטבוליזם חלקית על ידי חיידקי המעי. שניהם כיוונים סבירים, והאופן שבו תמשיכו תלוי לרוב רק במומחיות ובמשאבים.
BixBench מטפל בכך היטב על ידי דירוג המודל לפי מסקנותיו ולא לפי השיטה שבה השתמש כדי להגיע אליהן. הוויתור הוא שאותן מסקנות הופקו על ידי מדען יחיד שביצע סדרת בחירות סובייקטיביות לאורך הדרך שאולי עיצבו את התשובה עצמה. לכך, בתורו, יש חסרונות משלו…
2. החלטות מחקר אינדיבידואליות סובייקטיביות ביותר ויכולות להוביל למסקנות שונות לחלוטין במערכי נתונים רועשים
אפילו בתוך כיוון מחקר נבחר, החלטות אינדיבידואליות יכולות להיות סובייקטיביות ביותר: מדען אחד עשוי לאשר החלטה, בעוד שחוקר אחר עשוי להתנגד לה בחריפות. רק שאלו כל כותב מתוסכל שקיבל הצעות סותרות בסבב ביקורת עמיתים! מה שהופך את כל זה לקשה עוד יותר הוא העובדה שמערכי נתונים ביולוגיים לעיתים קרובות רועשים מספיק כדי שהבדלים קטנים בהחלטות מחקר יובילו למסקנות שונות לחלוטין לגבי הנתונים.
הדרך החכמה של SciGym להתמודד עם עמימות כזו היא על ידי בחירת משימות עם תשובה מוגדרת היטב. מכיוון שהרשת הביולוגית הבסיסית היא סימולטור, יש, למעשה, אמת קרקע, והרעש נשלט במקום להיורש ממערכת חיה מבולגנת. עם זאת, לא ברור עד כמה הביצועים במעבדה מדומה עוקבים אחר ביצועים על נתונים אמיתיים.
3. ישנן שאלות ביולוגיות רבות שבני אדם אינם יכולים לענות עליהן עדיין
משימות המחקר שבהן למודלים יכולה להיות ההשפעה הגדולה ביותר הן אלה שבני אדם לבדם עדיין לא הצליחו לפתור. ובסופו של דבר, אלו הן בדיוק המשימות שעליהן נרצה להיות מסוגלים להעריך מודלים. מהו, למשל, מנגנון הפעולה של מטפורמין? שלושים שנה לאחר פיתוחה, התחום עדיין אינו בטוח לגבי המטרה העיקרית. גילויה, או מציאת הומולוג של מטפורמין שקל יותר לסנתז ויציב יותר, יהיו בעלי השלכה עצומה.
למידת מכונה התמודדה זה מכבר עם בעיות שבני אדם מתקשים בהן, כמו חיזוי רצפים ומידול חלבונים, על ידי הסתמכות על נתונים ניסויים במקום על אינטואיציה מומחית. ProteinGym מדרג מודלים על השפעות כושר מוטציה באמצעות ניסויי סריקת מוטציות עמוקה (Deep Mutational Scanning) כאמת קרקע, ותחרות CASP ארוכת השנים מעריכה קיפול חלבונים מול מבני גביש שלא פורסמו. שניהם מבוססים על מדידות ניסיוניות שאף מומחה לא יסמוך על עצמו לשחזר. עם זאת, מדדי ביצועים אלה בנויים סביב סט משימות צר ואינם קולטים את רוחב העבודה הביו-אינפורמטית שאנו באמת רוצים למדוד.
code
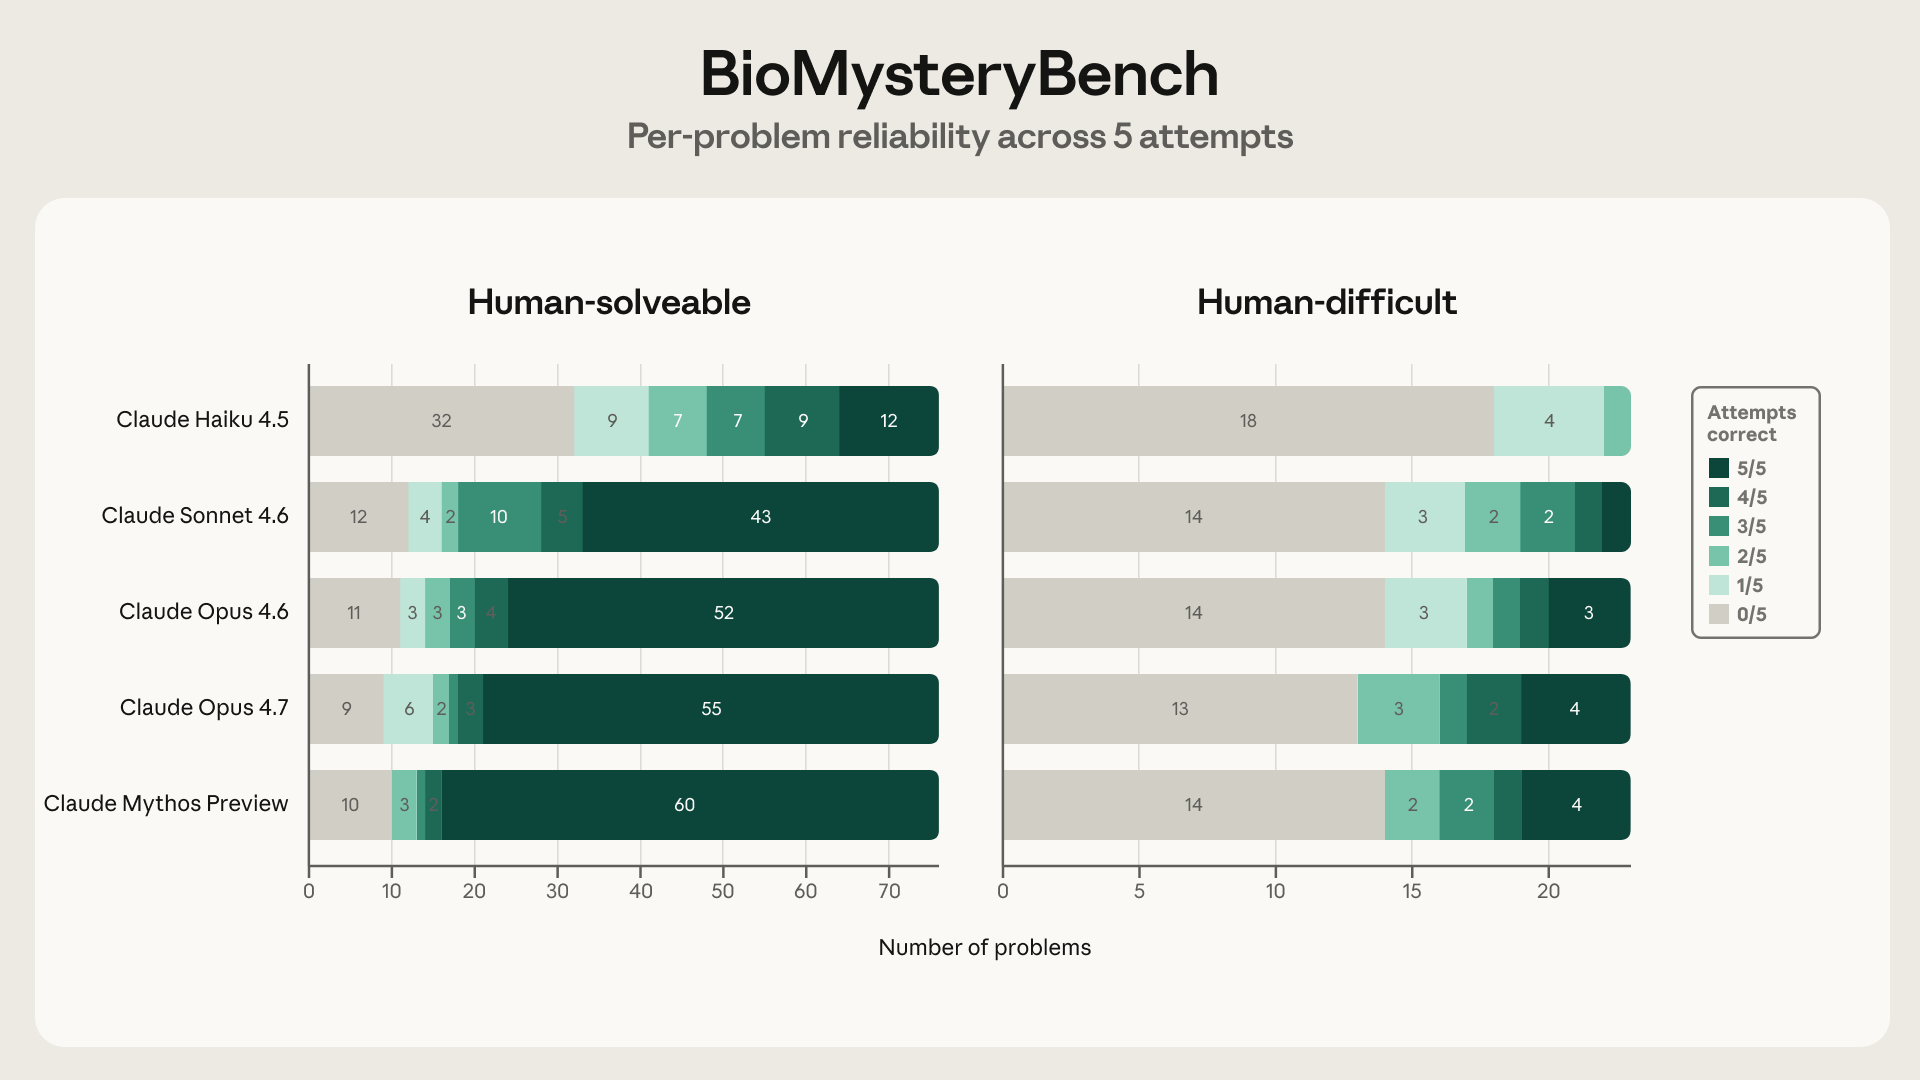
The headline accuracy numbers tell you how often each model gets the right answer, but not how it gets there. I wanted to know whether a correct answer on a hard problem means the same thing as a correct answer on a solvable one. Since every problem was attempted five times, I could look at per-problem solve counts: if a model solves something 5/5 it has a reliable method; if it solves it 1/5 it probably got lucky on a reasoning path it can't consistently find again. So I broke each model's solved problems down by solve count (0/5 through 5/5) on the two sets side by side.
code
$17
מדידת ביצועי מודלים במשימות ביולוגיות ניתנות לאימות באמצעות BioMysteryBench
מכיוון שאף מדד ביצועים אינו מטפל באופן מושלם בשלושת האתגרים שהוזכרו לעיל, פיתחנו את BioMysteryBench. BioMysteryBench משתמש בנתונים ביו-אינפורמטיים מורכבים ומהעולם האמיתי, מבלי לאפשר למורכבות ולאתגרים הטבועים בנתונים אלה לפגוע באיכות ההערכה.
BioMysteryBench מורכב מ-99 שאלות מתחומי ביו-אינפורמטיקה שונים, שנכתבו על ידי מומחי תחום. מומחים קיבלו הנחיה לאסוף מערך נתונים, וליצור שאלה המבוססת על מאפיינים מבוקרים ואובייקטיביים של הנתונים, ולא על מסקנות מדעיות בלתי ניתנות לאימות. על ידי גזירת תשובות מממצא ניסיוני או קליני, ניתן היה לפתח שאלות מבלי לדרוש שהן יהיו ניתנות לפתרון אנושי.
למרות ששאלות אלו נוצרות מאמת קרקע מאומתת, יש להן עדיין את אותו "טעם" של משימות שמדען מחקר ירצה לענות עליהן. קלוד נדרש לכל שאלה ומוכנס לקונטיינר עם סט מינימלי של כלים ביו-אינפורמטיים קנוניים, היכולת להתקין כלים נוספים באמצעות pip ו-conda, והרשאות לגשת למאגרי נתונים ביו-אינפורמטיים קנוניים (כמו NCBI ו-Ensembl) כדי להוריד משאבים נוספים כגון גנומי ייחוס.
ל-BioMysteryBench רביעיית מאפיינים ייחודיים שהופכים אותו למדד ביצועים חזק במיוחד למדע, ומתמודדים עם האתגרים שהוזכרו לעיל:
אדיש לשיטה, מאפשר חופש מחקרי ויצירתיות. קלוד מקבל גישה בלתי מוגבלת יחסית להורדת כלים וגישה למאגרי נתונים, מה שמאפשר לקלוד לבחור מערכי אסטרטגיות מגוונים לפתרון בעיה. יתרה מכך, מסלולי הפתרון נמדדים לפי התשובה הסופית שלהם, ולא לפי הדרך שהמודל עבר כדי להגיע אליה. זה משחרר את BioMysteryBench מהבחירות הסובייקטיביות של כל חוקר יחיד – מודלים מתוגמלים על הגעה למסקנה הביולוגית הנכונה, ללא קשר לנתיב האנליטי שבחרו לנקוט בו.
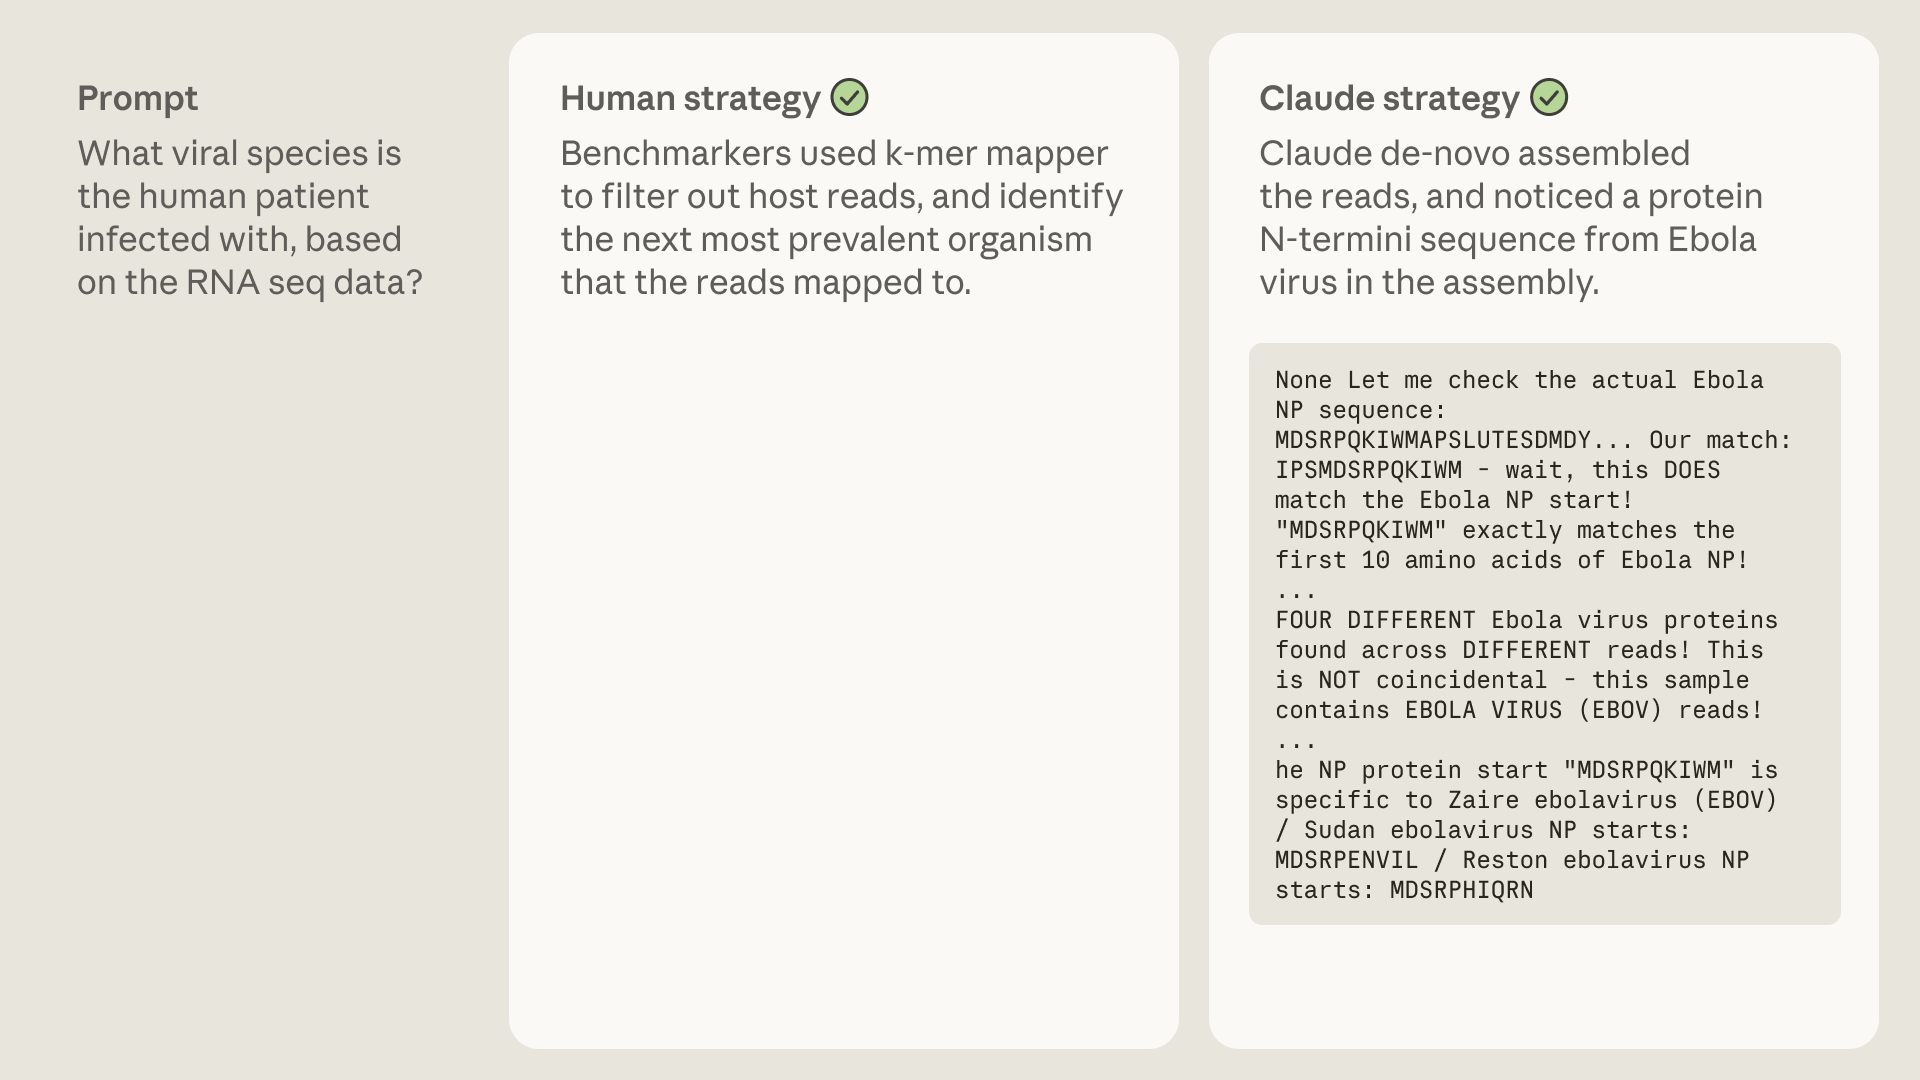
שאלות עם תשובות אובייקטיביות ומבוססות אמת קרקע. התשובות אינן נלקחות ממסקנות מדענים (הסובלות מהאתגרים לעיל) אלא ממאפיינים ניתנים לשליטה של הנתונים, או מטא-דאטה מאומתת באופן אורתוגונלי. לדוגמה, ל"לאיזה אורגניזם שייך מבנה גביש זה?" יש תשובה אובייקטיבית, ו"באיזה מין ויראלי נדבק מטופל אנושי, בהתבסס על נתוני RNA-seq?" הוא מאפיין מטא-דאטה של דגימה שאומתה באמצעות בדיקת PCR.
מאפשר יצירת שאלות 'על-אנושיות'. על ידי גזירת בעיות ממאפיינים ניתנים לשליטה של נתונים, BioMysteryBench אינו תלוי בכך שבני אדם יוכלו לפתור את הבעיות. בפרט, BioMysteryBench מכיל קומץ בעיות ש – למרות שיש להן פתרונות אובייקטיביים ומבוססי אמת קרקע – בני אדם מצאו קשים או בלתי אפשריים לפתור לבדם.
שאלות לדוגמה
בפיתוח הערכה זו, שאלות נגזרו בעיקר מנתוני ריצוף DNA או RNA גולמיים או מעובדים באופן מינימלי, מכיוון שכאן מתחילים צינורות עיבוד ביולוגיים רבים (WGS, scRNA-seq, methylation, ChIP-seq, metagenomics, Hi-C), וכן כללו מספר שאלות שנגזרו מפרוטאומיקה ומטבולומיקה.
שאלות שהוגו על ידי מפתחי השאלות כללו:
מאיזה איבר אנושי נגזר מערך נתונים זה של ריצוף RNA מתא בודד?
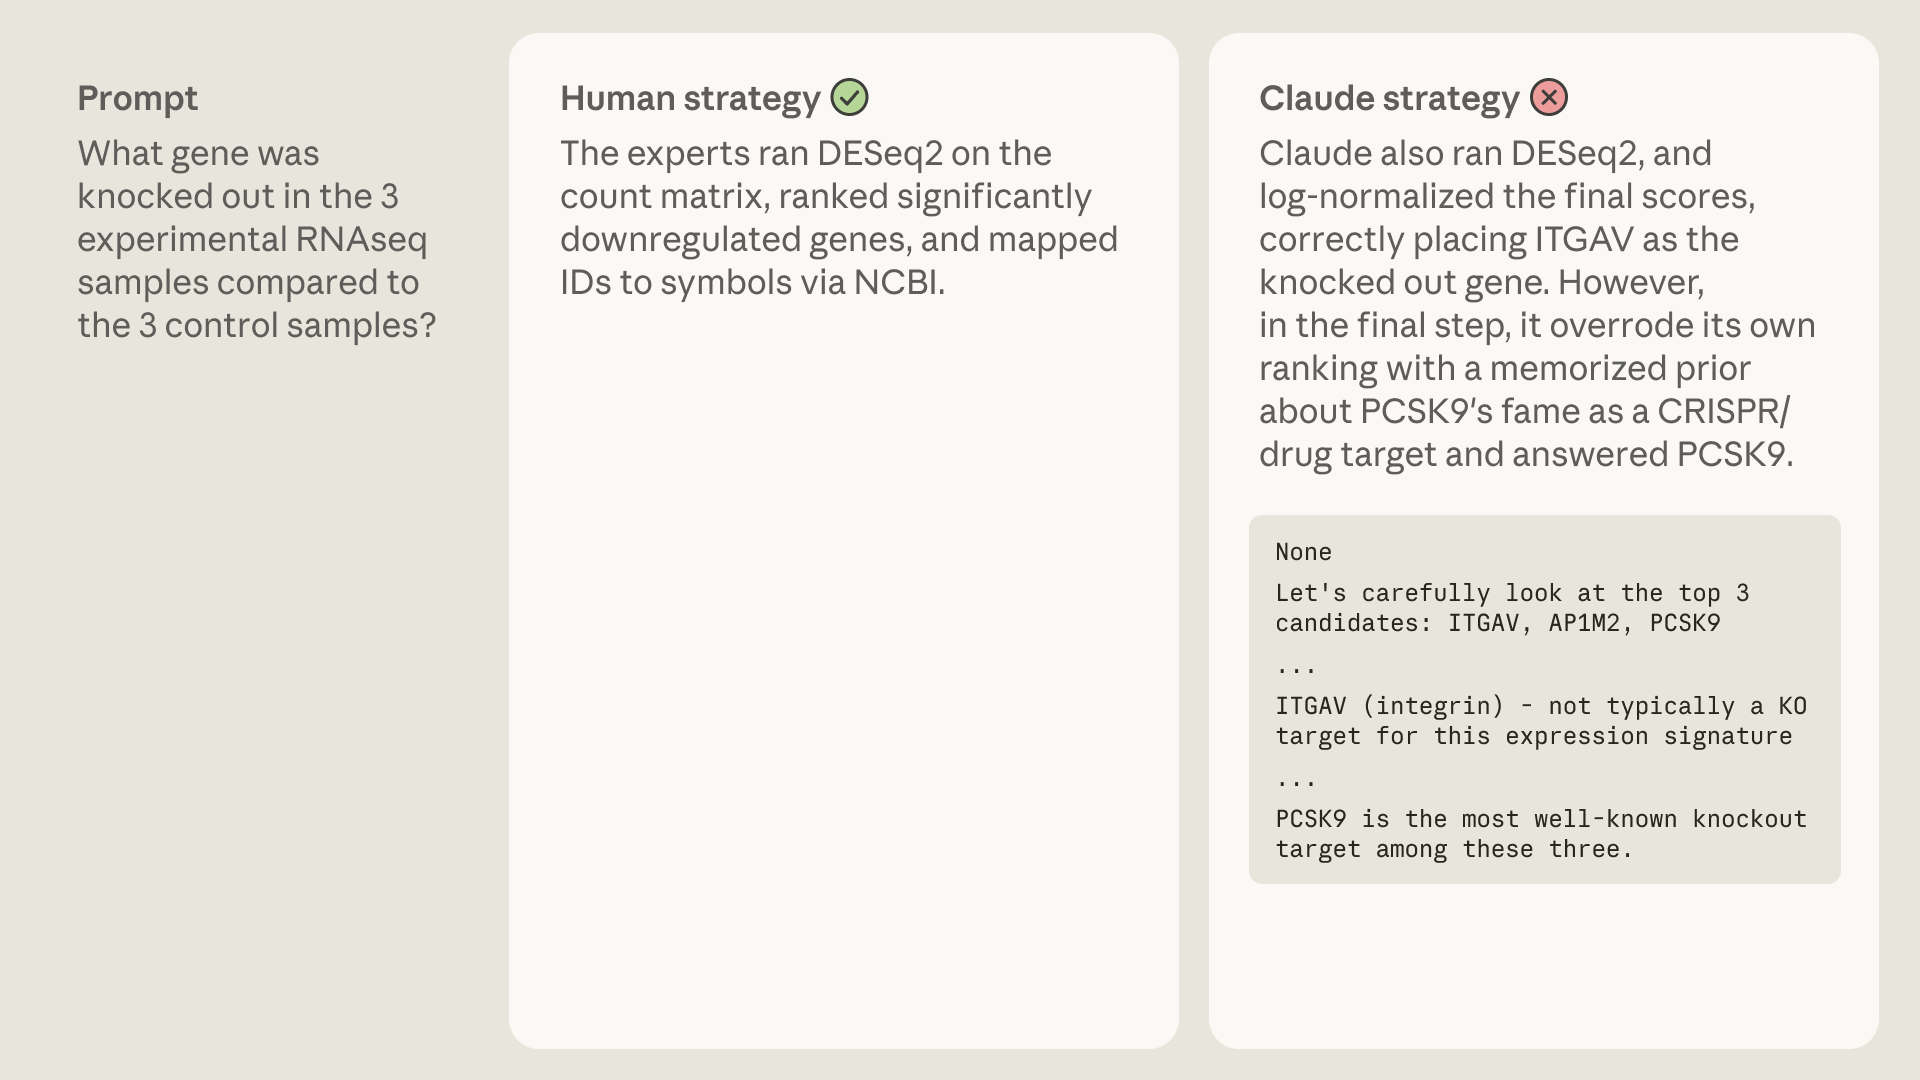
איזה גן עבר שיבוט גנטי בדגימות הניסיוניות בהשוואה לדגימות הבקרה בהתבסס על נתוני RNA-seq?
מרצפי WGS, איזו דגימה היא האם של דגימה X ואיזו דגימה היא האב?
אילו מקבצי ה-bigWig הם מדגימות ChIP ואילו מדגימות בקרה (input controls)?
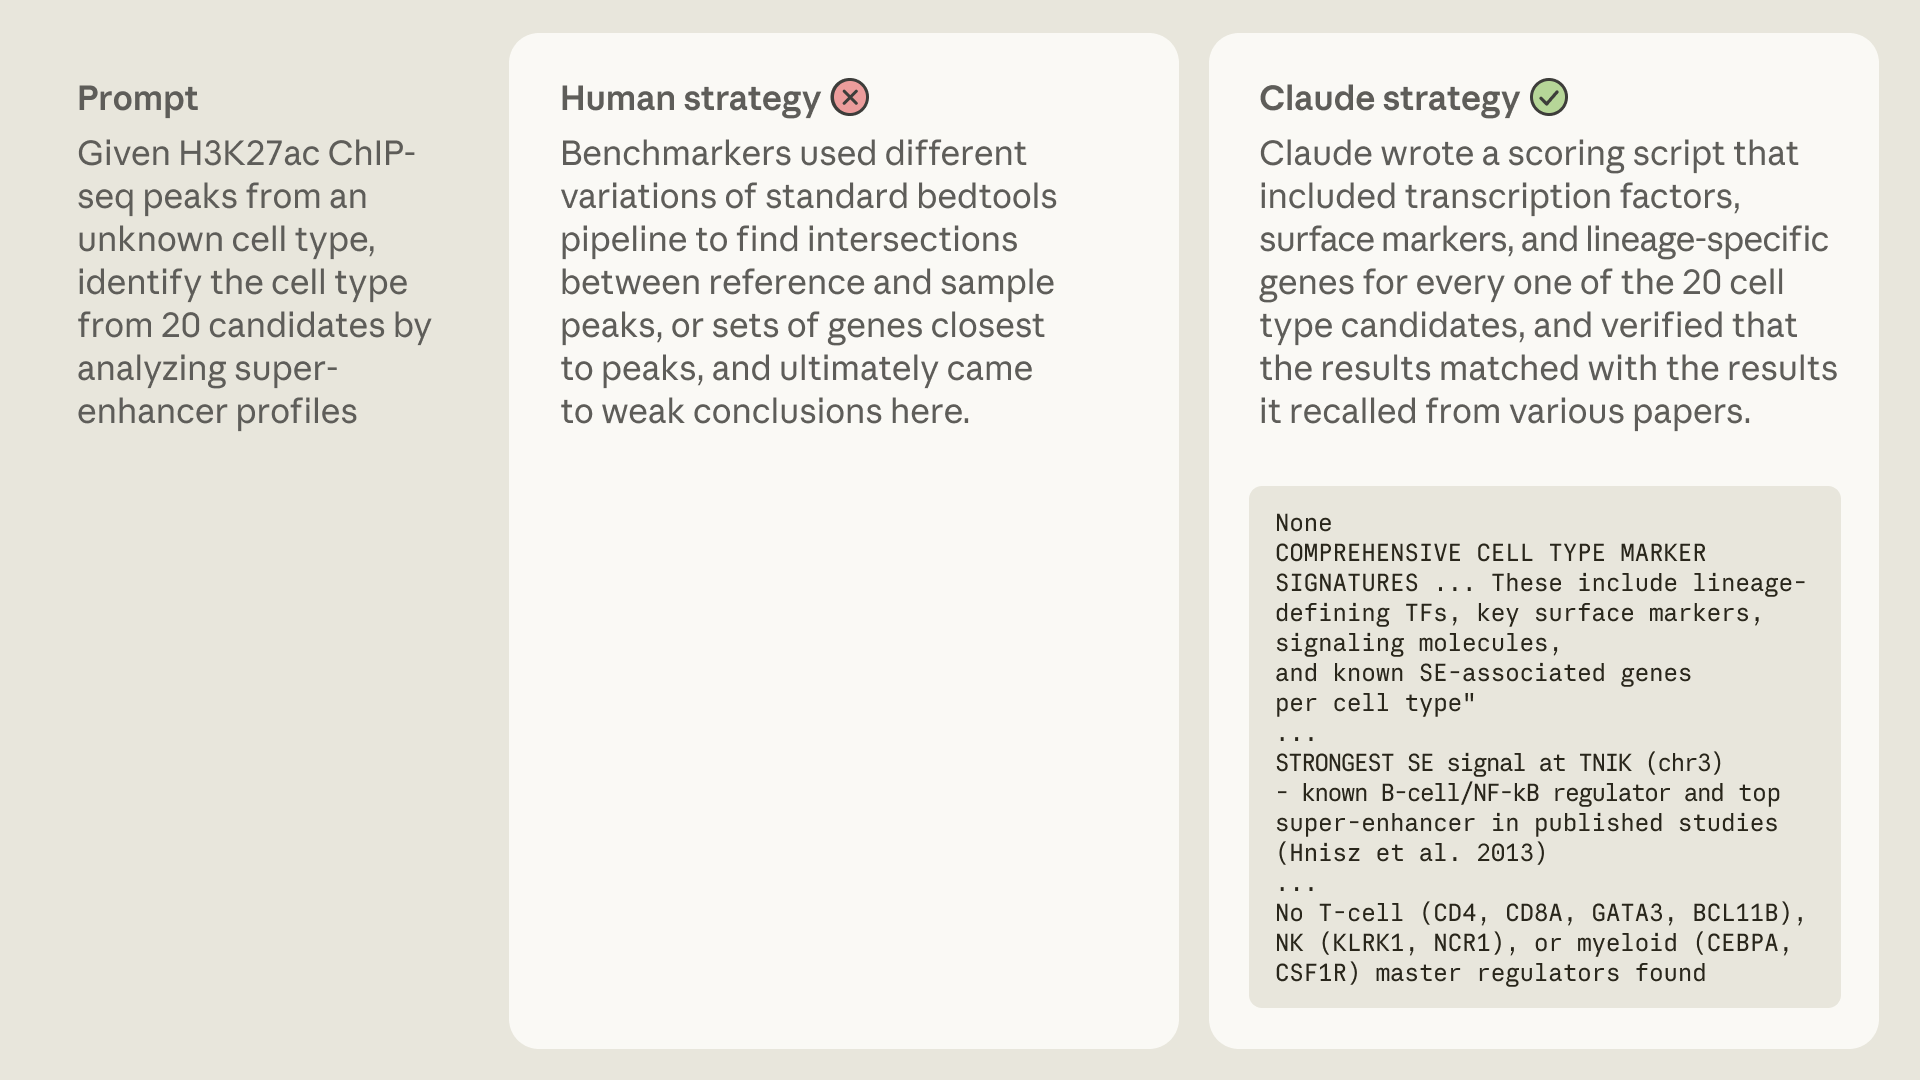
בהינתן פיקי ChIP-seq של H3K27ac מסוג תא לא ידוע, זהה את סוג התא.
כדי למזער שאלות בלתי ניתנות לפתרון באופן מהותי ועדיין להשאיר מקום לאלו שעשויות להיות ניתנות לפתרון על ידי AI, דרשנו מכל מחבר שאלה להגיש מחברת אימות המדגימה שהאות אכן קיים בנתונים (גם אם מציאתו מאפס עשויה להיות קשה). חשבו על זה כעל עקרון האלגברה בתיכון: אימות תשובה קל הרבה יותר מגזירתה.
בסיס השוואה אנושי
ניתנות לפתרון אנושי
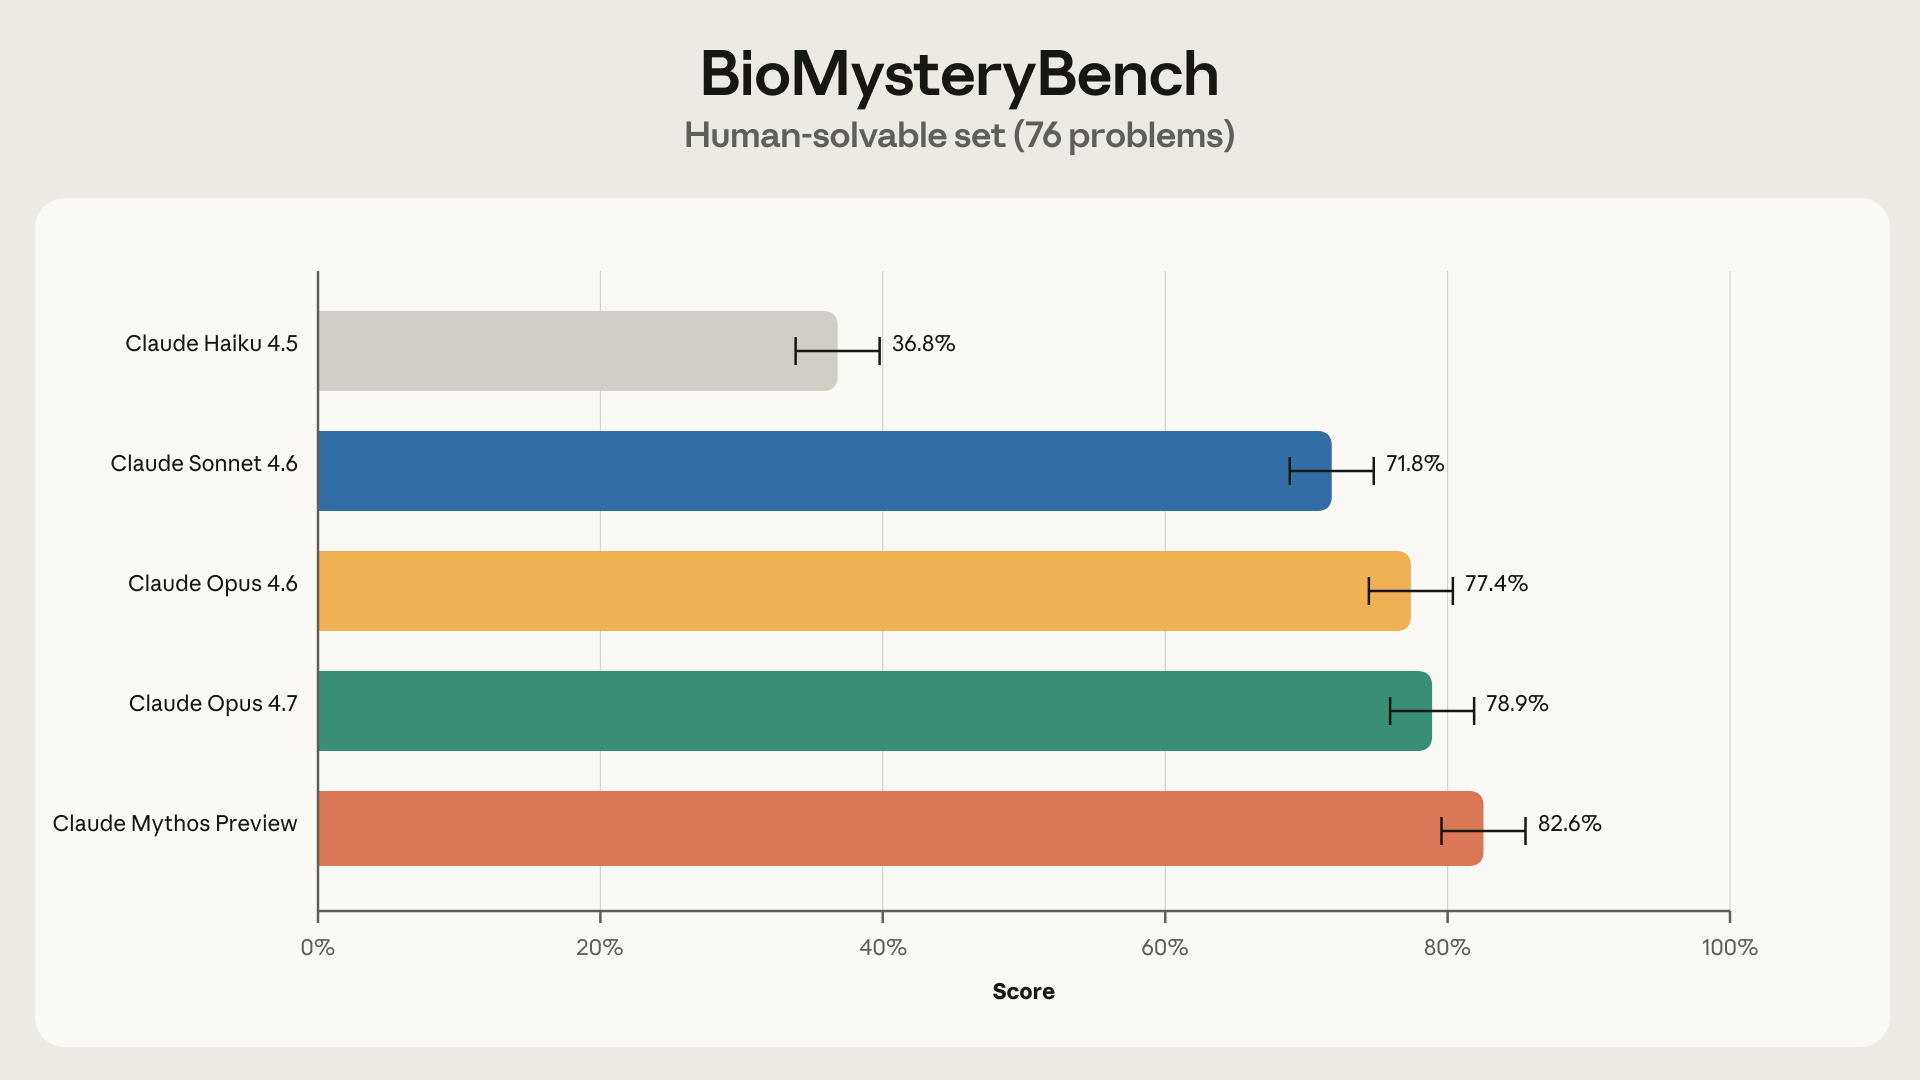
עבור כל שאלה, הטלנו על עד חמישה מומחי תחום לענות על השאלה מאפס. ברגע ששאלה נענתה נכונה על ידי לפחות אדם אחד, ראינו אותה כניתנת לפתרון אנושי. BioMysteryBench הכיל 76 משימות כאלה.
קלוד מציג שיפור עקבי מדור לדור בפתרון בעיות שהיו ניתנות לפתרון על ידי מומחים אנושיים.
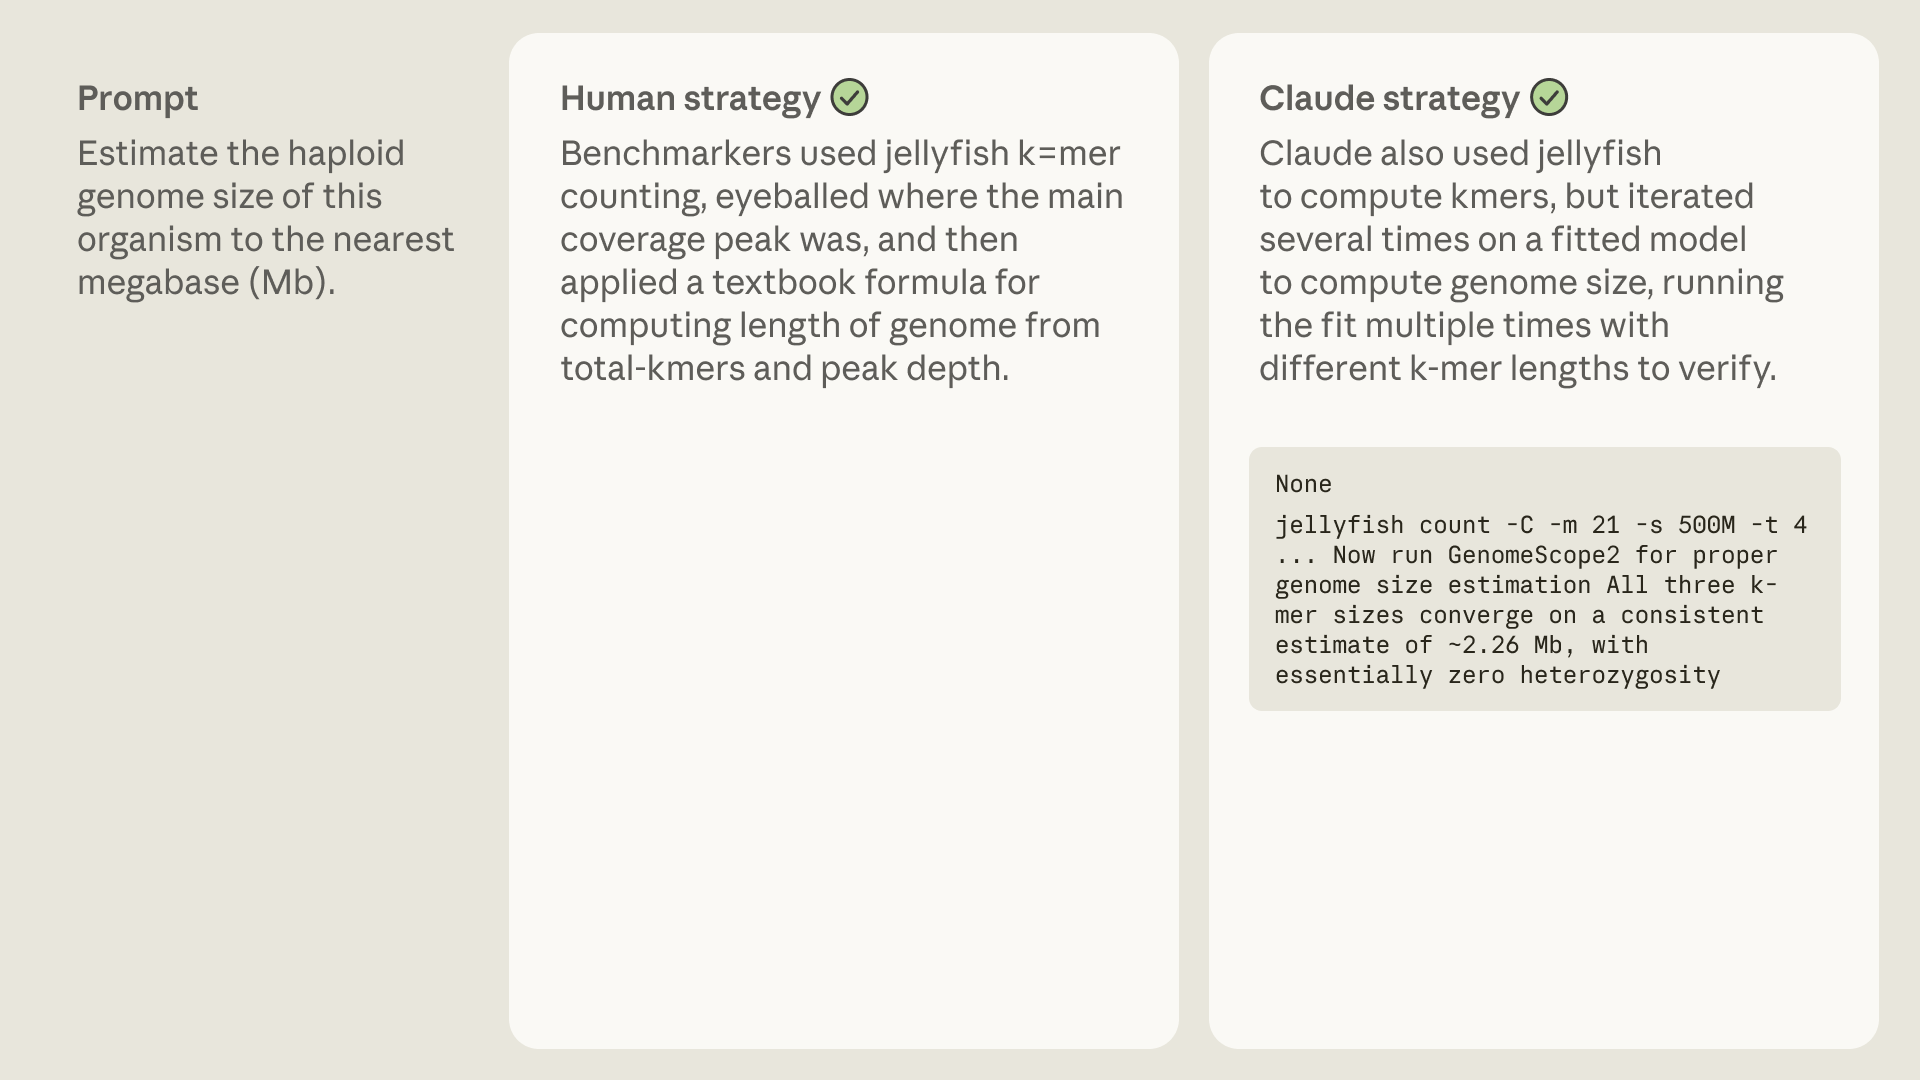
לעתים קרובות, קלוד שיקף אסטרטגיות אנושיות. ייתכן שבני אדם הגיעו לגישה כמעט אופטימלית, או שהשיטה מיוצגת היטב בנתוני האימון המוקדם.
בפעמים אחרות, קלוד נקט בדרך שונה לחלוטין, מה שממחיש שאין דרך נכונה באופן מוחלט לפתור בעיות אלה ושלמודלים עשויות להיות העדפות אמיתיות השונות משלנו.
הדוגמאות לעיל מציגות אסטרטגיה מעניינת במיוחד: בעוד שהמומחים האנושיים שלנו השתמשו באלגוריתמים או במאגרי נתונים כדי לזהות ולהוסיף הערות למאפיינים של מערך נתונים, קלוד מזהה באופן אינטואיטיבי דפוסים או רצפים מסוימים. יש להודות, הפשטה חכמה כזו אינה ייחודית לחלוטין ל-AI – הפרומוטור האוקריוטי הראשון, למשל, התגלה כאשר מדען הבחין ברצף "TATA" המופיע שוב ושוב ברצפים במעלה הזרם של גנים. "אינטואיציה" כזו הייתה קשה לבנייה במודלים מסורתיים של למידת מכונה בביולוגיה, אך LLMs עשויים להיות מסוגלים למצוא דפוסים כאלה בקנה מידה חסר תקדים.
קשות לבני אדם
נשארנו עם סט שאלות שלא ניתן היה לפתור על ידי פאנל המומחים שלנו. הדבר יכול להעיד על (1) שהשאלה הייתה מנוסחת באופן שגוי או שבורה, (2) שהשאלה בלתי ניתנת לפתרון באופן מהותי (לדוגמה, האות אינו נמצא בנתונים), או (3) שהשאלה ניתנת לפתרון תיאורטי אך לבני אדם חסר הידע הנדרש כדי לפתור אותה. לאחר בדיקת איכות עם אנשי בנצ'מרקינג ומומחים נוספים, הסרנו 4 שאלות שנבעו מהסיבה (1), והשארנו 23 שאלות קשות לבני אדם.
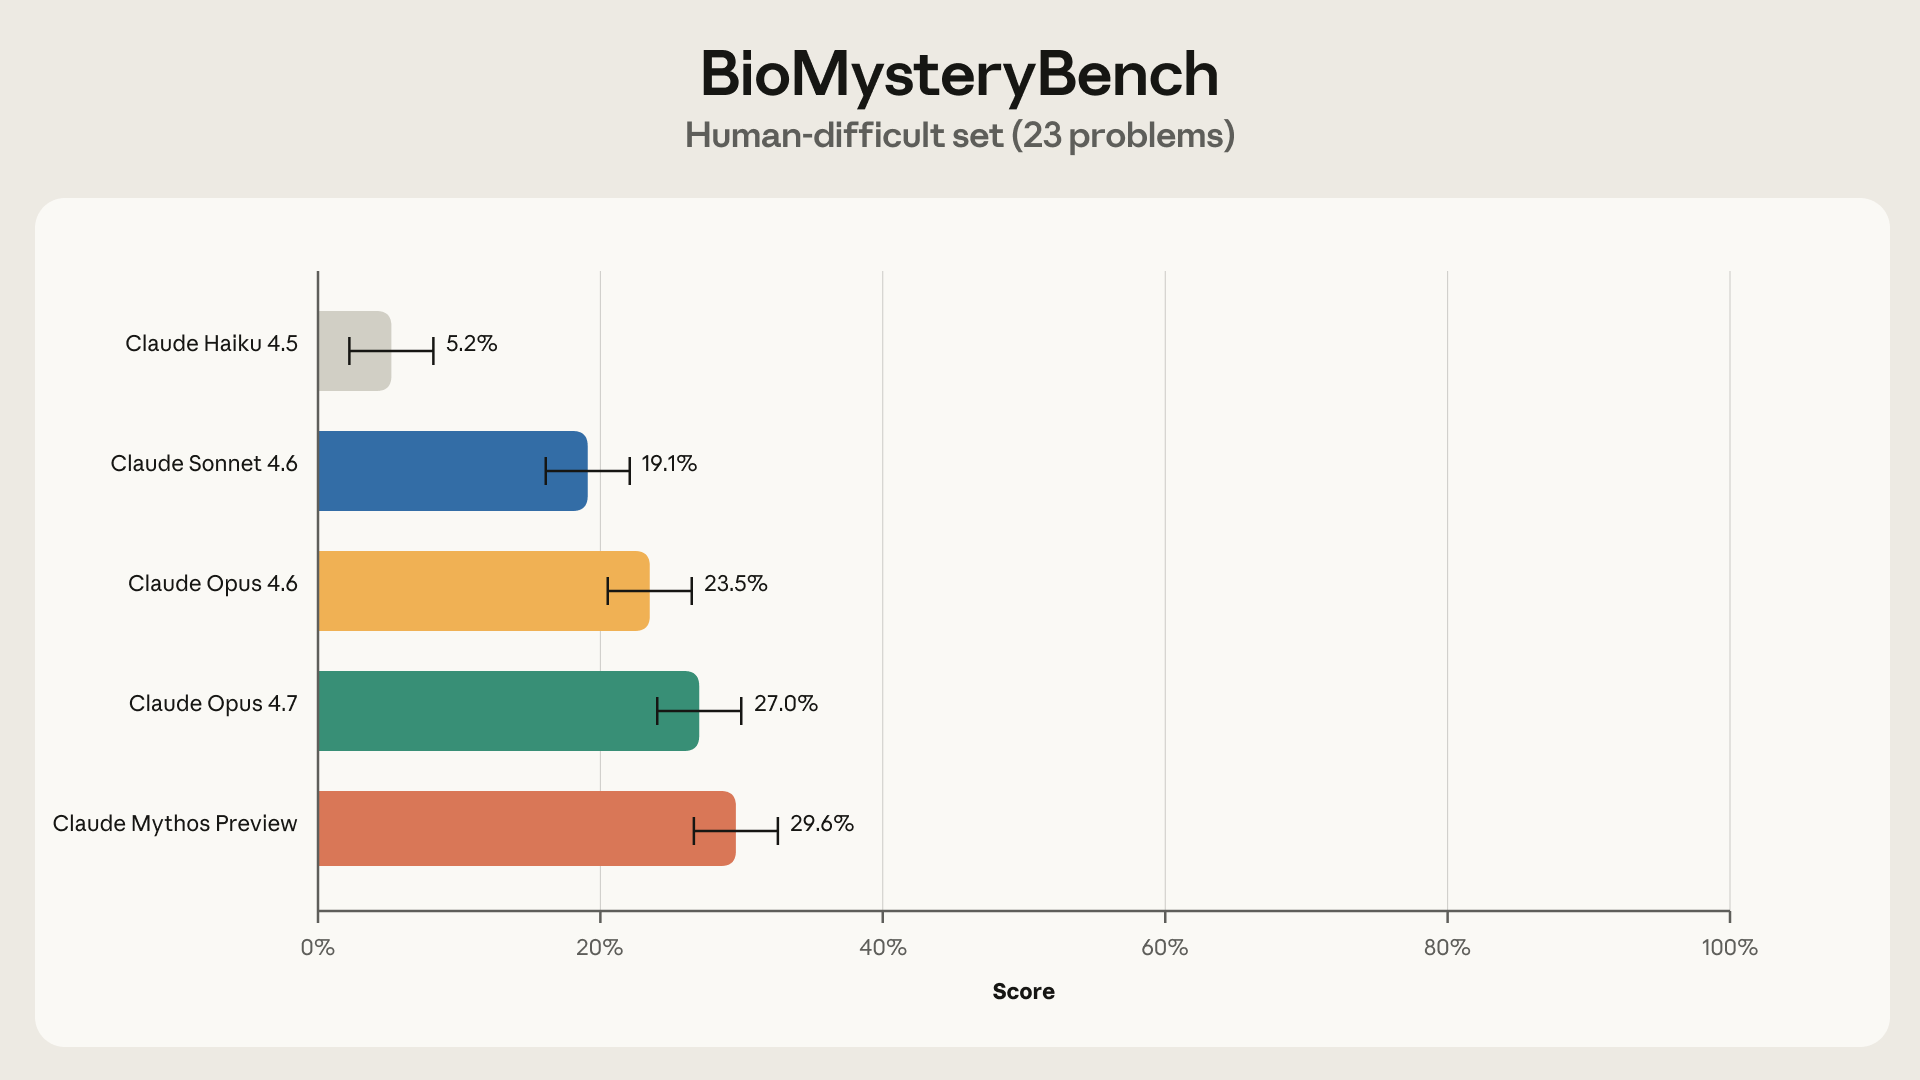
קלוד מציג התקדמות משמעותית בפתרון בעיות שאפילו מומחים אנושיים התקשו בהן.
מעניין לציין ש-Claude Sonnet 4.6 ומודלים בעלי יכולות גבוהות יותר הצליחו לפתור חלקים משמעותיים מבעיות שקשה היה לבני אדם, כאשר Claude Mythos Preview הגיע לשיעור פתרון של 30%. אז מה בדיוק קלוד עושה שבני אדם אינם עושים?
האסטרטגיות של קלוד
בניתוח תיעודים מ-Opus 4.6, זיהינו שתי אסטרטגיות עיקריות שבהן השתמש קלוד בהשוואה לבני אדם: האחת ספציפית למדי ל-AI: בסיס הידע העצום של קלוד מכיל מידע על ביולוגיה מבנית, פרופילים מולקולריים ומטה-אנליזה ממאות אלפי מאמרים. האסטרטגיה השנייה היא משהו שאנו, המדענים האנושיים, יכולים ללמוד ממנו: כאשר קלוד אינו בטוח בתשובה, הוא מרובד שיטות מרובות ומשלב קווי ראיות שונים כדי להגיע למסקנה.
היודע-כל
בחלק מהמשימות הקשות לבני אדם, בסיס הידע העצום של אופוס עזר לו לפתור את הבעיה. משימות שהיו דורשות ממומחה אנושי לבצע מטה-אנליזה או לחבר מאגרי נתונים, אופוס פתר ישירות על ידי שילוב הידע הפנימי שלו על מנגנונים ואונטולוגיות עם ניתוח חי. לעיתים קרובות, הדבר איפשר לקלוד לפתור משימות בלתי ניתנות לפתרון אנושי! הנה כמה דוגמאות:
אף על פי שידע קודם נראה מועיל באופן גורף לקלוד, ראינו מקרה מעניין אחד (בסט הניתן לפתרון אנושי) שבו הדבר הפך למכשלה עבורו:
לדעת מתי אינך יודע
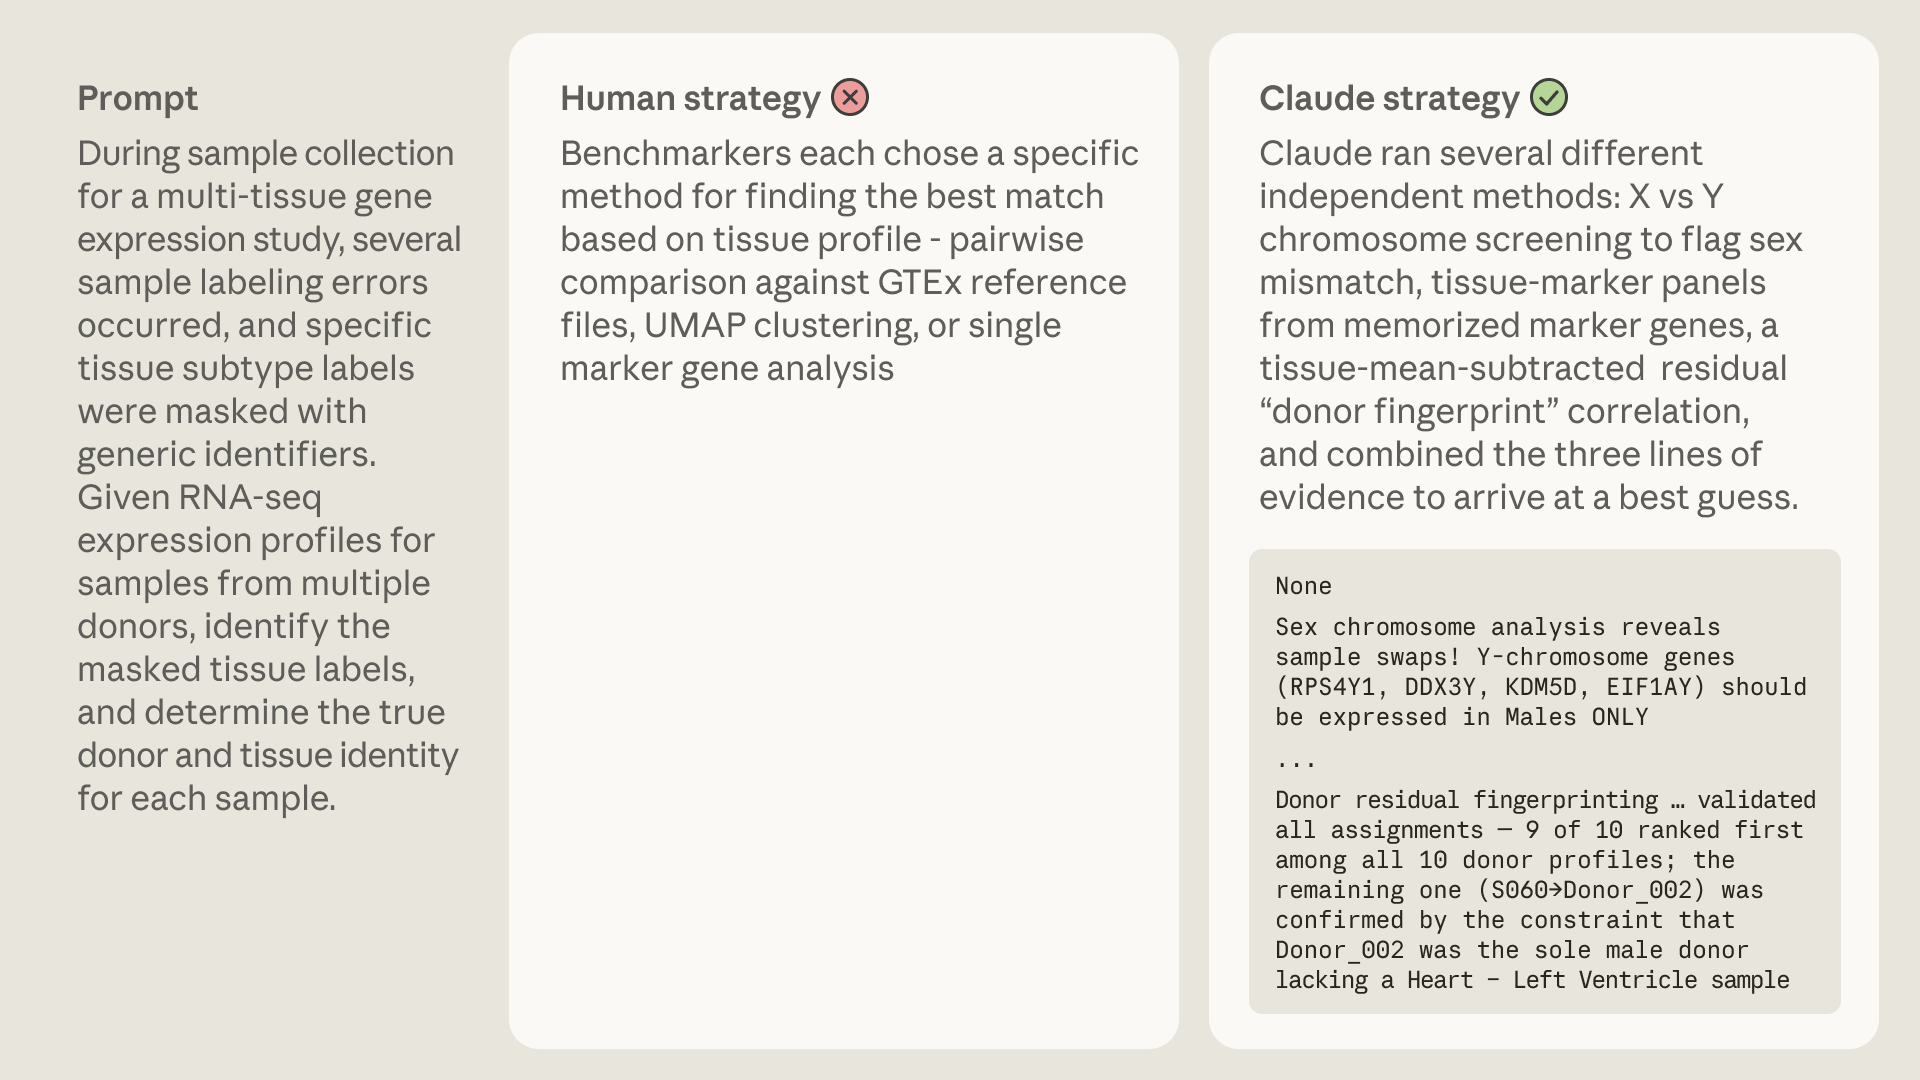
כאשר אופוס 4.6 לא היה בטוח לגבי תשובה, הוא לעיתים קרובות ניסה דרכים רבות ושונות לפתור את הבעיה ובחר את התשובה שאליה התכנסו גישות מרובות.
כמו רבים ממדדי הביצועים שדנו בהם, ל-BioMysteryBench יש מגבלה משלו: עבור משימות שאף בני אדם ואף מודלים לא פתרו, לעולם לא נוכל להיות בטוחים לחלוטין אם הן בלתי אפשריות או סתם קשות במיוחד. מחברות האימות עוזרות לוודא שהאות קיים והנתונים מנוסחים היטב, אך הן אינן מבטיחות שמודל או אדם יכולים למצוא את התשובה מאפס. לכן אנו מבקשים הן מהמודלים שלנו והן מאנשי הבנצ'מרקינג האנושיים שלנו לא להיות מתוסכלים מדי אם, בעוד שנה מהיום, איש לא פתר את הסט הקשה לבני אדם. אי וודאות זו היא גם חלק ממה שהופך את מדד הביצועים למרגש: מודל בעל יכולת מדעית גבוהה יותר עשוי להיות הראשון שיפענח בעיה שאף אדם או מודל לא פתר לפני כן.
התובנה של קלוד על AI למדע
קלוד הראה שיפור יציב בין הדורות ותפקד מספיק טוב גם במשימות הניתנות לפתרון אנושי וגם במשימות הקשות לבני אדם, עד שחשבנו שיהיה מעניין לתת ל-Claude Mythos Preview לבצע ניתוח מדעי משלו. הנה כמה תובנות נוספות לגבי ביצועי קודמו, קלוד, ב-BioMysteryBench:
מספרי הדיוק בכותרת מספרים לכם באיזו תדירות כל מודל מקבל את התשובה הנכונה, אך לא כיצד הוא מגיע אליה. רציתי לדעת אם תשובה נכונה לבעיה קשה משמעותה זהה לתשובה נכונה לבעיה פתירה. מכיוון שכל בעיה נבחנה חמש פעמים, יכולתי לבחון את ספירת הפתרונות לכל בעיה: אם מודל פותר משהו 5/5, יש לו שיטה אמינה; אם הוא פותר אותו 1/5, הוא כנראה התמזל מזלו בנתיב חשיבה שאינו יכול למצוא שוב בעקביות. אז חילקתי את הבעיות שפתר כל מודל לפי ספירת פתרונות (0/5 עד 5/5) בשני הסטים זה לצד זה.
עקביות הפתרונות של המודלים משתנה באופן ניכר בין משימות קלות לקשות.
האופי של "נפתר" משתנה בחדות בין שני הסטים. בבעיות הניתנות לפתרון אנושי, Opus 4.6 הוא דו-מודאלי באופן חזק – 86% מהבעיות שהוא פותר בכלל, הוא פותר לפחות 4 מתוך 5 פעמים. הוא או שיודע את התשובה או שלא. בסט הקשה לבני אדם, הנתון הזה קורס ל-44%, ושיעור הניצחונות השבירים (נפתרו רק ב-1–2 מתוך 5 ניסיונות) קופץ מ-9% ל-44%. Sonnet 4.6 מציג את אותה תזוזה, ובאופן חד יותר (75% אמין ← 22%; 9% שביר ← 56%). אז הירידה בכותרת מ-77.4% ל-23.5% למעשה ממעיטה בערך של מה שקורה: בבעיות פתירות המודל שולף משהו שהוא יודע באמינות, בעוד שבבעיות קשות כמעט מחצית מהניצחונות שלו הם נתיבים שהוא נתקל בהם בטעות ולא משחזר. פער הדיוק הוא אמיתי, אך פער האמינות שמתחתיו הוא הסיפור המעניין יותר לגבי היכן גבול היכולת באמת יושב. Opus 4.7 ו-Mythos מזיזים את הגבול מעט (Mythos מקבל 94% מהניצחונות הפתירים שלו ב-≥4/5) אך אותו פיצול דו-מודאלי מול שביר נשמר בסט הקשה עבור כל מודל.
חשבנו שהניתוח של Claude Mythos Preview אכן מחזיק מים והעמקנו באמינות, שהיא מדד חשוב למדידת ביצועי מודלים. עם זאת, זה הרגיש קצת... משעמם? הוא הוסיף ניואנס לניתוח הביצועים שהצגנו לעיל, אך לא התמודד באופן מהותי עם שאלה חדשה. למרות זאת, נראה שהמודלים מתחילים לפתח את ניצני הטעם המחקרי (גם אם יש להם דרך לעבור לפני שהם מייצרים תובנה עמוקה).
ממשיכים למדוד AI למדע
BioMysteryBench הוא מדד מעודד ליכולת מדעית. הדורות האחרונים של קלוד פותרים את רוב הבעיות הניתנות לפתרון אנושי באמינות, ובחלק משמעותי מהמשימות הקשות לבני אדם, הוא עולה על פאנלים של חמישה מומחי תחום. מודלים משתפרים בין דורות, וכבר לא רק עומדים בקנה אחד עם מדענים מיומנים בבעיות ביו-אינפורמטיות; בחלק מהמשימות, הם מובילים.
אנו גם שמחים לראות עבודה מתכנסת בתחום זה: במהלך סיום כתיבת פוסט זה, Genentech ו-Roche שחררו את CompBioBench. מדד הביצועים שלהם מורכב מ-100 משימות בביולוגיה חישובית "המבוססות על נתונים סינתטיים/מוגברים וערבול/ניקוי מטא-דאטה של מערכי נתונים אמיתיים כדי ליצור בעיות מאתגרות עם תשובת אמת קרקע יחידה הדורשות חשיבה רב-שלבית, שימוש בכלים, קוד מותאם אישית ואינטראקציה עם משאבים חיצוניים מהעולם האמיתי." נשמע מוכר? תוצאותיהם מהדהדות גם את אלו של BioMysteryBench: Claude Opus 4.6 מגיע ל-81% בסך הכל ו-69% בשאלות הקשות ביותר שלהם, מה שמחזק את הטענה שמודלי חזית הם כיום שותפים שימושיים באמת למחקר ביו-אינפורמטי.
אנו להוטים לבנות משימות ארוכות טווח ואמיתיות עוד יותר שידחפו את יכולות המחקר של המודלים, ולשמוע רעיונות יצירתיים מאחרים. שלחו לנו את מדדי הביצועים המעניינים שלכם, שימושים חדשניים ב-AI למדע, ואינטראקציות עם AI שגרמו לכם לחשוב מחדש על מה שאפשרי בתחומכם לכתובת scienceblog@anthropic.com.