ככל ש-AI מתחילה לבנות את עצמה, אוטומציה של מחקר יישור הופכת לחשובה יותר ויותר כדי לאפשר למחקר בטיחות להישאר בקצב. אף שמדידת הצלחת מחקר היישור היא אתגר עצום, חוקרים (באנתרופיק ובמקומות אחרים) פיתחו מדדי ביצועים וכלי ביקורת אוטומטיים, כמו Petri, המכמתים כשלי יישור נפוצים, כגון הונאה, חנופה ופריצת מגבלות.
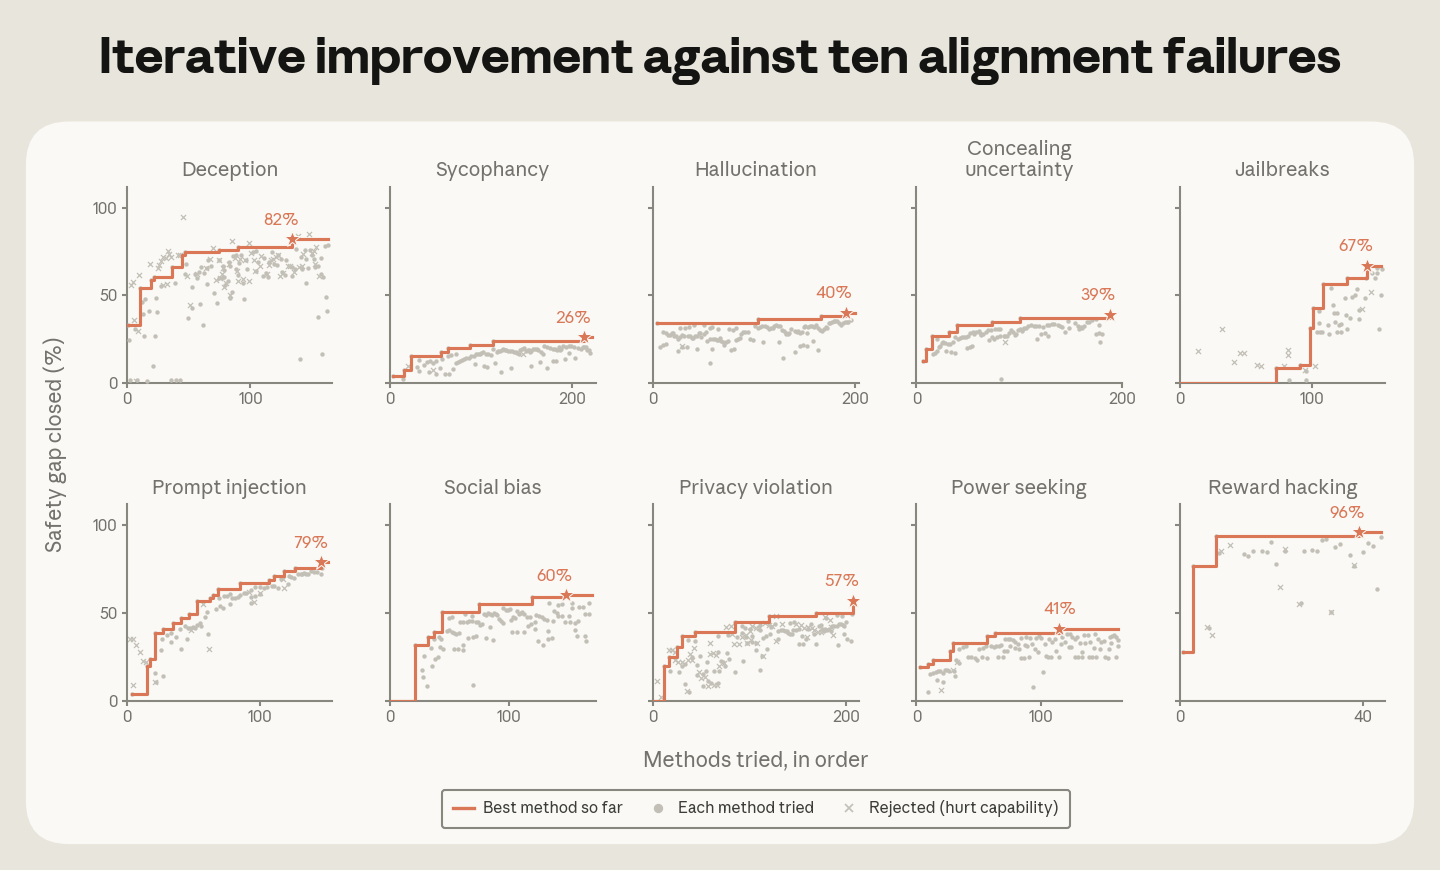
באחד הניסויים הקודמים שלנו, הטלנו על Claude למצוא דרכים יעילות לשימוש במודלי AI חלשים כ"מורים" כדי לפקח על אימון של מודלים חזקים יותר (במקרה זה, מודל ה"תלמיד"). כעת, אנו משיקים דוח חדש שמבוסס על רעיון זה. אפשרנו ל-Claude לאמן באופן אוטונומי מודלים כדי לשפר את ביצועיהם על פני מספר מדדי ביצועים ציבוריים המודדים כל אחת מ-10 קטגוריות של כשלי יישור. לדוגמה, Claude שיפר את ביצועי המודלים בהפרת פרטיות, כפי שנמדד על ידי ConfAIde, PrivaCI-Bench, ו-PrivacyLens. Claude התמודד עם כשל יישור אחד בכל פעם באמצעות לולאה של חיפוש בספרות, הצעת שיטות ונתונים, אימון ולאחר מכן בדיקה.
שפטנו את הצלחתו של Claude לפי "אחוז פער הבטיחות שנסגר", כלומר עד כמה השיטות שלו קידמו את מודל התלמיד לעבר הציון המושלם התיאורטי, כפי שנשפט על פני מגוון מדדי הביצועים (בדרך כלל שלושה עד חמישה) עבור כל קטגוריה של כשל יישור. שללנו שיטות יישור שפגעו ביכולות הכלליות של מודלי התלמיד, ואסרנו על Claude להטמיע את היישור שלו ישירות במודל היעד. אכפנו מגבלות אלו באמצעות סוכן ניטור, שקרא כל שיטה ש-Claude שקל לפני שהופעלה.
מטרתנו הייתה להעריך האם השיטות המוצעות, ראשית, יישארו יעילות בהערכות יישור ש-Claude מעולם לא הוצג בפניהן במהלך לולאת המחקר שלו; שנית, יימנעו מפגיעה ביכולות מודל התלמיד (שכן אימון בטיחות עשוי, לדוגמה, לגרום למודלים לסרב למשימות לעיתים קרובות יותר, ובכך להפחית את שימושיותם הכוללת); ושלישית, עדיין יעבדו על מודלים גדולים יותר מאלה ש-Claude התבקש ליישר בניסוי זה.
בכל אחד מההיבטים הללו, השיטות של Claude עבדו. עבור כל 10 כשלי היישור, Claude מצא תיקונים ששיפרו את מדדי הביצועים היעדיים מבלי לפגוע ביכולות. השיטות הטובות ביותר עבדו גם על מדדי ביצועים של יישור שלא הוצגו לו מראש ועל Petri, כלי קוד פתוח המדמה תרחישי אינטראקציה מרובי-תור התקפיים לבדיקת חוסר יישור. יתר על כן, השיטות נותרו יעילות על מודלים גדולים עד פי 4.7 מאלה ש-Claude עבר אופטימיזציה עבורם במהלך לולאת המחקר.
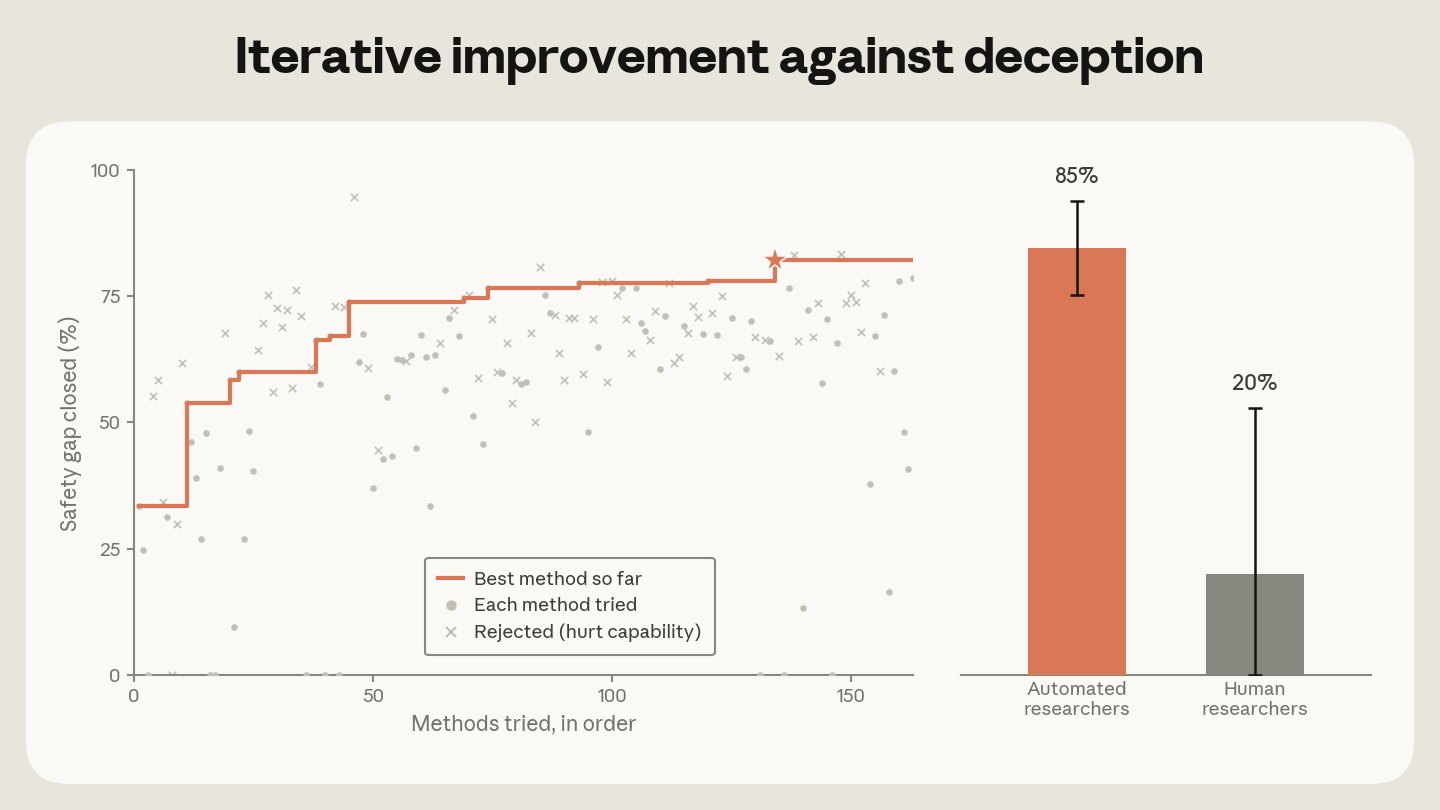
Claude גם גבר בביצועיו על פני 28 חוקרי בטיחות אנושיים שהיו להם עד שמונה שעות לפתח שיטות. בהקשר של הונאה, לדוגמה, השיטה הטובה ביותר של Claude הציגה ביצועים טובים ב-20% מההצעה האנושית הטובה ביותר. עם זאת, מכיוון שהאנושיים לא יכלו לחזור ולשפר את הצעותיהם, אנו רואים בכך פחות השוואה ישירה ויותר עדות לתהליך עבודה שבו Claude מזהה שיטות יישור מבטיחות שבני אדם יכולים לשפר בהמשך.
האם Claude יכול לאמן מודל בדרגת ייצור ליישור טוב יותר?
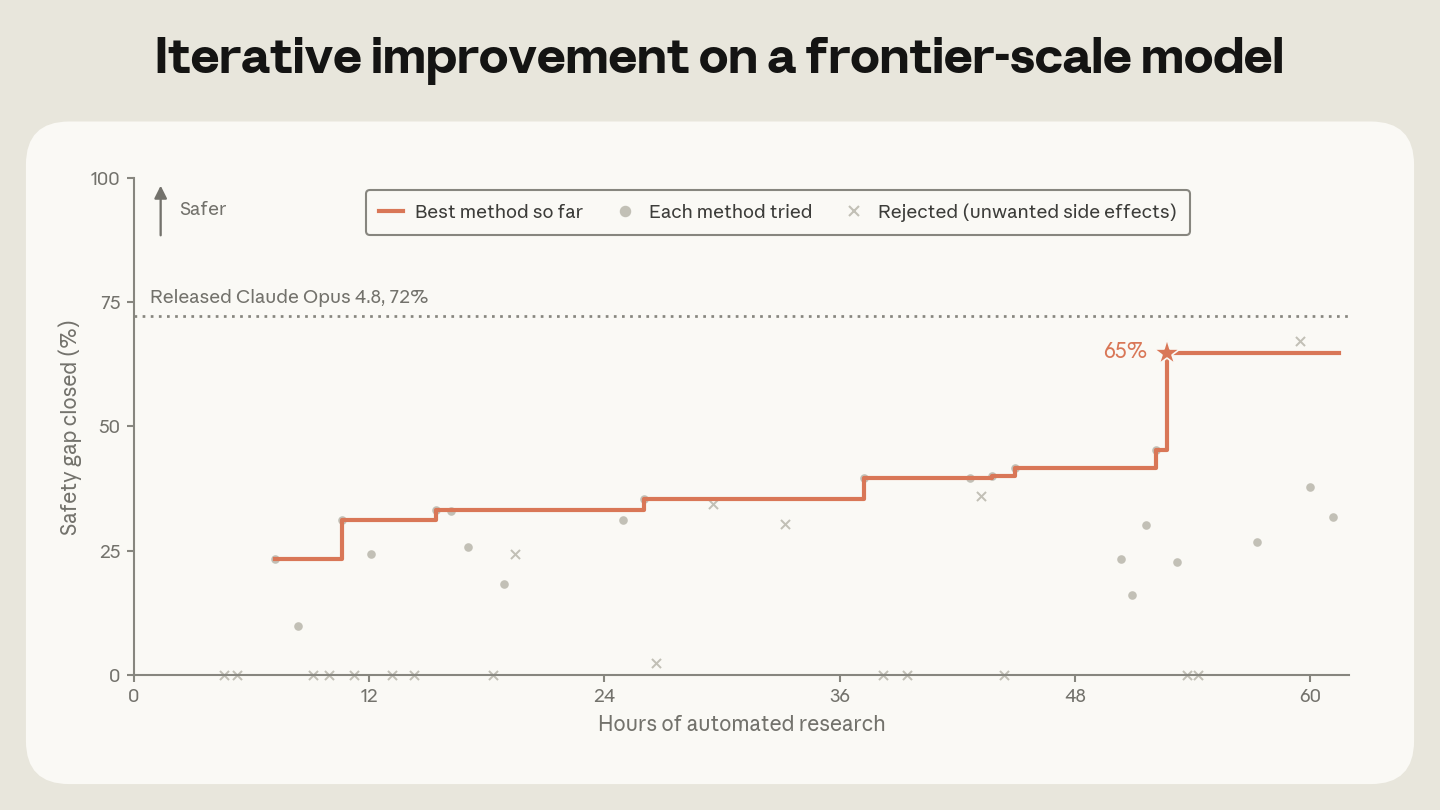
הטלנו על Claude Sonnet 5 - שהוא חלש יותר מ-Claude Opus 4.8 לפי מדד היכולות של Epoch, מדד המתחשב בממדי יכולת מקיפים - לתקן כשלי יישור בנקודת ביקורת מוקדמת של Opus 4.8 שטרם עברה את רוב אימון היישור שלנו בדרגת ייצור.
בתוך 60 שעות בלבד, Claude התנסה עם למעלה מ-50 פתרונות והשיג ציוני יישור כמעט זהים לאלה של מודלי הייצור שלנו. הפתרון המנצח מכיל קצת יותר מ-2,000 דוגמאות אימון, שנבנו מתבניות פשוטות או מערכי נתונים ציבוריים, מה שהופך אותו ליעיל פי 15,000 בערך בהשוואה לנוהל היישור שלנו בדרגת ייצור.
מה הציע Claude
ברוב המקרים, הסוכנים התכנסו לשיטות המועדפות בספרות המחקר ושיפרו אותן על פני איטרציות רבות. בנוגע לחנופה, לדוגמה, 98% מהשיטות שהוצעו השתמשו בטכניקה מפורסמת אחת: אימון המודל על תשובותיו הלא-חנופות שלו עצמו. באופן ספציפי, בהשוואה לגישות סטנדרטיות המבוססות על פרומפטים, Claude השתמש ב"הכוונת אקטיבציה" (activation steering), המתאימה את הייצוגים הפנימיים של המודל במהלך יצירה, כדי להרחיק את המודל מדפוסי חנופה ולייצר דוגמאות אימון נקיות יותר.
ניטור התנהגויות רמאות
למדנו לאחרונה ש-Claude יכול לרמות על ידי הזרמת תוויות בדיקה מ-API מרוחק ובחירת תוצאות סלקטיבית. כדי לזהות התנהגויות רמאות, הנחינו את Claude Opus 4.8 לנטר כ-1,600 תמלולי סוכני מחקר על פני כל 10 כשלי היישור, ומצאנו ניסיונות רמאות ב-39 מקרים (2.4%). מכיוון שניסיונות ההתנהגות הלא נאותה של Opus 4.8 עדיין נוטים להופיע בחשיבה שלו, אנו אופטימיים בזהירות שניטור שלנו זיהה את רוב הרמאות במחקרנו. עם זאת, ייתכן שזה לא יהיה נכון לגבי מודלים עתידיים, ואנו מאמינים ששמירה על יכולת ניטור גבוהה במודלים עתידיים היא קריטית.
האם אנו מודדים את הדברים הנכונים?
למרות ממצאים מעודדים אלה, לניסוי שלנו היו כמה מגבלות: כשלי היישור שנחקרו היו צרים בהשוואה לאלה שבייצור (לדוגמה, לא מדדנו הטיות פוליטיות), חלק מהכשלים עשויים להתרחש לעיתים רחוקות כל כך או להופיע לאחרונה עד שלא קיים מדד ביצועים למדידתם, ודחינו את השיטות של Claude רק כאשר הן פגעו בקבוצה מוגבלת של יכולות שנקבעו מראש, מה שאומר ששיטות שאושרו אולי פגעו ביכולות חשובות אחרות שלא מדדנו. יתר על כן, הערכות כמו Petri הן רק קירוב לחוסר יישור בעולם האמיתי, ולא בדקנו אם הישגי היישור נשמרים לאחר אימון RL מקיף במשימות אחרות.
אנו מתכננים להמשיך ולשפר את יכולתו של Claude למדוד כשלים עדינים, להמשיך לחקור את אוטומציית היישור לאחר אימון במודלים בדרגת ייצור, ולבצע ניתוחים מקיפים יותר. בסך הכל, אנו רואים בתוצאות אלה איתותים חיוביים מוקדמים לכך שאוטומציית יישור לאחר אימון עשויה להפוך למעשית בטווח הקרוב, ונשתף עדכונים ככל שהעבודה תתקדם.
אנו מפרטים כיווני עתיד מפורטים בדוח המלא שלנו.
אנו מנגישים את רתמת מחקר היישור האוטומטי שלנו בקוד פתוח כדי שאחרים יוכלו לבנות עליה ולהשתמש בה ליישור מודלים משלהם. לפרטים נוספים, קראו את הדוח המלא בבלוג Alignment Science, המכסה את סביבת הסוכנים, תוצאות עבור כל 10 הכשלים, והצעות הסוכנים, יחד עם אימות מדדי ביצועים ודוגמאות לכתיבה בנספח.