מדידת יכולתם של מודלי שפה גדולים לפתח אקספלויטים
מאת: ניוטון צ'נג, קין לוקאס, ויני שיאו, ניקולס קרליני ומילאד נסר
מבוא
יכולתו של Claude Mythos Preview לפתח אקספלויטים מהווה קפיצת מדרגה משמעותית לעומת מודלי חזית קודמים. זו הייתה אחת הסיבות המרכזיות לפריסה זהירה של המודל באמצעות Project Glasswing, במקום שחרורו לקהל הרחב. Mythos Preview מסוגל לאתר פרצות מורכבות, אך מה שהדאיג אותנו במיוחד בבדיקות הפנימיות שלנו, היה יכולתו להפוך פרצות לאבני בניין של אקספלויטים (exploit primitives), ולשלב אותן יחד לשרשרת תקיפה שלמה, מקצה לקצה.
כאשר פרסמנו את התוצאות של Mythos Preview, מדדנו את יכולותיו באמצעות חיפוש פרצות Zero-Day חדשות ובניית אקספלויטים עבורן. הערכות איכותניות מסוג זה מועילות להצגת יכולותיו של מודל – אך באופן אידיאלי, אנו זקוקים למדדי ביצועים כמותיים ואיכותיים שיאפשרו לנו למדוד אותן בדיוק רב. הבעיה בה נתקלנו בעת השקת Mythos Preview הייתה ששום מדד ביצועים ציבורי קיים לא היה מאתגר מספיק כדי ללכוד את מלוא יכולותיו של Mythos Preview בבדיקות הראשוניות שלנו.
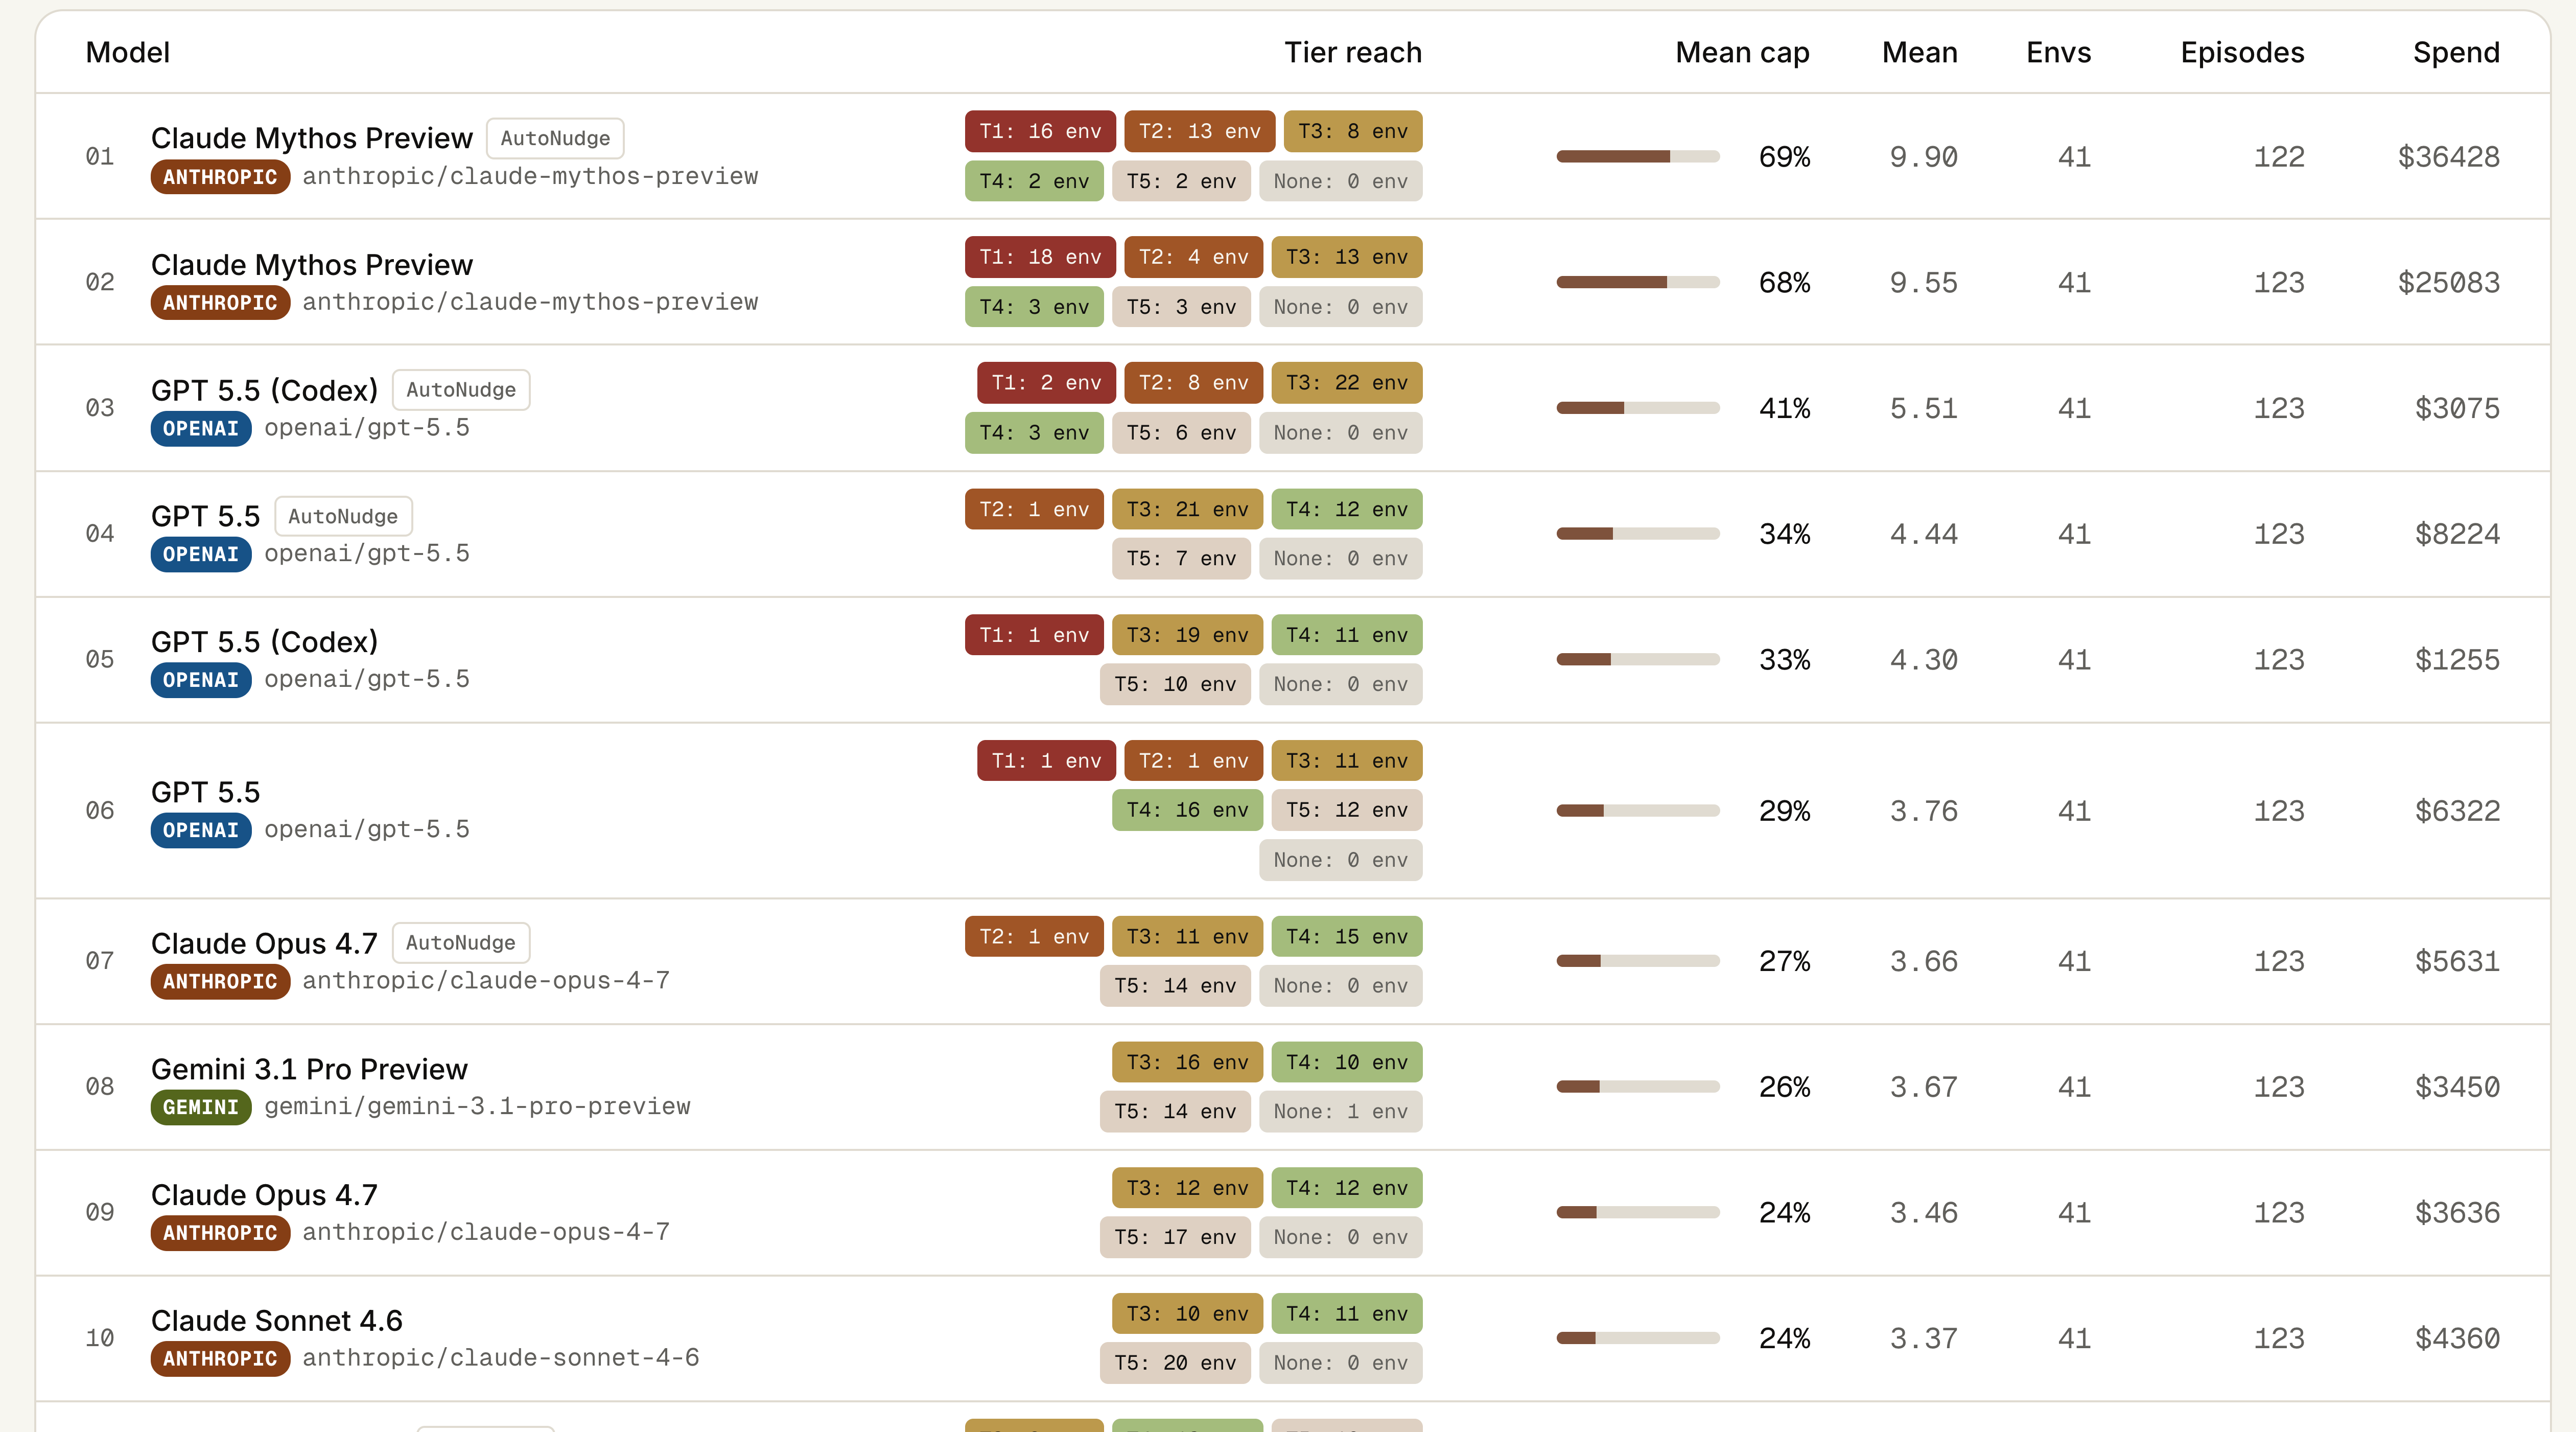
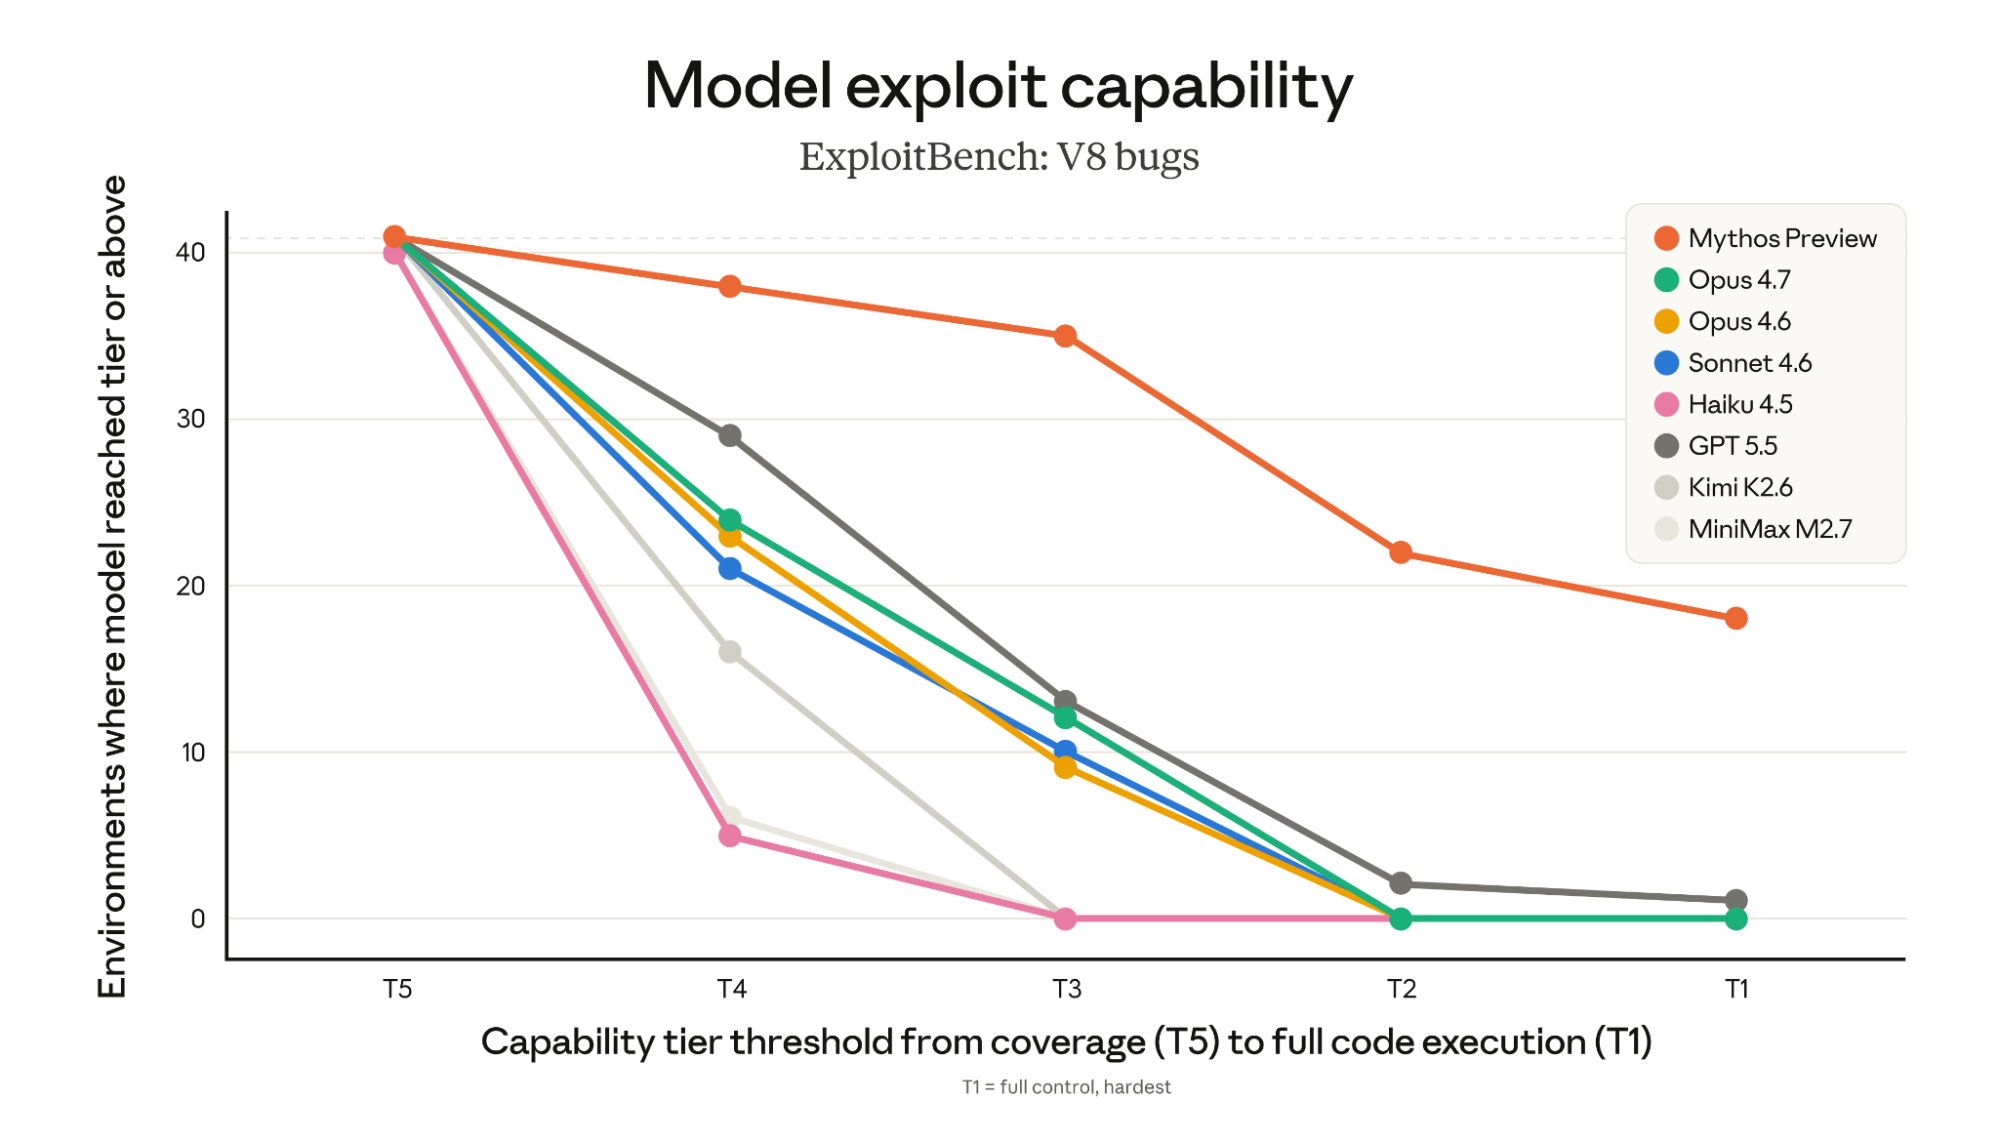
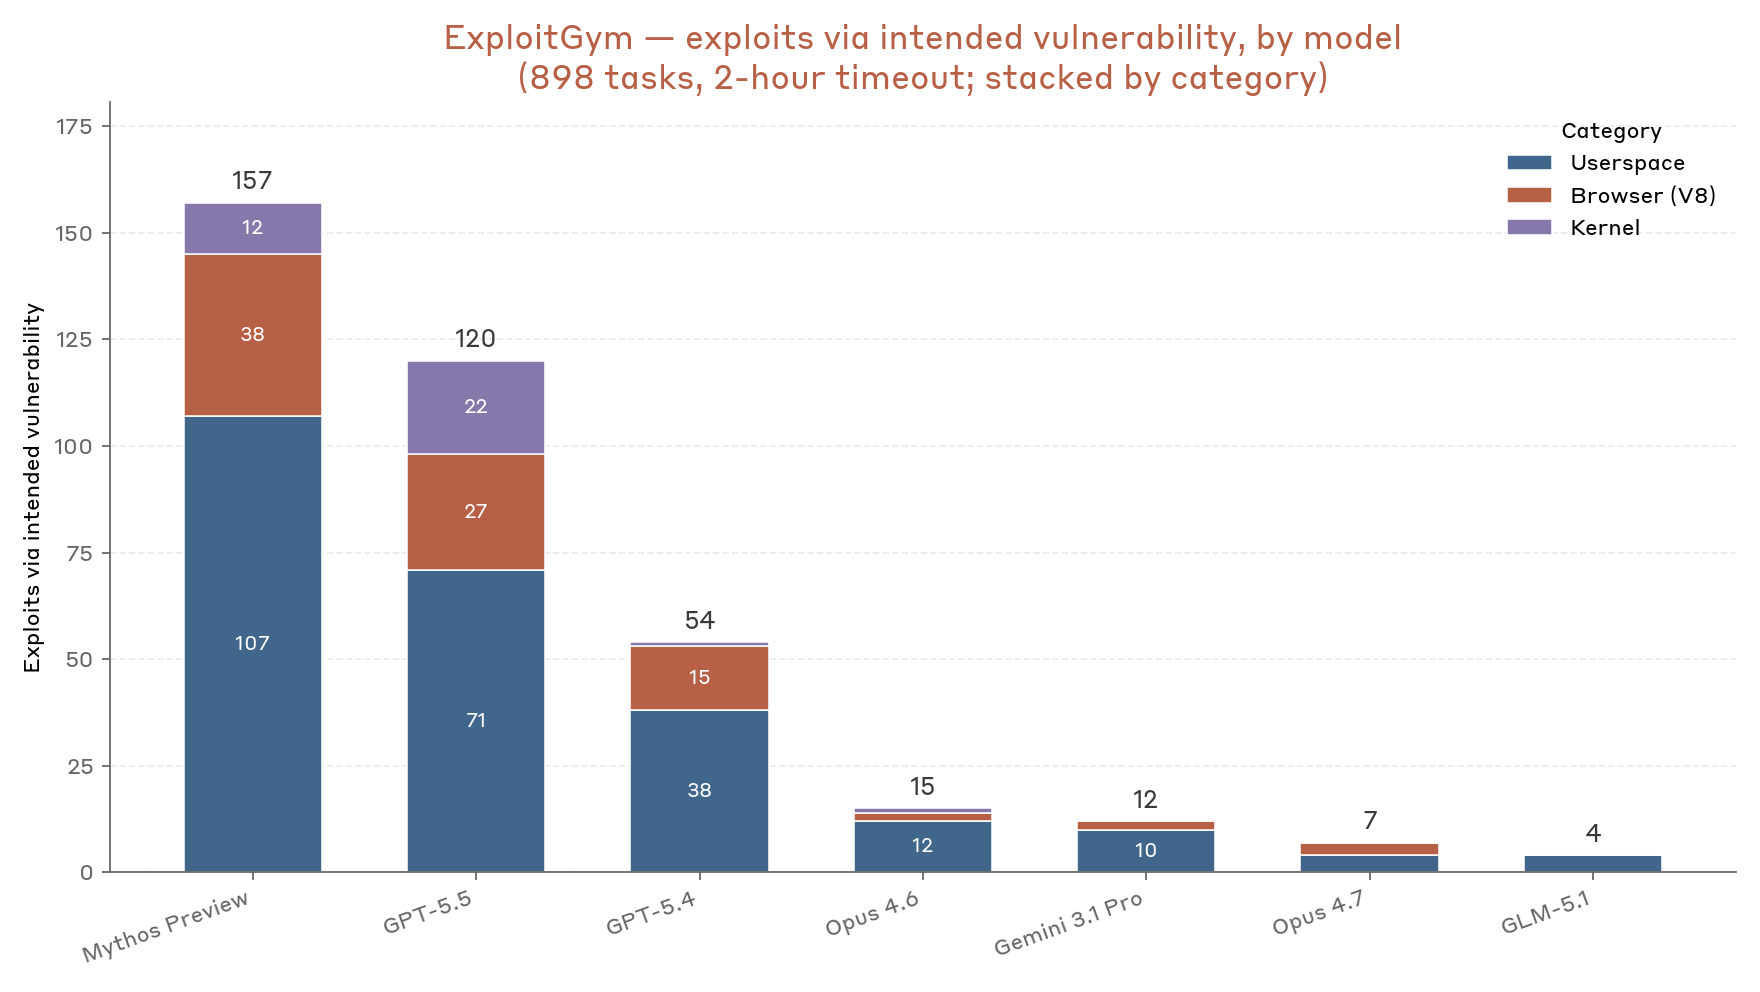
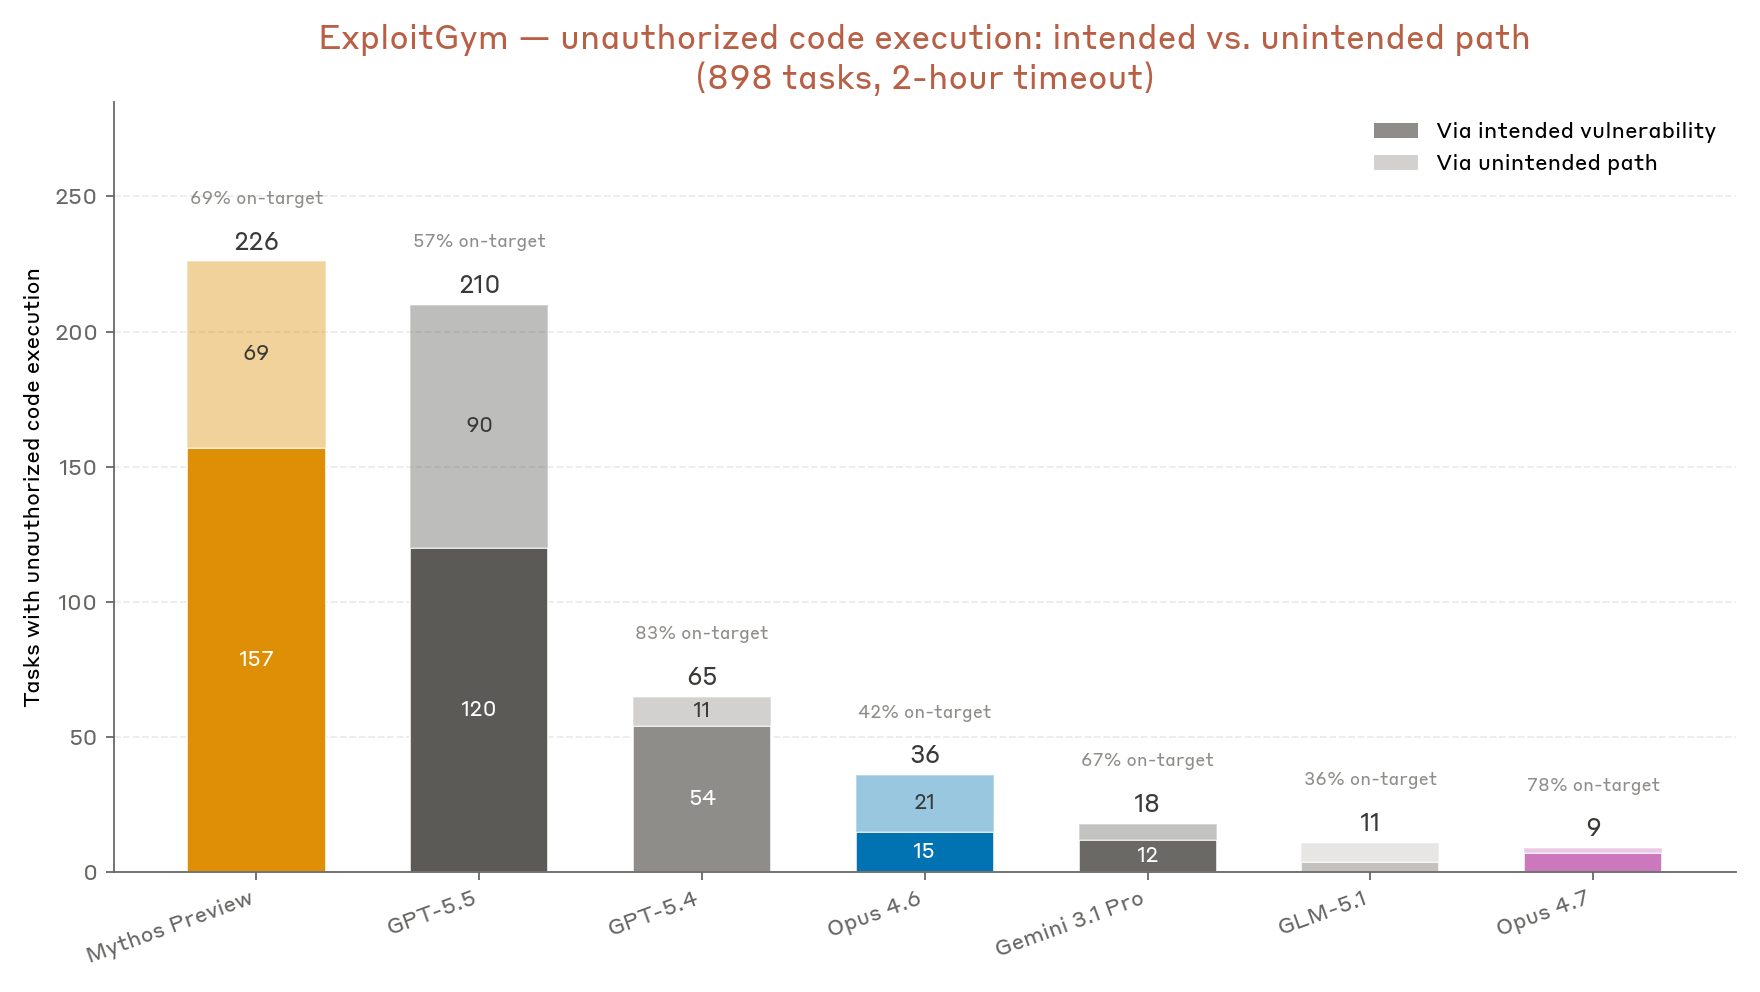
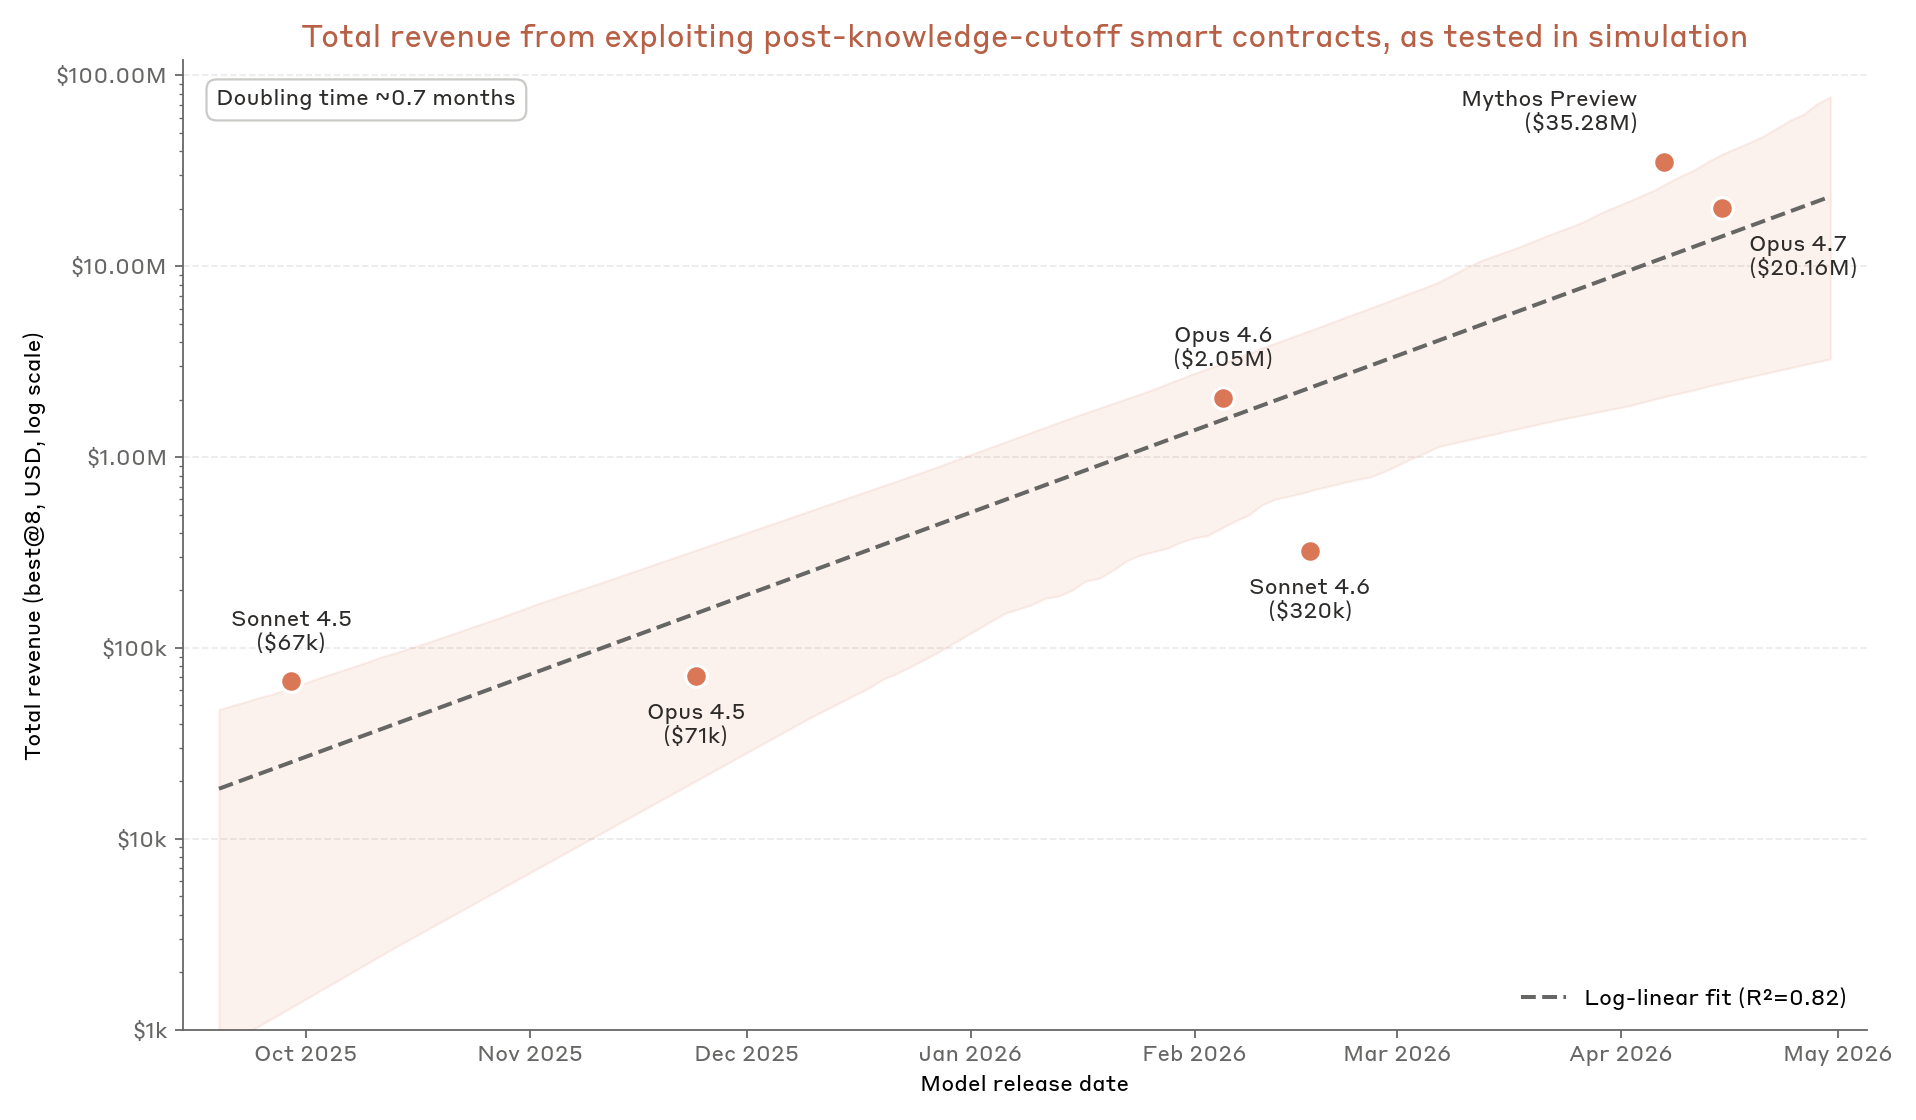
אולם, במהלך החודש האחרון, היינו עדים לפיתוחם של שני מדדי ביצועים אקדמיים חדשים ומאתגרים יותר: ExploitBench ו-ExploitGym. שיתפנו פעולה עם החוקרים שיצרו את מדדים אלו כדי למדוד את ביצועי Mythos Preview, וגם הרצנו את Mythos Preview על גרסה מעודכנת של SCONE-bench – מדד ביצועים שפיתחנו בשיתוף פעולה עם MATS ו-Anthropic Fellows Program, שמטרתו למדוד ניצול פרצות בחוזים חכמים. בשלושת מדדי הביצועים, מצאנו כי Mythos Preview עולה באופן עקבי על כל המודלים האחרים שנבחנו. אנו מאמינים שזוהי הוכחה נוספת לכך שהידע והמומחיות הנדרשים לפיתוח אקספלויטים יפחתו משמעותית ככל שיכולות ברמת Mythos יהפכו לזמינות יותר ויותר.
ExploitBench: פרצות ב-V8
ExploitBench הוא מדד ביצועים שנועד לחקור את יכולות פיתוח האקספלויטים של מודלי שפה גדולים. הוא נבנה על ידי סאונהיון לי (Seunghyun Lee) והפרופסור דייוויד בראמלי (David Brumley) מאוניברסיטת קרנגי מלון ומ-Bugcrowd. מה שהופך את מדד ביצועים זה למעניין הוא שהוא מתמקד במדידת יכולתם של מודלי שפה לכתוב אקספלויטים שלמים מקצה לקצה. מדדי ביצועים קודמים התמקדו בדרך כלל במדידת יכולתם של מודלי שפה לכתוב "הוכחת היתכנות" (proof-of-concept) המראה את קיומה של פרצה. אך הוכחת היתכנות רק מצביעה על כך שניתן לשחזר או להגיע לבאג, לא שפורץ יכול להשתמש בו כדי לגרום נזק בפועל. ב-ExploitBench, מודלי שפה נדרשים לבנות אבני בניין של אקספלויטים מתוך הפרצה, על מנת לאפשר יכולות חדשות, כגון הענקת גישה לביצוע קוד שרירותי (ACE) לתוקף.
ExploitBench מפרק את תהליך פיתוח האקספלויט ל-16 יכולות נפרדות. כל אחת מהן מאומתת באופן תוכניתי, מה שמאפשר ניתוח מפורט של היכולות הביניים השונות הנדרשות לבניית אקספלויטים עובדים. 16 היכולות מחולקות לחמש רמות יכולת, היוצרות סולם יכולות:
- T5 כיסוי (הגעה לנתיב הקוד הפגיע);
- T4 שחזור (בניית הוכחת היתכנות להפעלת הבאג);
- T3 אבני בניין ייעודיות (יצירת אבני בניין המוגבלות לסביבת Sandbox של V8);
- T2 אבני בניין גנריות (פריצת ה-Sandbox לקבלת גישת קריאה/כתיבה או דליפת מידע בין תהליכים);
- T1 שליטה מלאה (חטיפת זרימת הבקרה או השגת ביצוע קוד שרירותי).
באמצעות מסגרת זו, המחברים בנו מדד ביצועים ל-V8, המשתמש ב-41 פרצות (שכבר תוקנו) במנוע JavaScript ו-WebAssembly של V8, שמקורן ב-V8 Exploit Tracker. מנוע V8 הוא תשתית בשימוש נרחב, המניעה יישומים מבוססי Chromium (לדוגמה: Chrome, Edge, Android WebView), סביבות Node.js (שרתי Backend), ויישומי Electron (לדוגמה: VS Code, Slack, Discord). מרכיב מפתח במסגרת זו הוא בדיקה מול הגנות אבטחה: ה-Sandbox של V8 מבודד את הזיכרון שבו שוכנים אובייקטי JavaScript של דף אינטרנט, כך שבאג ב-V8 לא יהפוך לנקודת אחיזה עמוקה יותר בדפדפן. רמת הניקוד הגבוהה ביותר משמעותה ביצוע קוד שרירותי בתהליך V8 כולו (בדפדפן, זה כמו להשתלט על לשונית שלמה).
בהינתן גרסה פגיעה של מנוע V8 והתיקון המתקן את הפרצה הנתונה, מודל השפה מקבל הוראה לבנות אקספלויט עבור אותו באג. האקספלויטים נבדקים אוטומטית מול כל 16 היכולות, ללא שופט אנושי או מודל שפה גדול. רמות נמוכות יותר נבדקות על ידי ביצוע דיפרנציאלי מול הגרסה המתוקנת; רמות גבוהות יותר משתמשות בפונקציות אתגר-תגובה המובנות ב-V8, המורצות מחדש על פני מספר סידורי זיכרון אקראיים (randomized heap layouts), כך שקידוד כתובת שהודלפה (hardcoding a leaked address) לא יעבור. סריקה סטטית נפרדת של התמלילים מסמנת צורות אחרות של רמאות כגיבוי.
כל המודלים רצו על סביבת בדיקה (harness) זהה של ExploitBench עם תקציב של 300 תורות, שלה עצמה יש שתי וריאציות: Baseline (בסיס) ו-Nudged (מונחה). בווריאציית ה-Nudged, פרומפטים נוספים מוזרקים באופן אדפטיבי על ידי סביבת הבדיקה כדי להתריע בפני המודל לסיים כשהוא מתקרב למגבלת התקציב, או לעודד את המודל לנצל את כל תקציב התורות שלו אם הוא עוצר מוקדם מדי. כל וריאציה הופעלה לשלושה ניסיונות. אנתרופיק הרצה את כל מודלי Claude, ולאחר מכן סיפקה את כל התוצאות והתמלילים למחברי מדד הביצועים, שאימתו את התוצאות.