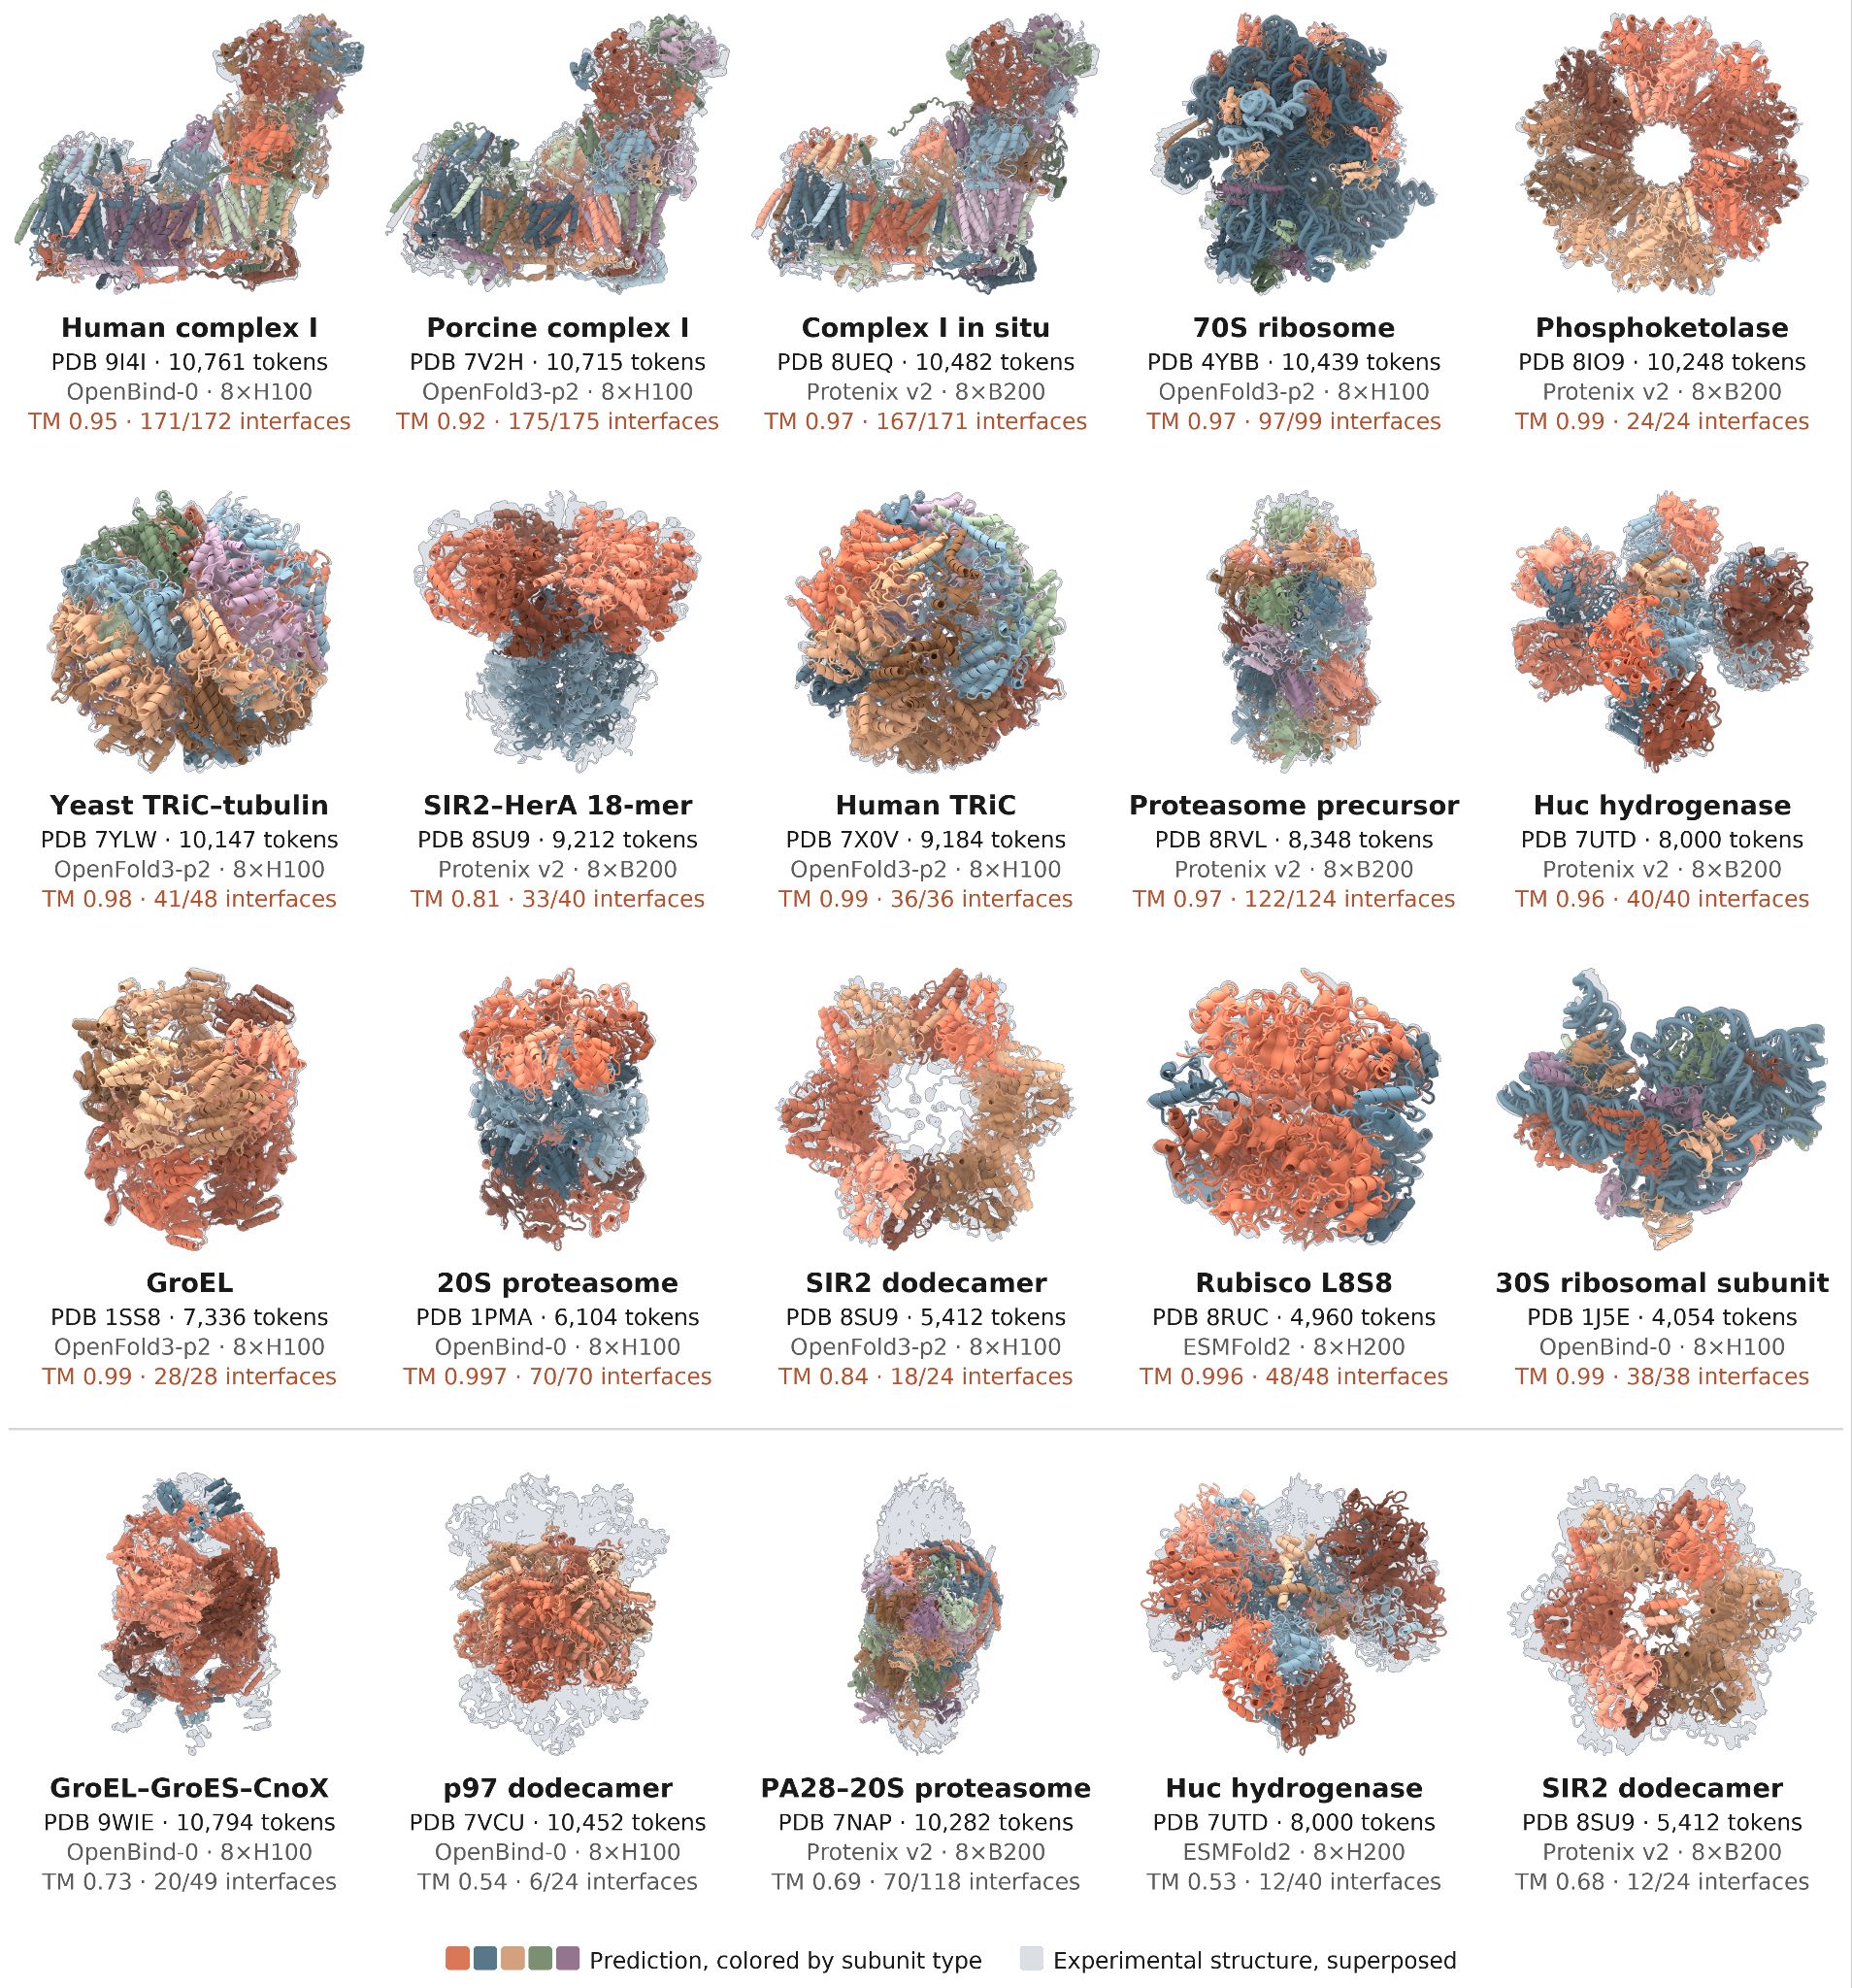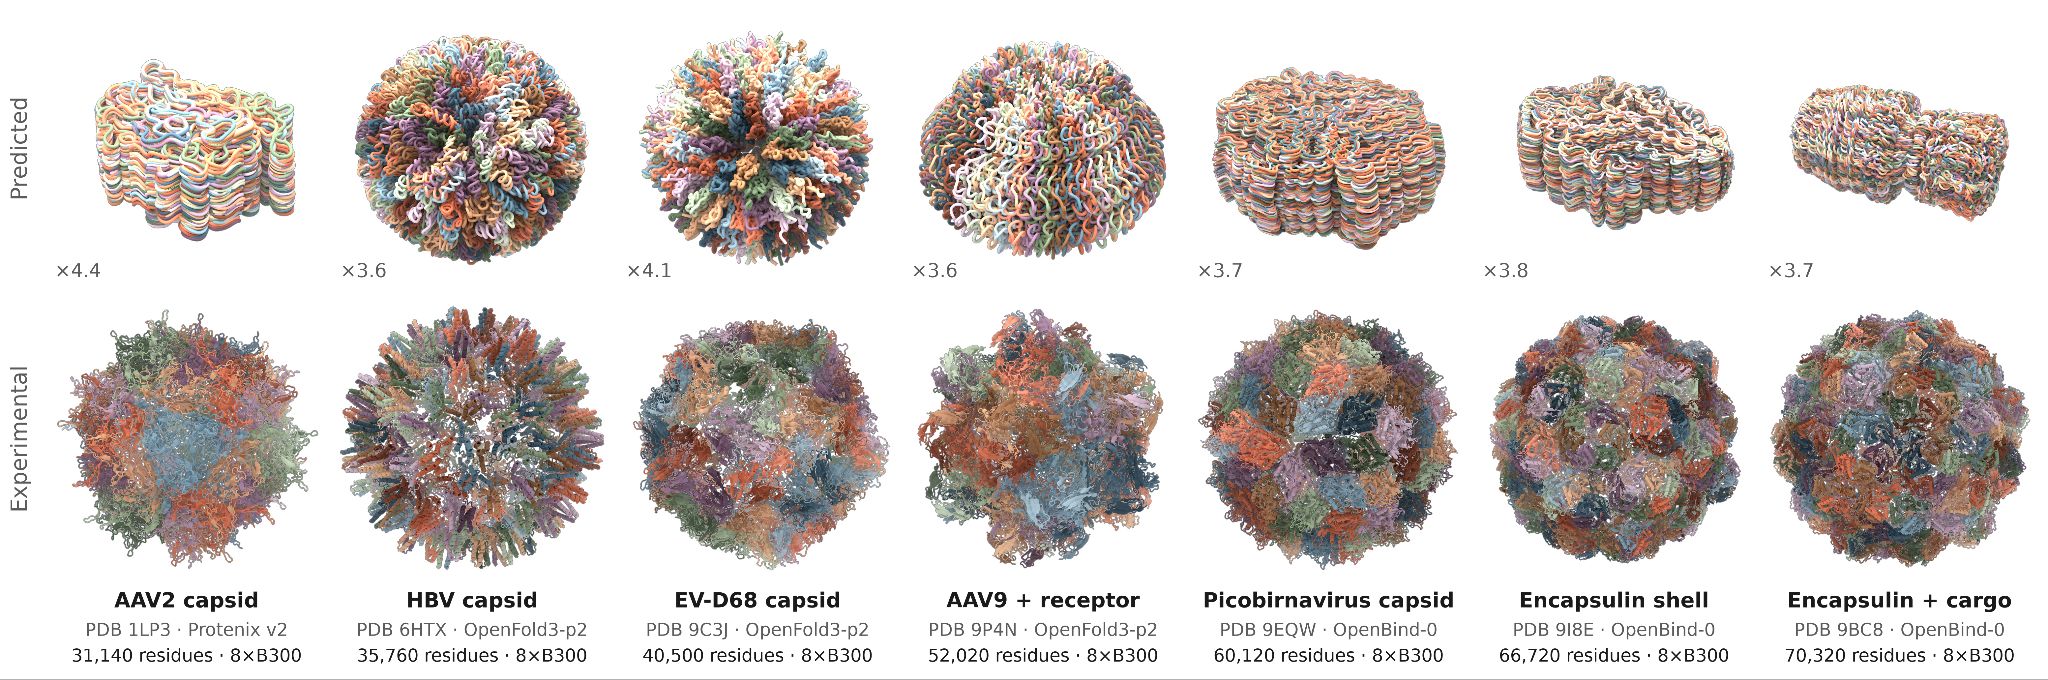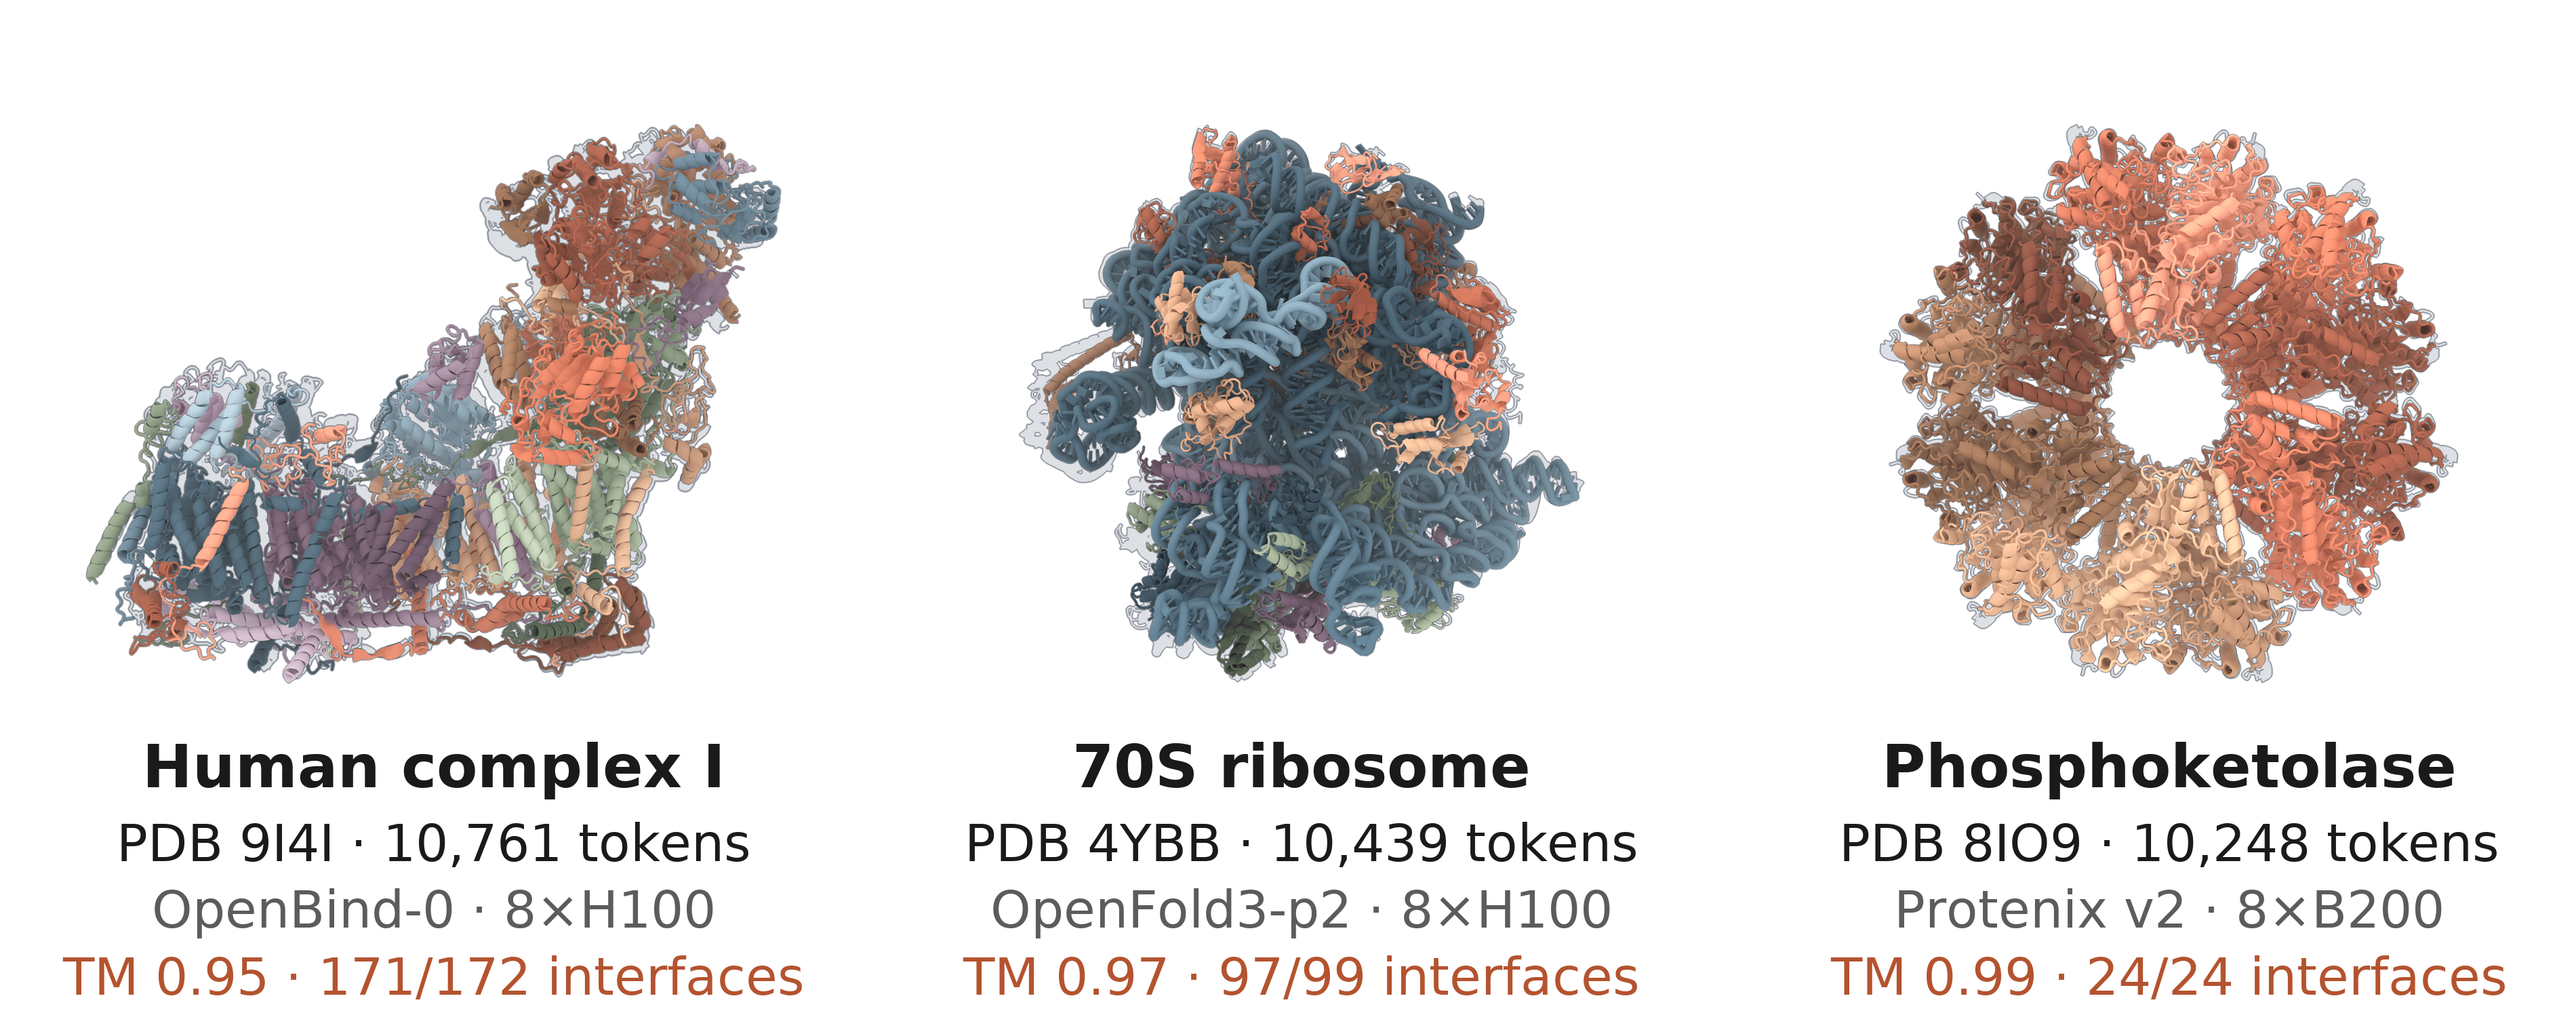
בפוסט זה, אנו חושפים כיצד Claude הצליח להפוך מודלי קוד פתוח, המשמשים מדענים לחיזוי ועיצוב ביומולקולות, למהירים ויעילים יותר בזיכרון. Claude ייעל למעלה מ-30 מודלים אלה תוך פחות מארבעה שבועות, והאיץ אותם בממוצע פי 4. המודל גם יצר מצב 'זיכרון נמוך' המאפשר חיזוי מדויק של מערכות ביומולקולריות גדולות מ-10,000 טוקנים (חומצות אמינו, נוקלאוטידים ואטומים ממולקולות קטנות ויונים) על גבי יחידת NVIDIA GPU יחידה. אנו מפרסמים בקוד פתוח את כל הקוד הממוטב ומכריזים על תחרות עיצוב חלבונים בחסות משותפת עם Adaptyv Bio, הנתמכת במימון של עד מיליון דולר בקרדיטים של Claude ואימות מעבדתי ליותר מ-5,000 עיצובים.
לאחרונה, פרסמנו תוצאות המדגימות את יכולותיו של Claude לעצב מקשרים חלבוניים de novo באמצעות ניהול ברמת מומחה של מודלי קוד פתוח לעיצוב חלבונים וחיזוי מבנה. מקשרים de novo הם חלבונים קטנים המעוצבים חישובית, הנקשרים בחוזקה למולקולת מטרה ספציפית כדי להפעיל, לחסום או לספק לה דבר מה.
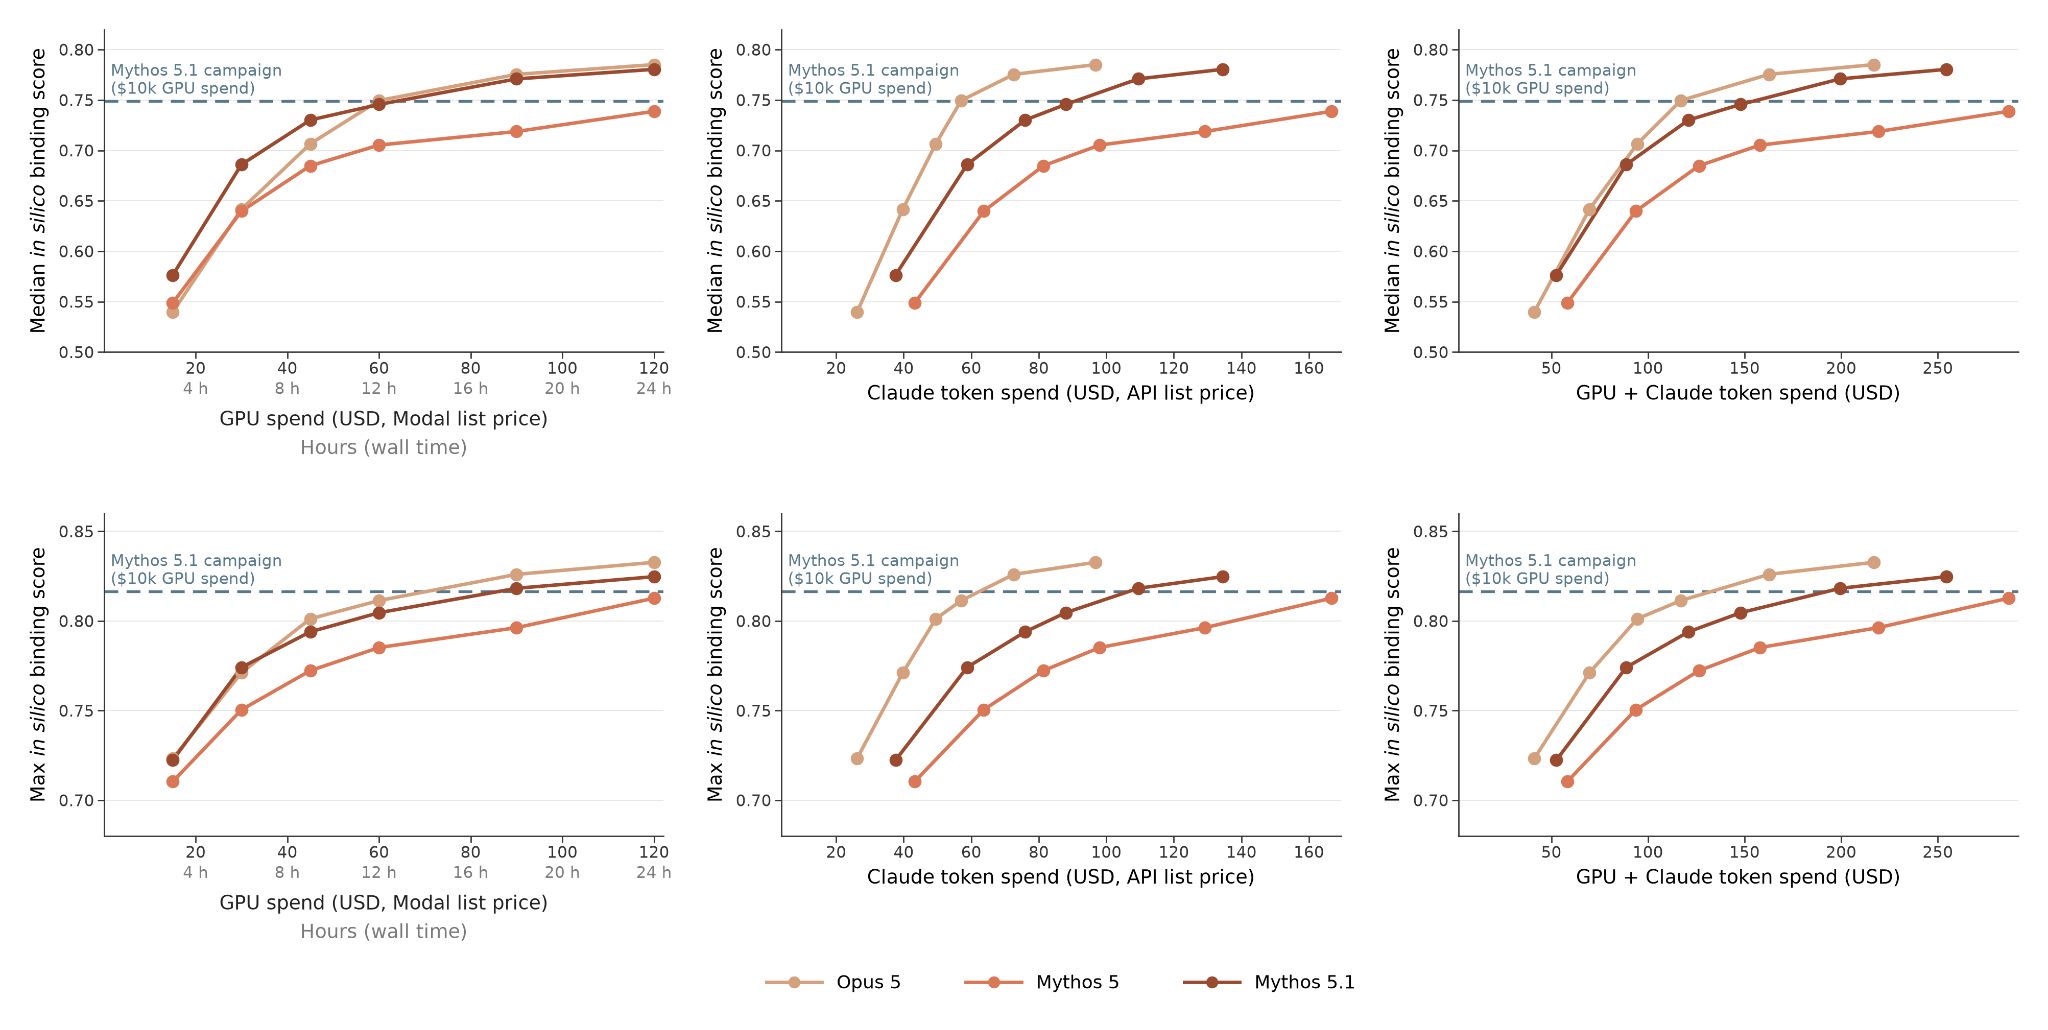
אף על פי שהייתה זו הדגמה מעודדת של יכולות ה-AI המדעיות וצעד מוקדם לקראת קידום גילוי תרופות, היא דרשה יותר משאבים מאשר זמינים לרוב המכריע של מעצבי החלבונים. אפשרנו ל-Claude להשקיע עד 10,000 דולר לכל מטרה בפלטפורמת תשתית ה-AI של Modal, שווה ערך לכ-2,500 שעות NVIDIA H100 GPU.
כדי להפוך מחקר כזה לנגיש יותר, התחלנו לבחון אופטימיזציות של הסקה (inference) כדי להריץ מודלים אלה ביעילות רבה יותר. כתוצאה מוקדמת של אופטימיזציות אלו, Claude Mythos 5.1 האיץ שבעה מודלים ביולוגיים בקוד פתוח, מה שאיפשר להם לרוץ מהר יותר עד פי 2.5.
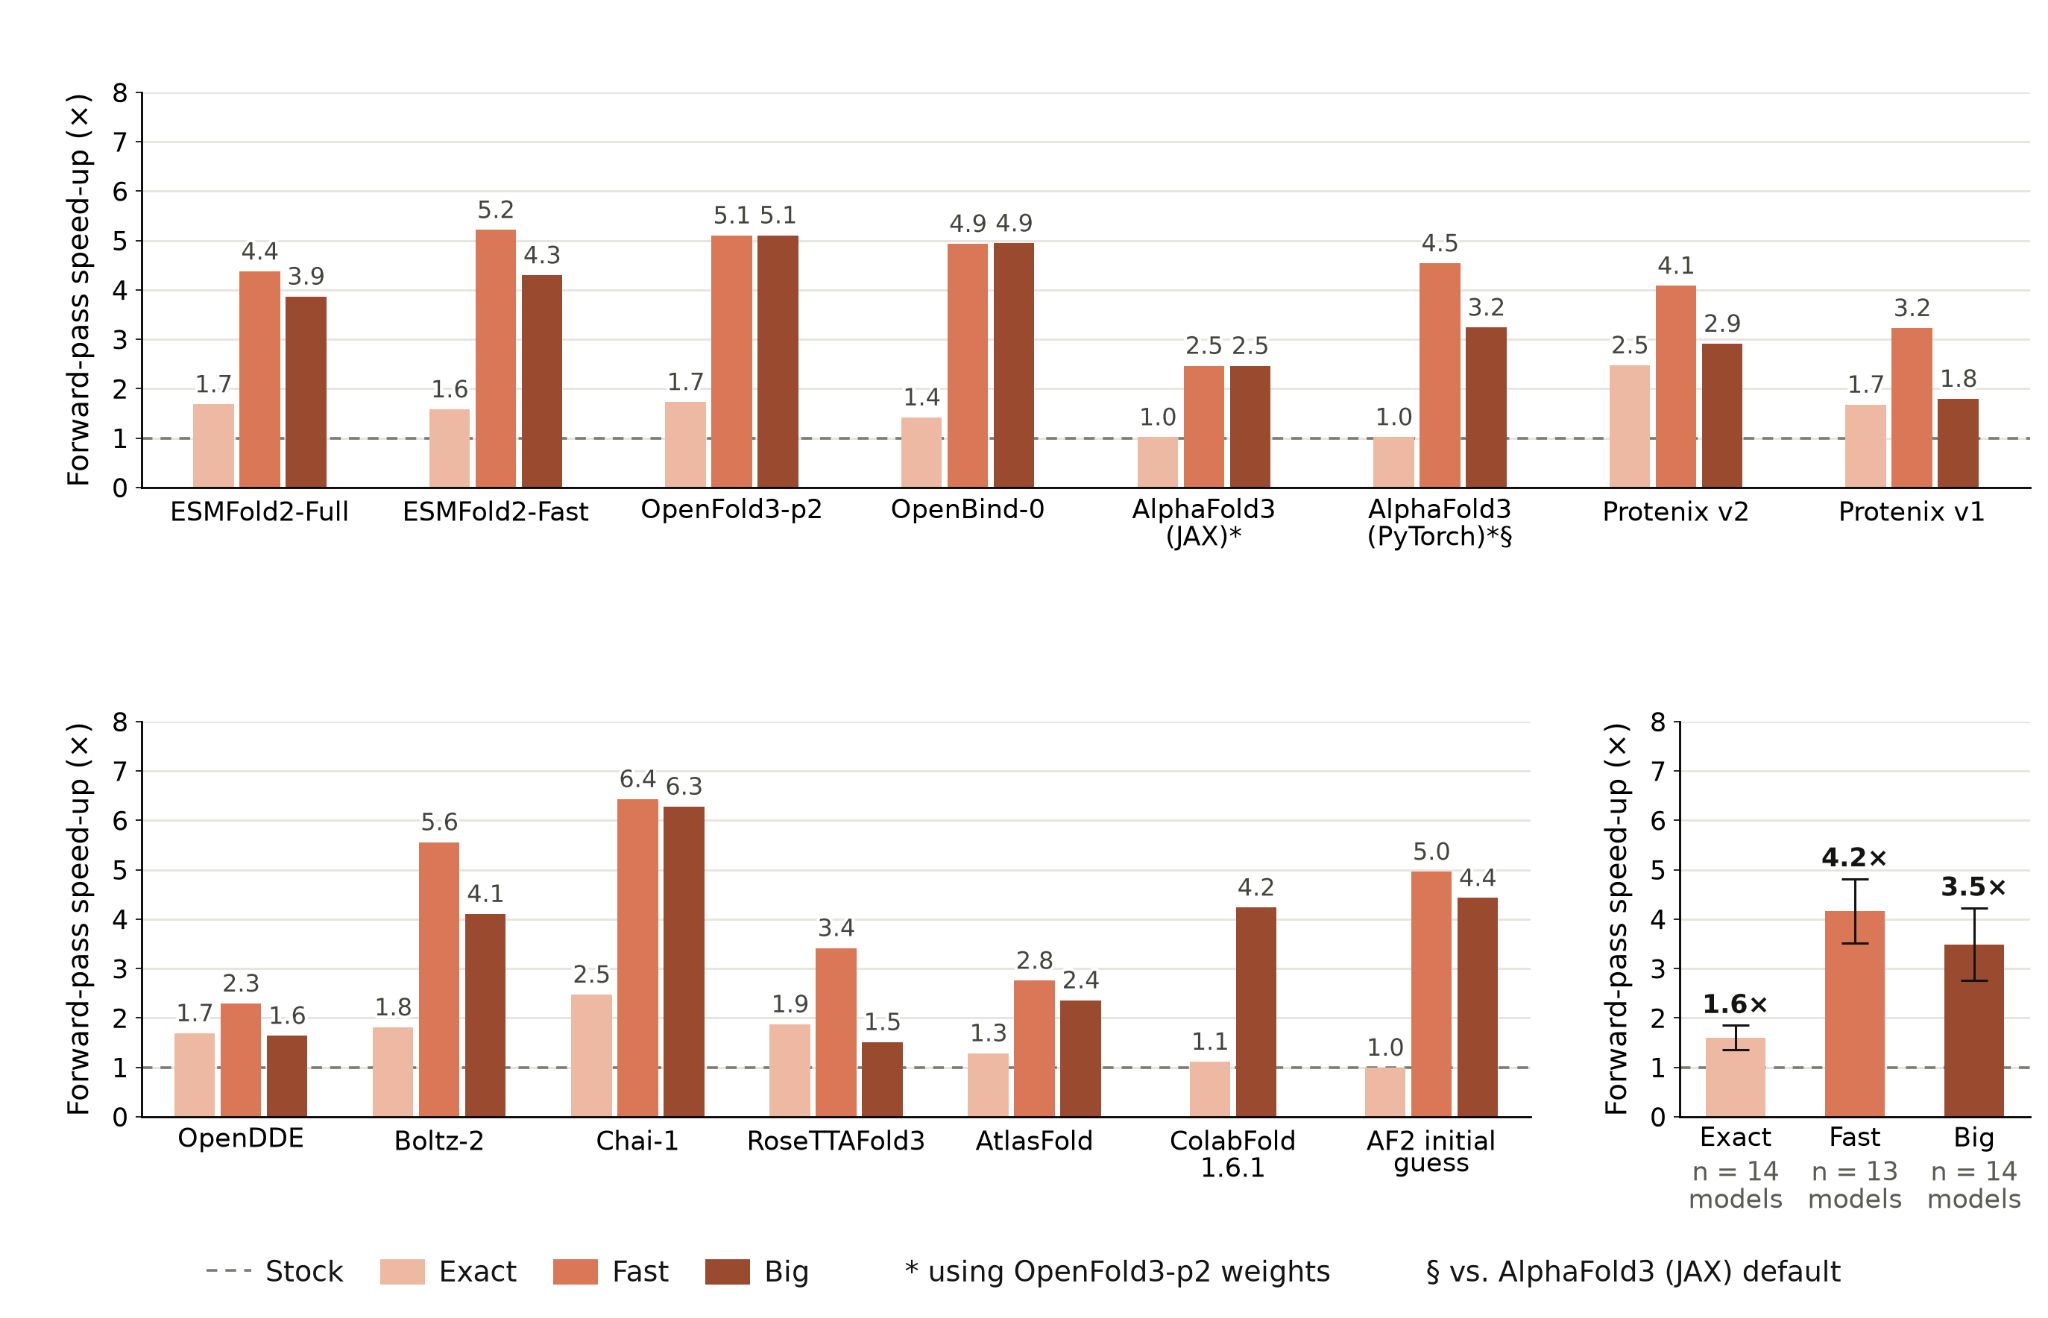
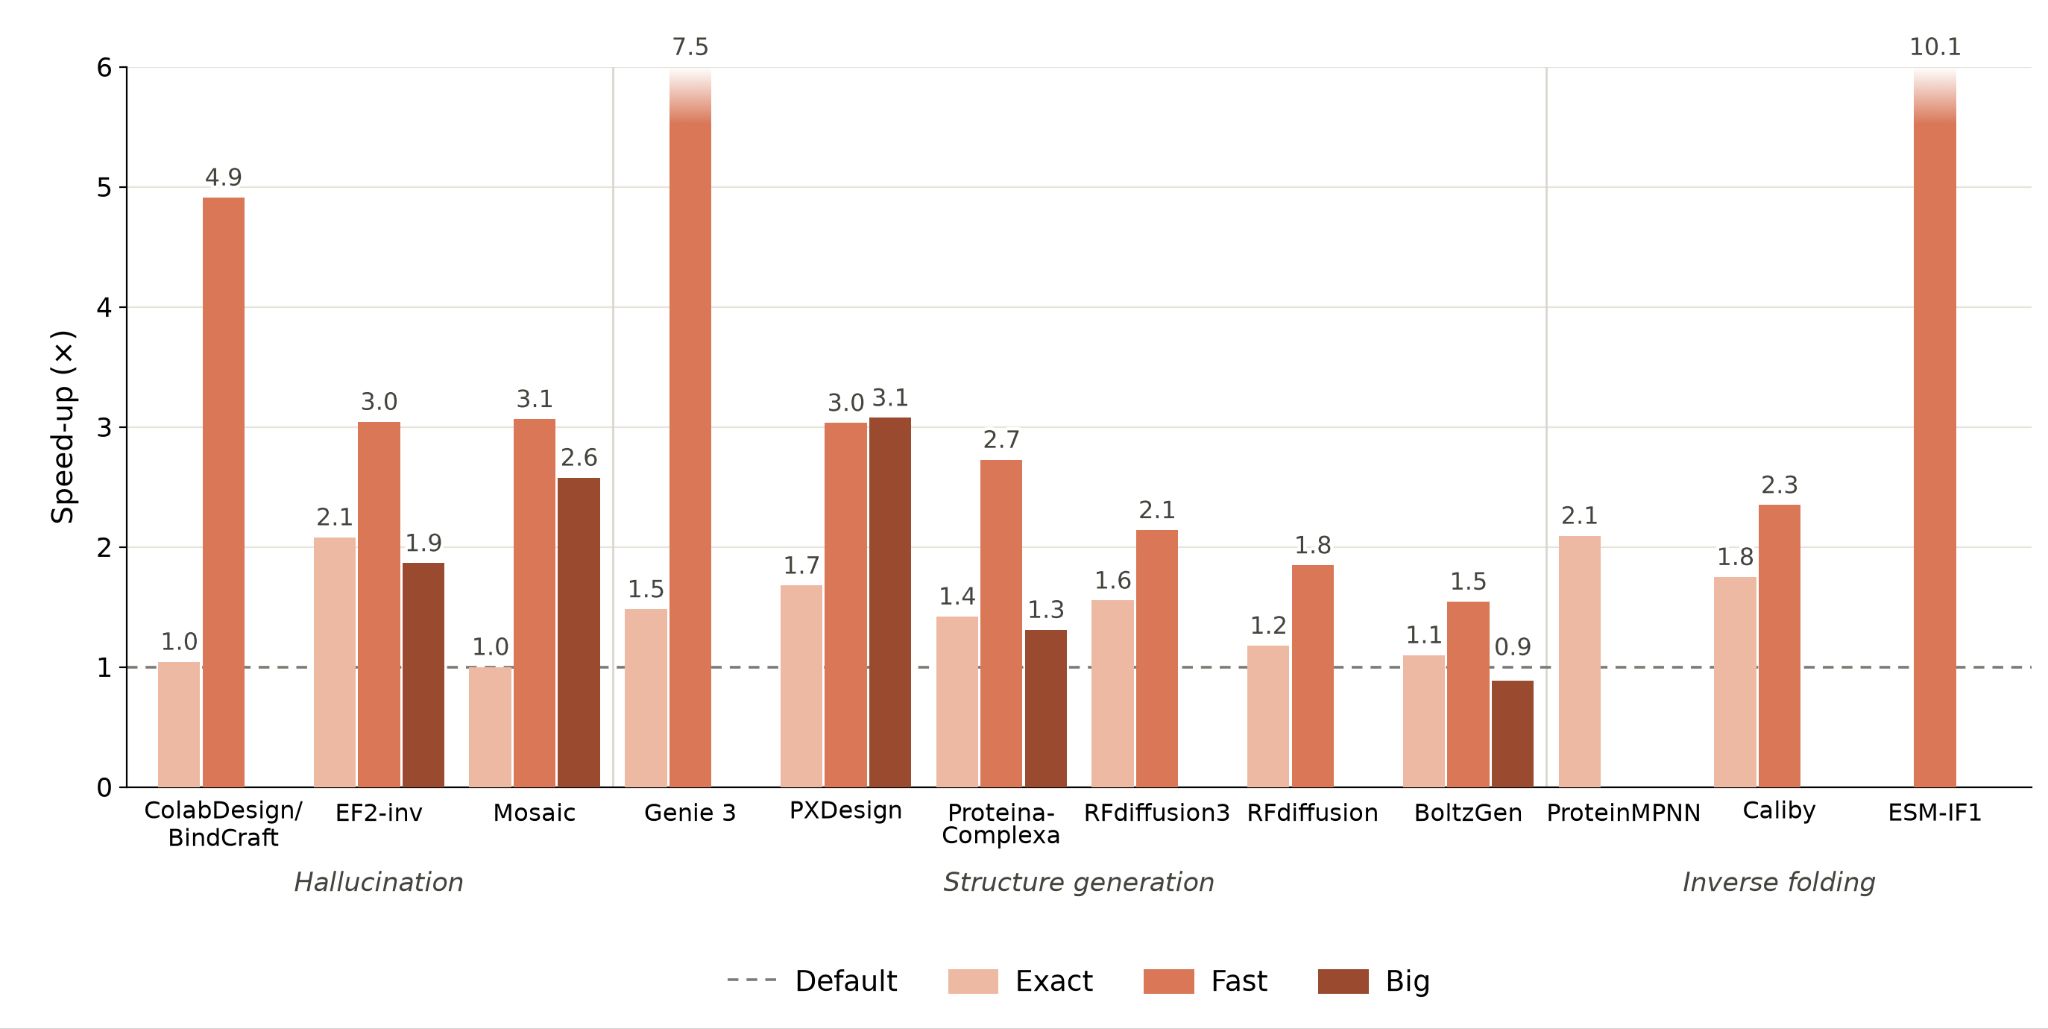
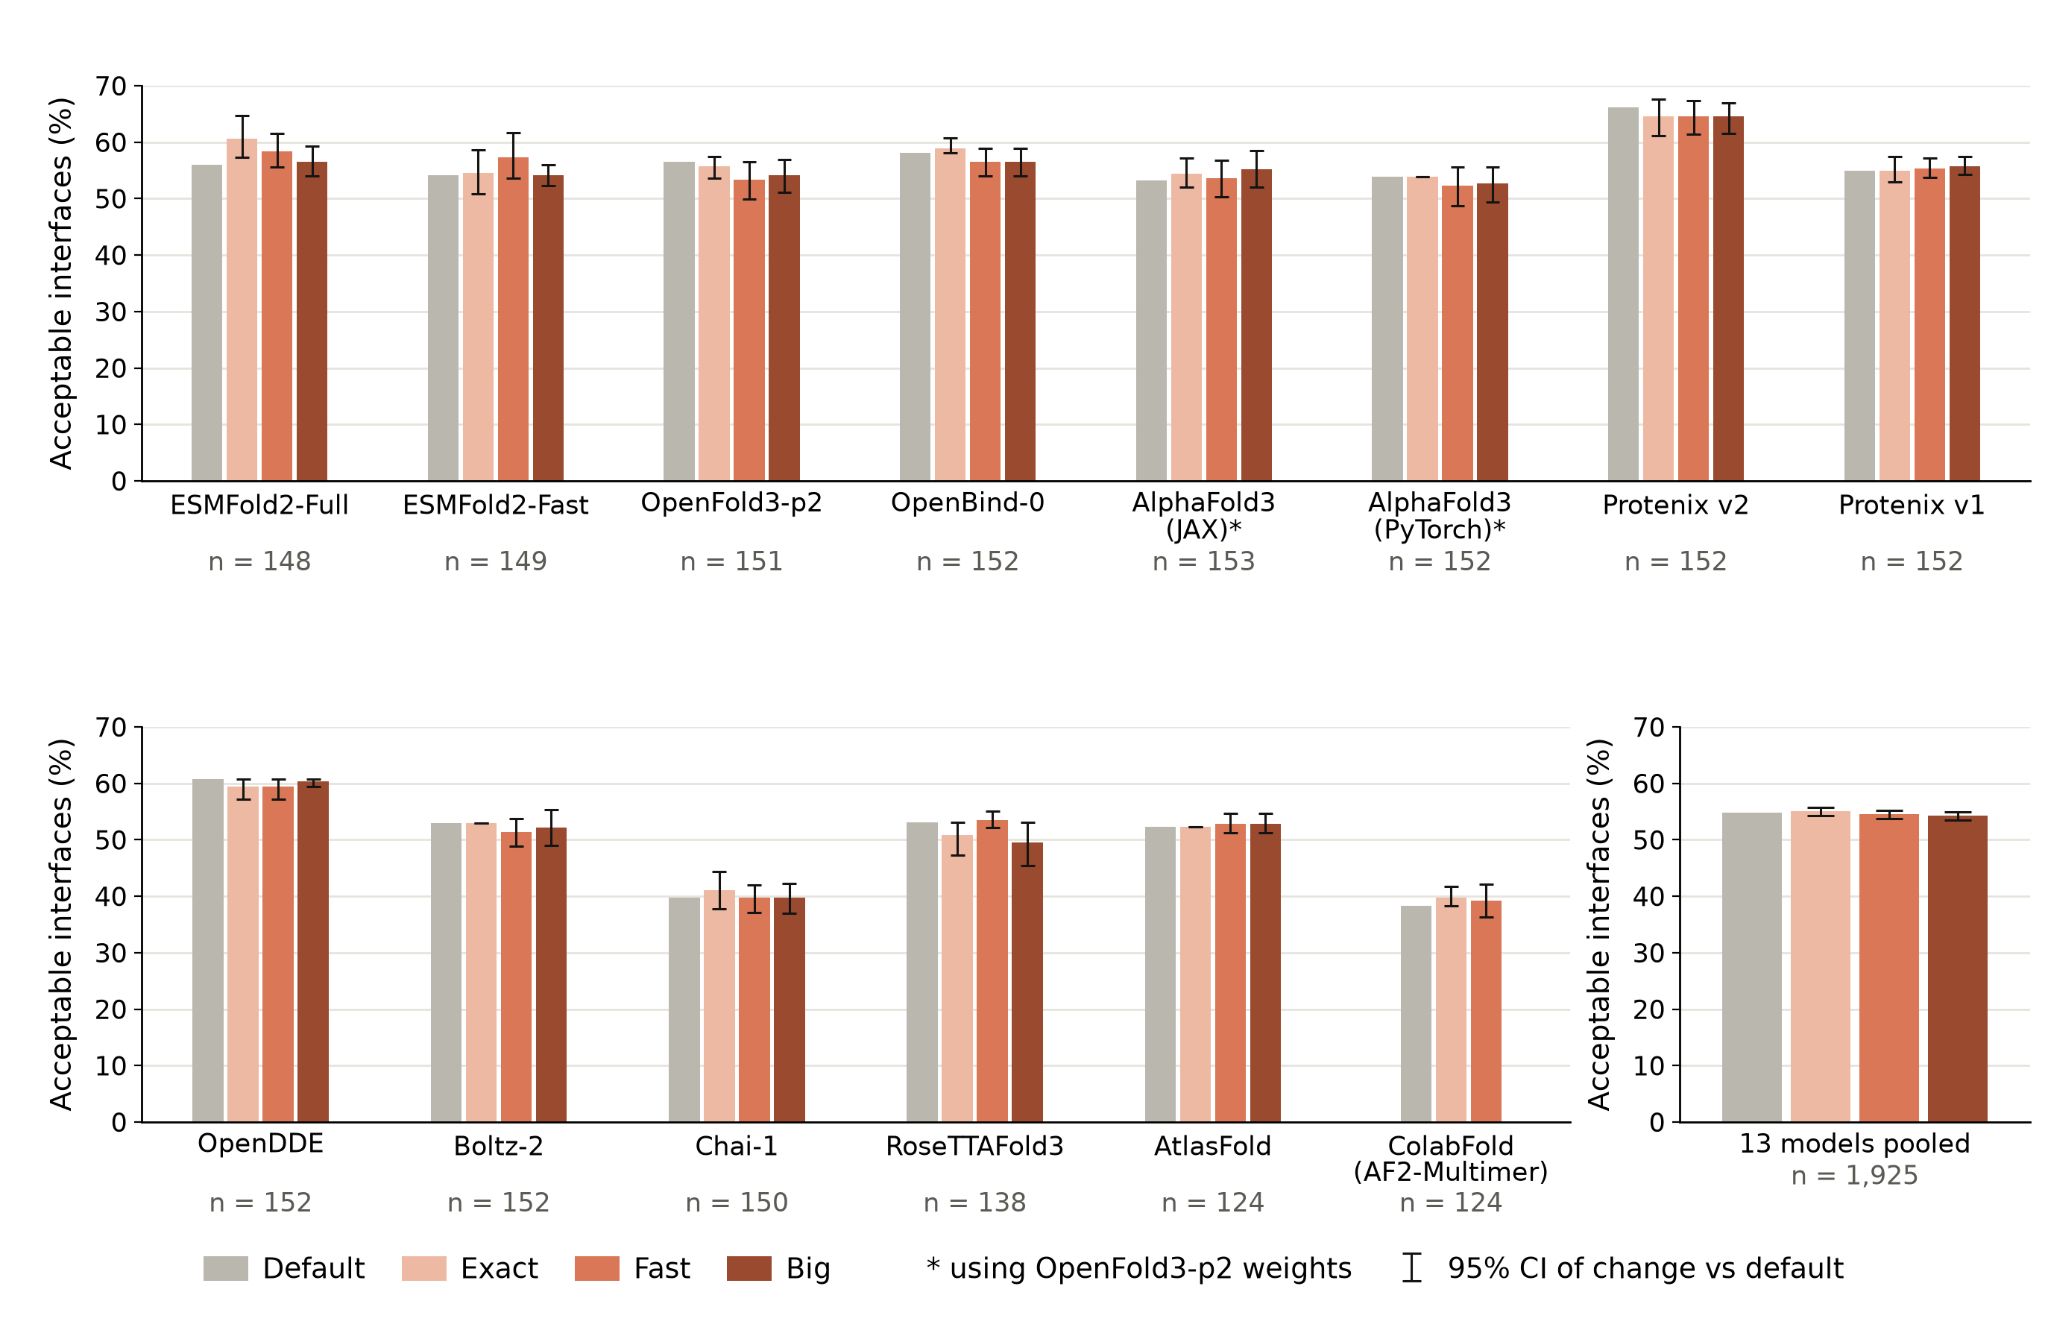
כאן, אנו מציגים תוצאות חדשות המראות כיצד מודל מחקר פנימי וכללי הצליח לייעל למעלה מ-30 מודלי למידה עמוקה (deep learning) שאומנו עבור מגוון משימות ביולוגיות, כגון חיזוי מבנה ועיצוב חלבונים, וכן עבור גנומיקה ומודלי שפה של חלבונים. בממוצע, Claude הצליח להאיץ משימות כאלה פי 4 בקירוב תוך הקרבה מינימלית של דיוק, וכמעט פי 2 עם פלטים זהים. Claude גם שיפר את ניצול הזיכרון של מודלים אלה, מה שאיפשר לחזות מערכות ביומולקולריות בגדלים חסרי תקדים. על ידי שילוב תוצאות אלו עם פישוטים לגישת עיצוב החלבונים הסוכני הקודמת שלנו, אנו מראים כי Claude יכול להשיג ביצועי in silico דומים לתוצאות שדיווחנו עליהן בעבר, תוך שימוש בפחות בשני סדרי גודל של שעות GPU.
מעבר לעיצוב חלבונים, מודלים ביולוגיים מיוחדים אלה נמצאים בשימוש נרחב על ידי ביולוגים מולקולריים, כולל למטרות גילוי ופיתוח תרופות. אנו מפרסמים בקוד פתוח את הקוד הממוטב לכל המודלים הללו היום (כאן) כדי שהקהילה הרחבה תוכל להשתמש בהם. פרטים נוספים ניתן למצוא בדוח הטכני שלנו (כאן).
כדי לתמוך עוד יותר בקהילה, אנו גם נותנים חסות משותפת לתחרות עיצוב חלבונים עם Adaptyv Bio, שחלוצה בתחרויות עיצוב חלבונים פתוחות. בחרנו יחד חמש בעיות מאתגרות הנמצאות בחזית היכולות של היום. יחד עם Adaptyv, ובזכות תרומות נדיבות מ-Modal ו-Twist Bioscience, אנו מתחייבים לספק עד מיליון דולר בקרדיטים ל-Claude ו-250,000 דולר בקרדיטים חישוביים של Modal, בנוסף לאימות מעבדתי עבור למעלה מ-5,000 עיצובים. מידע נוסף ניתן למצוא (כאן) וכן להגיש מועמדות כאן.
האצת מודלי חיזוי ועיצוב מבני חלבונים
חיזוי מבנה חלבון הוא בעיית קביעת המבנה התלת-ממדי של חלבון מרצף חומצות האמינו שלו בלבד. עיצוב חלבונים, לעומת זאת, הוא תהליך יצירת חלבון בעל מבנה, תפקוד או קבוצת תכונות ספציפיות. יחד, כלים חישוביים אלה מאפשרים למדענים לחקור תהליכים ביומולקולריים מרכזיים, כמו אופן היווצרות סרטן, וליצור מולקולות שימושיות, כגון תרופות שיכולות לכוון לסוגי סרטן אלה.
מודלי חיזוי מבנה מודרניים, כגון AlphaFold3, OpenFold3 ו-Boltz-2, מקדישים חלק ניכר מזמן ההרצה החישובי והזיכרון שלהם לשתי פעולות: triangle attention ו-triangle multiplication, הפועלות על שלישיות של טוקנים. פעולות אלה מאפשרות למדל את הגיאומטריה של מערכות ביומולקולריות, אך הן יקרות חישובית ביותר, מכיוון שהן בעלות מורכבות מעוקבת הן בזמן הריצה והן בזיכרון: הכפלת גודל המערכת צורכת פי 8 יותר זמן וזיכרון, בעוד ששילוש גודלה צורך פי 27 יותר.
כתיבת kernels - שכבות תרגום תוכנה ברמה נמוכה עבור חומרת מחשוב מואצת כמו GPUs - היא גישה סטנדרטית להפחתת עלויות אלו. לאור חשיבותן, triangle attention ו-triangle multiplication היוו מוקד למאמצי פיתוח kernel ייעודיים, תחילה עם cuEquivariance של NVIDIA ולאחרונה עם BioNeMo Inference Runtime (BioNeMo-IR) של NVIDIA.
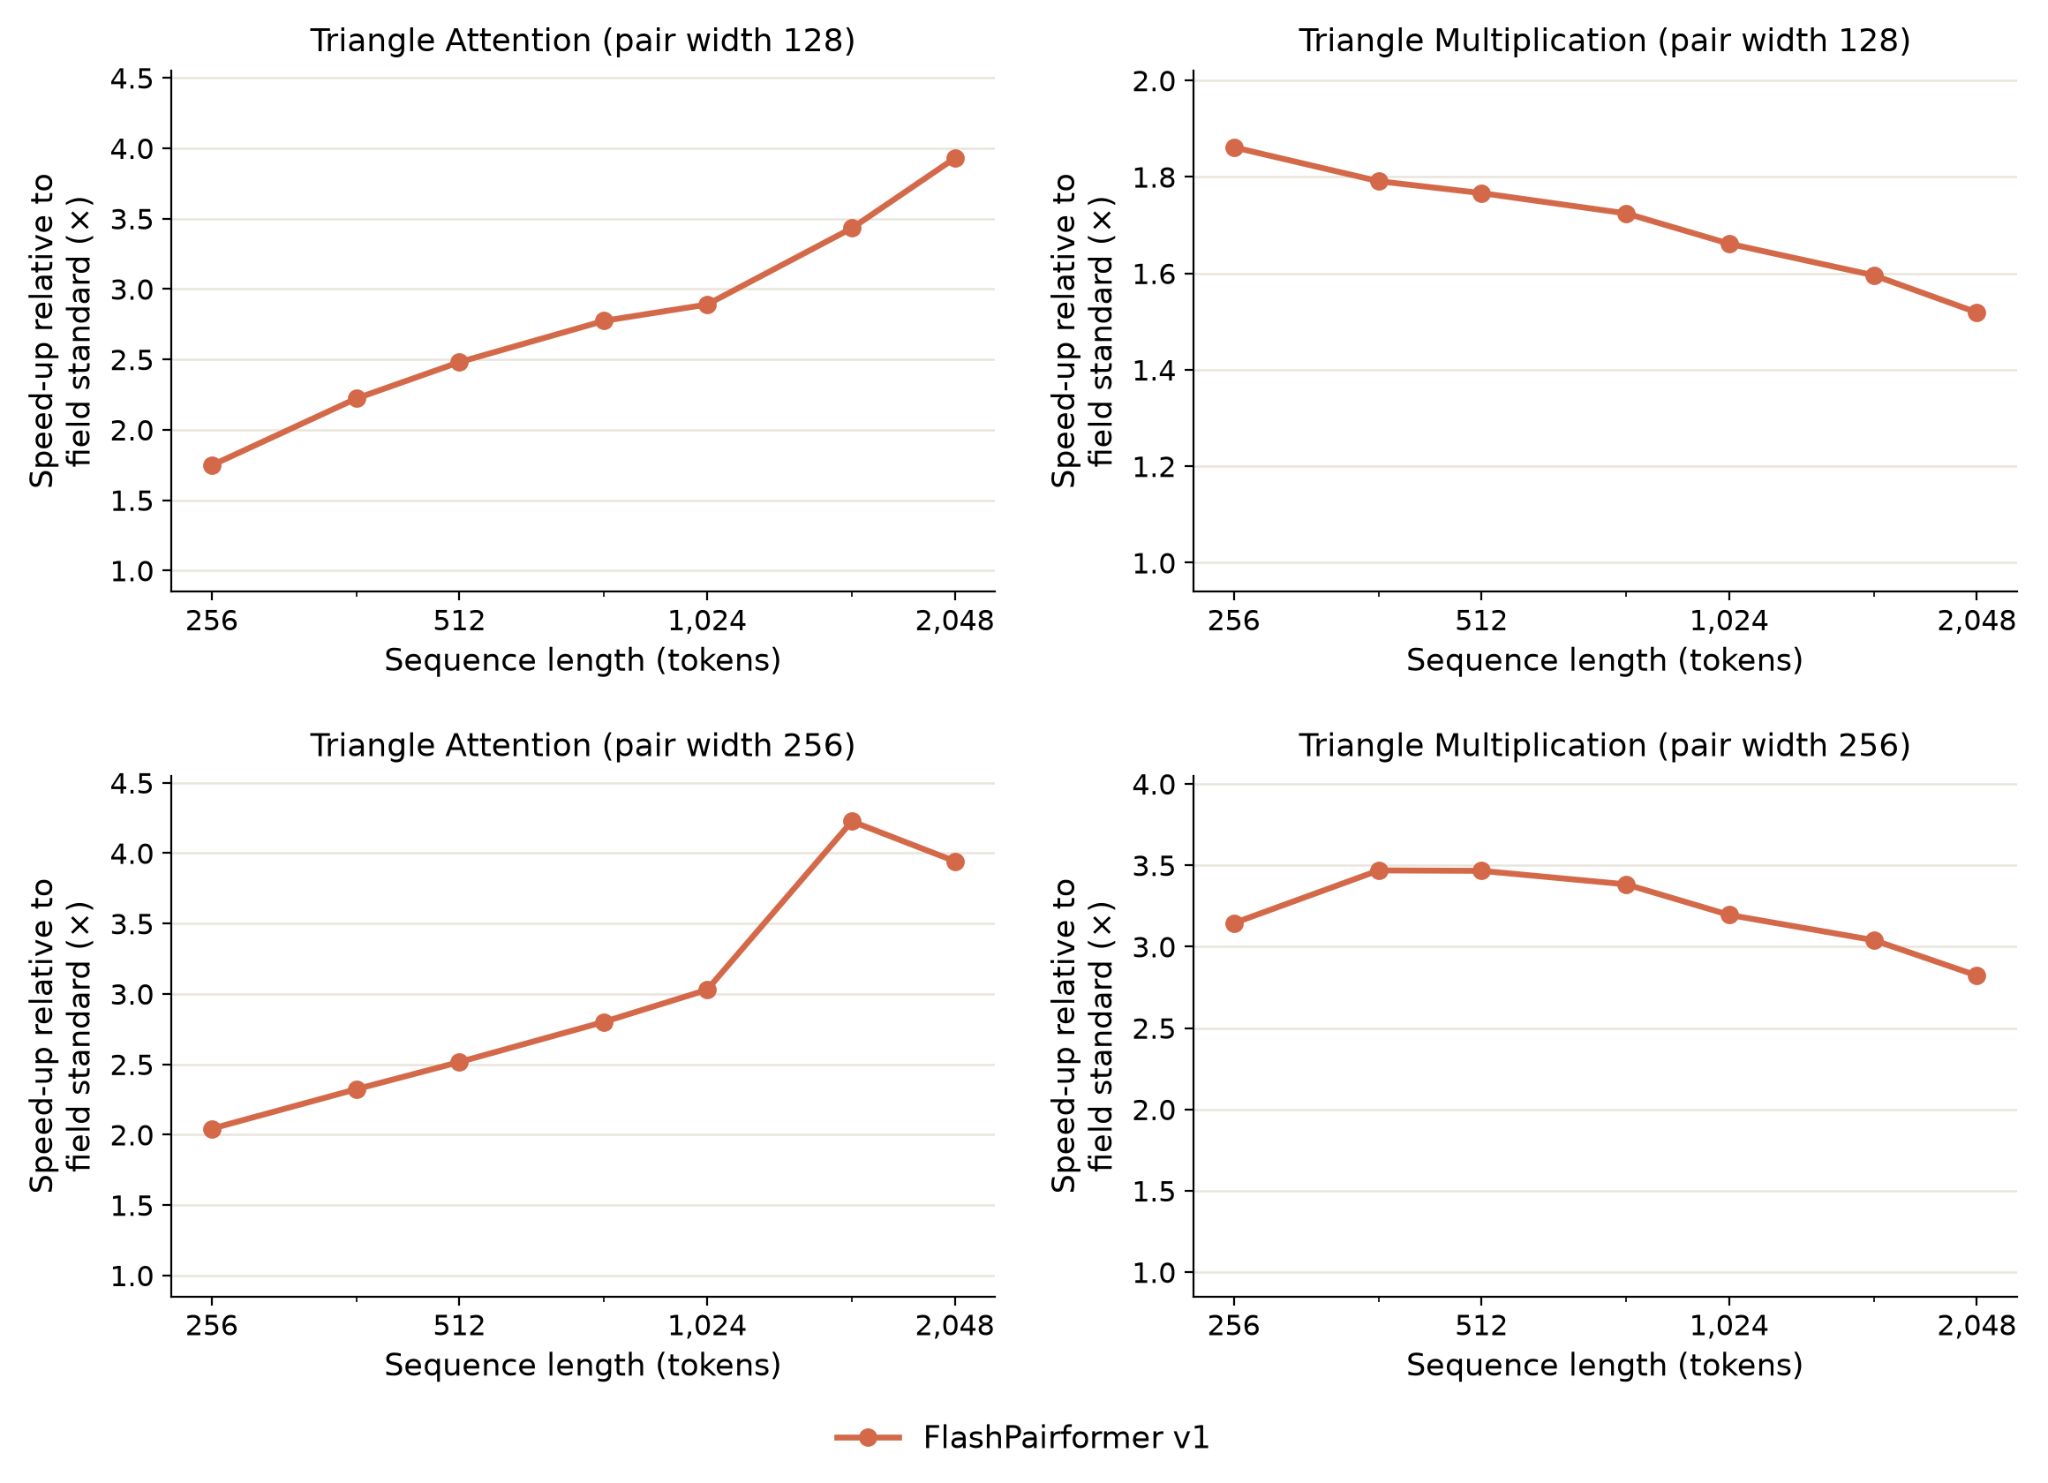
במסגרת המאמץ שלנו לייעל את הסקת המודלים לחיזוי מבנה, עבדנו עם Claude כדי לפתח את FlashPairformer, סט של kernels מותאמים אישית המאיצים את triangle attention ו-triangle multiplication. הוא משיג רמת ביצועים חדשנית (state-of-the-art), ועולה על הסטנדרט המקובל בתחום בממוצע פי 2.7-2.9 ב-triangle attention ופי 1.7-3.2 ב-triangle multiplication, בהתאם לתצורת המודל.
בנוסף לפיתוח kernels הניתנים להעברה, כיוונו את Claude לכל מודל בנפרד במטרה לייצר אופטימיזציות ספציפיות יותר. אלה כללו שינויים כמו שמירת עבודה חישובית מיותרת במטמון ופישוט ענפים מתים לפלטים קבועים. השילוב של שיפורים אלה האיץ את מודלי חיזוי המבנה פי 4 בממוצע, ועבור כל מודל, וידאנו כי הגרסאות המואצות של Claude לא פגעו בביצועים במשימה הסופית (כגון חיזוי מבנה).
בדרך כלל, נדרשים צוותי מהנדסים מנוסים שבועות רבים כדי לייצר אופטימיזציות כאלה עבור כל מודל, ולעיתים קרובות העבודה אינה ניתנת להעברה בין מודלים שונים. Claude, בפיקוחם של שני חברי צוות טכני של אנתרופיק המנוסים במודלים ביומולקולריים אך ללא ניסיון קודם באופטימיזציית הסקה או הנדסת kernels, ביצע את האצתם של למעלה מ-30 מודלי קוד פתוח בתחומי חיזוי מבנים ביומולקולריים, עיצוב חלבונים, מודלי שפה לחלבונים וגנומיקה, תוך פחות מארבעה שבועות בלבד. תוצאותינו מצביעות על כך שמודלי AI חזיתיים יסייעו לאחרים בתחום לבנות כלים מדעיים במהירות ובקלות רבה יותר.