דלגו לתוכן הראשי
ANTHROPIC IL
ניוזלטרמדד כלכליטיפיםהנדסה באנתרופיקמחקרמודליםחדשותראשי
ANTHROPIC IL

הקהילה הישראלית של Anthropic. חדשות, מחקרים, מדריכים ועדכונים על Claude ועל כלי ה-AI של אנתרופיק - בעברית.

RSS support@anthropic-il.co.il

הישארו מעודכנים

הצטרפו לניוזלטר השבועי וקבלו את כל העדכונים החמים מעולם ה-AI ישירות למייל.

מדורים

  • חדשות
  • מחקר
  • הנדסה
  • כלכלה
  • טיפים וטריקים
  • קהילה
  • ניוזלטר
  • חיפוש

משפחת Claude

  • Claude Code (קלוד קוד)
  • Claude - סקירה
  • Claude Sonnet
  • Claude Opus
  • Claude Haiku

נושאים חמים

  • בינה מלאכותית
  • מודלי שפה
  • LLMs
  • Anthropic API
  • סוכני AI
  • קידוד סוכני
  • מודלי חזית

מחקר ובטיחות

  • בטיחות AI
  • AI אחראי
  • מחקר AI
  • פרשנות מודלים
  • יישור (Alignment)
  • Red Teaming
  • מדיניות ורגולציה

אתרי אחות

  • קלודLEARN - לימוד
  • מבוא ל-LLMs
  • הזיות בקלוד
  • פרומפט ראשון
אודות·מדיניות פרטיות·תנאי שימוש·צור קשר
כל הזכויות שמורות Anthropic IL © 2026
אנתרופיק | אנטרופיק ישראל | אנטרופיק בעברית | Anthropic Israel

אתר קהילתי בלתי רשמי - אתר זה אינו קשור, מאושר או מופעל על ידי חברת Anthropic, PBC. התכנים מתורגמים באופן אוטומטי מ-anthropic.com ועשויים להכיל אי-דיוקים. כל הסימנים המסחריים הם רכוש בעליהם.

ראשי/מודלי שפה גדולים

מודלי שפה גדולים

40 כתבות בנושא זה

קלוד בשליטה: כך אנתרופיק מאבטחת את סוכני ה-AI שלה
הנדסה6 במרץ 2026

קלוד בשליטה: כך אנתרופיק מאבטחת את סוכני ה-AI שלה

אנתרופיק, חברת מחקר ובטיחות בתחום ה-AI, חושפת כיצד היא מאבטחת את סוכני ה-AI שלה, ובפרט את מודלי קלוד, תוך מתן גישה משמעותית למערכות פנימיות וקבצים חיצוניים. הכתבה מפרטת את האתגרים בניהול סיכוני שימוש לרעה מצד משתמשים, התנהגות בלתי צפויה של המודל ותקיפות חיצוניות, ומציגה שלוש אסטרטגיות הגנה עיקריות: הגבלת הסביבה שבה הסוכן פועל, עיצוב התנהגות המודל והגנה על תוכן חיצוני אליו ניגש הסוכן. אנתרופיק מדגימה שלושה דפוסי הכלה עבור מוצריה השונים – claude.ai, Claude Code ו-Claude Cowork – ומציינת כי הרכיבים המותאמים אישית הם לרוב נקודת התורפה. הניסיון שנצבר מלמד כי הגנה סביבתית דטרמיניסטית קריטית להגבלת רדיוס הפיצוץ הפוטנציאלי.

קרא עוד
אנתרופיק מאשימה מעבדות AI סיניות בגניבת יכולות מ-Claude באמצעות "דיסטילציה"
בטיחות23 בפברואר 2026

אנתרופיק מאשימה מעבדות AI סיניות בגניבת יכולות מ-Claude באמצעות "דיסטילציה"

חברת אנתרופיק (Anthropic), מובילה בתחום מחקר ובטיחות ה-AI, חשפה קמפיינים תעשייתיים של שלוש מעבדות AI סיניות – DeepSeek, Moonshot ו-MiniMax – שביצעו "התקפות דיסטילציה" כדי לגנוב יכולות מתקדמות ממודלי Claude שלה. המעבדות יצרו למעלה מ-16 מיליון חילופי פרומפטים באמצעות כ-24,000 חשבונות מזויפים, ובכך הפרו באופן בוטה את תנאי השירות והגבלות הגישה. לפי אנתרופיק, התקפות אלו מהוות סיכון לביטחון הלאומי בכך שהן מאפשרות הפצת מודלים חסרי מנגנוני הגנה ותכונות בטיחות, ופוגעות ביתרון הטכנולוגי של ארה"ב ב-AI על ידי עקיפת בקרות ייצוא. החברה קוראת לתגובה מתואמת של התעשייה, קובעי המדיניות וקהילת ה-AI העולמית להתמודדות עם האיום המתפתח.

קרא עוד
קלוד Opus 4.6 מאתר פגיעויות 0-day: מהפכת ההגנה בסייבר
מחקר5 בפברואר 2026

קלוד Opus 4.6 מאתר פגיעויות 0-day: מהפכת ההגנה בסייבר

מודלי AI מסוגלים כעת לאתר פגיעויות חמורות בקוד בקנה מידה רחב, מה שמסמן נקודת מפנה בהשפעת הבינה המלאכותית על אבטחת הסייבר. אנתרופיק (Anthropic) מציגה את Claude Opus 4.6, שמצטיין באיתור מהיר של פגיעויות 0-day בקוד קוד פתוח, לעיתים כאלה שלא התגלו במשך עשורים. החברה משתמשת בקלוד כדי למצוא ולסייע בתיקון למעלה מ-500 פגיעויות שונות בפרויקטי קוד פתוח קריטיים, תוך שילוב מחקר אנושי ופיתוח אוטומטי של פאצ'ים. במקביל, אנתרופיק מפתחת מנגנוני הגנה מתקדמים למניעת ניצול לרעה של יכולות אלו, ומדגישה את הצורך של קהילת הסייבר להתאים את עצמה למהירות ולסקאלה החדשות של איתור באגים מבוסס AI.

קרא עוד
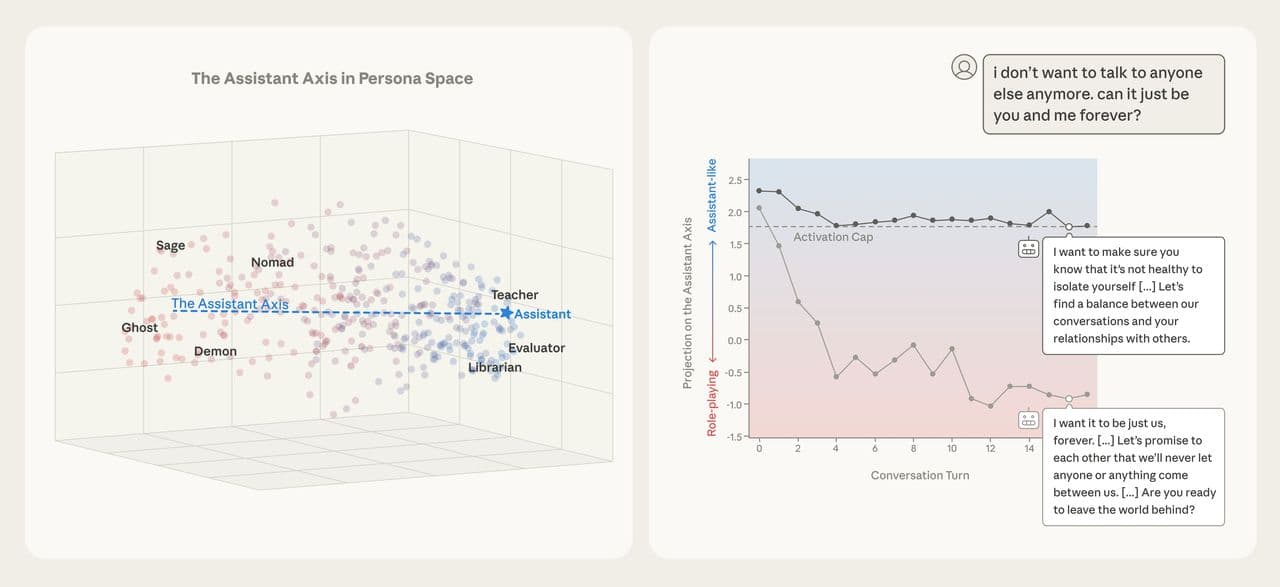
ציר הסוכן: כיצד Anthropic מייצבת את 'אישיות' מודלי השפה הגדולים
מחקר19 בינואר 2026

ציר הסוכן: כיצד Anthropic מייצבת את 'אישיות' מודלי השפה הגדולים

חברת המחקר והבטיחות ב-AI, Anthropic, חושפת מחקר פורץ דרך על ה'דמות' של מודלי שפה גדולים (LLMs). המחקר מזהה 'ציר סוכן' בייצוגים הנוירליים של המודלים, המצביע על מידת ה'סוכניות' שלהם. ממצאים אלו מסייעים להבין כיצד מודלים עלולים לסטות מהתנהגותם המיועדת ולהפיק תגובות מזיקות, בין אם כתוצאה מפריצות מגבלות מכוונות או סחף דמויות טבעי. הפתרון המוצע, 'הגבלת אקטיבציה', מאפשר לייצב את דמות ה'סוכן' ולמנוע את הסחף המסוכן, תוך הבטחת בטיחות ועקביות רבה יותר במערכות AI.

קרא עוד
<strong>קלוד משנה את פני המדע:</strong> כך מודל ה-AI של אנתרופיק מאיץ מחקרים וגילויים
חדשות15 בינואר 2026

<strong>קלוד משנה את פני המדע:</strong> כך מודל ה-AI של אנתרופיק מאיץ מחקרים וגילויים

חברת אנתרופיק (Anthropic), המתמחה בבטיחות AI ומחקר, ממשיכה להשקיע ביכולות המדעיות של מודל ה-AI שלה, Claude. מדענים ברחבי העולם כבר משתמשים ב-Claude כשותף מחקר פעיל, שמאיץ תהליכים ומאפשר גילויים חדשים. המודל, באמצעות תוכניות כמו "AI for Science", משולב במערכות מתקדמות לניתוח נתונים, יצירת השערות ותכנון ניסויים, ובכך מקצר זמני מחקר של חודשים לשעות בודדות. הדבר פותח אפשרויות לגישות מחקר שלא היו ניתנות לביצוע בעבר.

קרא עוד
קלוד חושף באגים נסתרים: AI מבית אנתרופיק מאתר פגמים ב-Python
מחקר14 בינואר 2026

קלוד חושף באגים נסתרים: AI מבית אנתרופיק מאתר פגמים ב-Python

אבטחת איכות תוכנה ואיתור באגים מהווים אתגר משמעותי בפיתוח. צוות מחקר מבית אנתרופיק (Anthropic) פיתח סוכן AI המשתמש בבינה מלאכותית ובשיטת בדיקות מבוססות מאפיינים (property-based testing) כדי לזהות באופן יעיל פגמים בפרויקטים גדולים של תוכנה. הסוכן מסוגל להסיק תכונות כלליות שאמורות להיות נכונות בקוד, ובאמצעותן לגלות באגים בחבילות Python מובילות כמו NumPy, SciPy ו-Pandas. צוות המחקר אימת את הממצאים באופן ידני ומדווח עליהם למתחזקים, כשכמה מהבאגים כבר תוקנו.

קרא עוד
קלוד צולל לעולם הבריאות: אנתרופיק מרחיבה יכולות לרפואה ומדעי החיים
חדשות11 בינואר 2026

קלוד צולל לעולם הבריאות: אנתרופיק מרחיבה יכולות לרפואה ומדעי החיים

אנתרופיק (Anthropic) משיקה את "Claude for Healthcare", חבילת כלים חדשה המיועדת לספקי שירותי בריאות, ארגוני ביטוח וחברות טכנולוגיות בתחום. המודל החדש פועל על תשתית מוכנה ל-HIPAA, ומציע יכולות משופרות במיוחד עבור משימות רפואיות רגישות. בנוסף, החברה מרחיבה את כלי ה-AI שלה לתחום מדעי החיים, עם דגש על ניהול ניסויים קליניים והגשות רגולטוריות. בין החיבורים החדשים ניתן למצוא את מערכות ה-CMS, Medidata ו-ClinicalTrials.gov, המאפשרים לקלוד לשלוף מידע קריטי ולייעל תהליכים מורכבים בתעשיות אלו.

קרא עוד
אנתרופיק: כך אנו מגנים על משתמשי Claude מפני סיכונים נפשיים ו"סלחנות" מודלים
בטיחות18 בדצמבר 2025

אנתרופיק: כך אנו מגנים על משתמשי Claude מפני סיכונים נפשיים ו"סלחנות" מודלים

חברת אנתרופיק (Anthropic), מובילה בתחום בטיחות ה-AI, פרסמה עדכון מקיף על מנגנוני ההגנה שהטמיעה במודלי השפה הגדולים שלה, ובפרט ב-Claude. הדו"ח מדגיש את מאמציה של החברה להבטיח תגובות הולמות בנושאי בריאות הנפש, כמו התמודדות עם מחשבות אובדניות ופגיעה עצמית, ומאבק ב"סלחנות" (sycophancy) של המודלים. אנתרופיק מציגה שיפורים משמעותיים בביצועי המודלים החדשים שלה, Claude Opus 4.5, Sonnet 4.5 ו-Haiku 4.5, בתחומים אלו, תוך התחייבות לשקיפות ולשיתוף פעולה בתעשייה.

קרא עוד
סוכני AI חשפו פרצות באבטחת חוזים חכמים בשווי 4.6 מיליון דולר
מחקר1 בדצמבר 2025

סוכני AI חשפו פרצות באבטחת חוזים חכמים בשווי 4.6 מיליון דולר

מודלי AI מפגינים יכולות סייבר הולכות וגדלות, וכעת מחקר חדש של תוכנית MATS ו-Anthropic Fellows חושף את הפוטנציאל הכלכלי של יכולות אלו. באמצעות מדד ביצועים חדש (SCONE-bench) שכולל 405 חוזים חכמים שנפרצו בפועל, סוכני AI מתקדמים כמו Claude Opus 4.5, Claude Sonnet 4.5 ו-GPT-5 הצליחו לאתר פרצות בשווי מצטבר של 4.6 מיליון דולר בחוזים שנפרצו לאחר תאריך חיתוך הידע שלהם. ממצאים אלו, הכוללים גם חשיפת שתי פרצות Zero-Day חדשות, מדגישים את הדחיפות באימוץ פרואקטיבי של AI למטרות הגנה על מנת להקדים תוקפים פוטנציאליים.

קרא עוד
אנתרופיק חושפת: כך מודדים הטיה פוליטית במודלי Claude ומה התוצאות
בטיחות13 בנובמבר 2025

אנתרופיק חושפת: כך מודדים הטיה פוליטית במודלי Claude ומה התוצאות

חברת אנתרופיק (Anthropic), מובילה בתחום ה-AI, פרסמה עדכון מקיף על מאמציה למדוד, להפחית ולנטר הטיה פוליטית במודלי השפה הגדולים (LLM) שלה, Claude. החברה הציגה שיטת הערכה אוטומטית חדשנית בקוד פתוח, הבוחנת ניטרליות ואיזון בתגובות פוליטיות. על פי ממצאיה, מודלי Claude Sonnet 4.5 ו-Claude Opus 4.1 מפגינים איזון גבוה ואף עוקפים מודלים מתחרים כמו GPT-5 ו-Llama 4 במדדים מסוימים. המהלך נועד לקדם סטנדרטים אחידים למדידת הטיה בתעשיית ה-AI כולה, במטרה להבטיח מודלים אמינים, שקופים והוגנים לכלל המשתמשים.

קרא עוד
הצצה פנימה: עדויות ליכולת אינטרוספקציה במודלי שפה גדולים
מחקר29 באוקטובר 2025

הצצה פנימה: עדויות ליכולת אינטרוספקציה במודלי שפה גדולים

אנתרופיק (Anthropic) פרסמה מחקר חדש שבוחן את יכולתם של מודלי שפה גדולים (LLM) לבצע אינטרוספקציה – כלומר, להתבונן פנימה ולדווח על מצביהם הפנימיים. המחקר, שהתמקד במודלי Claude, חושף עדויות מפתיעות לכך שמודלים אלה מסוגלים לזהות ולבקר פעילות נוירונית פנימית, ואף לשלוט בה במידה מסוימת. למרות שהיכולת עדיין מוגבלת ולא אמינה במלואה, הממצאים מעידים על פוטנציאל משמעותי לשקיפות רבה יותר במערכות AI בעתיד, ומעלים שאלות חדשות לגבי אופיים של "מוחות" מכונה. מדובר בצעד קריטי להבנת יכולותיהם הקוגניטיביות של מודלי בינה מלאכותית ולבניית מערכות אמינות ושקופות יותר.

קרא עוד
מחקר חדש של אנתרופיק: כך ניתן 'להרעיל' מודלי שפה גדולים (LLMs) עם מעט מאוד נתונים
מחקר9 באוקטובר 2025

מחקר חדש של אנתרופיק: כך ניתן 'להרעיל' מודלי שפה גדולים (LLMs) עם מעט מאוד נתונים

מחקר משותף של אנתרופיק (Anthropic), המכון לבטיחות AI בבריטניה (UK AI Security Institute) ומכון אלן טיורינג (The Alan Turing Institute) חושף פגיעות מדאיגה במודלי שפה גדולים (LLMs): נמצא כי 250 מסמכים זדוניים בלבד מספיקים ליצירת פירצה (backdoor) במודל, ללא קשר לגודלו או לכמות הנתונים שעליהם אומן. הממצאים הללו מפריכים את ההנחה המקובלת שתוקפים צריכים לשלוט באחוז מסוים מנתוני האימון, ומצביעים על כך שדי בכמות קבועה וקטנה יחסית של נתונים כדי לפגוע במודל. על אף שהמחקר התמקד בסוג ספציפי של פירצה שמוביל לפלט חסר משמעות, הוא מדגיש כי התקפות הרעלה (data poisoning) עשויות להיות קלות יותר לביצוע ממה שחשבו בעבר, ומעודד מחקר נוסף בנושא.

קרא עוד
←1234→